IT之家 · AI
联想万全混合词元工厂发布:母本工厂落地张家口,2027 年建成 15000P 异构算力集群
联想宣布国内首个万全混合词元母本工厂落地张家口,提出“为中国智能化腾飞而奋斗”,以张家口为起点布局全国词元经济网络。万全混合词元工厂词元年产能可达 2000 万亿以上,每秒词元产出提升 5 倍,良品率超 99.9%,百万词元综合成本优化 70%,PUE 控制在 1.1 以内。2027 年建成 15000P 异构算力集群、约 100MW 智算中心。
IT之家 · AI联想宣布国内首个万全混合词元母本工厂落地张家口,提出“为中国智能化腾飞而奋斗”,以张家口为起点布局全国词元经济网络。万全混合词元工厂词元年产能可达 2000 万亿以上,每秒词元产出提升 5 倍,良品率超 99.9%,百万词元综合成本优化 70%,PUE 控制在 1.1 以内。2027 年建成 15000P 异构算力集群、约 100MW 智算中心。
 Simon Willison6565
Claude Code 构建了 Beep Locator 软件,通过多设备三角定位法探测房间内间歇性响声的来源,设备间通过播放声音互相定位,最终将响声定位在约 40cm 范围内,帮助用户找到响声源头。该系统运行 Python Web 应用服务器,利用 WebSockets 协议连接设备,设备通过麦克风录制 60 秒音频并检测响声,通过播放特定声音进行时间差测量实现定位。
IT之家 · AI同一件事 · 2 家苹果开始为部分 Apple Intelligence 功能推出付费“智能使用包”,首个落地产品 Logic Pro 售价 49.99 美元,有效期 12 个月,未用完的额外用量可逐月结转。该使用包不支持“家人共享”,仅限购买时所使用的 iCloud Apple 账户使用。
 Browser Use
1Password 通过服务账户与 Browser Use 连接,可自动填充密码和 TOTP 代码完成网页任务。创建专用密码库并配置服务账户的只读权限,使用 Browser Use 令牌连接后,运行登录任务可验证认证页面。集成需为每个项目配置一个活跃的 1Password 连接,并区分服务账户令牌、库 ID 和 Browser Use API 密钥。
 OpenAI News
CodeRabbit使用OpenAI模型治理和信任AI生成代码,结合Codex将工程团队的软件交付量提升20倍。
 The Verge · AI同一件事 · 2 家6565
Apple 为 Logic Pro 提供 $49.99 一次性购买选项以扩展 AI 功能使用量,该功能允许用户继续使用因依赖 OpenAI 或 Google Gemini 云端 AI 模型而有限制的 Apple Intelligence 特性。
 Hugging Face Daily Papers
Confucius4-R2T2 是一个用于实时应用的稳定前缀流式语音识别模型,通过后训练将全上下文 ASR 模型转换为流式模型,无需架构修改。基于 Qwen3-ASR-1.7B 构建,R2T2 实现了近离线识别精度和低发射延迟,支持可配置的流式块大小,并展现出有前景的跨语言泛化能力。该模型和实现已公开发布。
 Google Developers Blog5858
Google Cloud 发布 MaxText v0.2.4,支持在 TPU 上进行长上下文训练,通过 MaxText Context Parallelism 技术,在 TPU 5p 上使 Llama 3.1 8B 模型达到 4 百万 token 长度的序列 70% 的 MFU,在 TPU 5p 和 TPU 7 上可无缝扩展至 14 百万 token
 NVIDIA Technical Blog6565
NVIDIA Holoscan 5 通过持续计算逆动力学实现重力补偿,使机器人手臂在操作时仅需提供支撑重量的扭矩。该技术支持通过示教学习、物体操作或人机协作的机器人应用,依赖重力补偿回路构建。
 MarkTechPost6767
百度发布 ERNIE Evolve 自动化研究系统,通过给定代码库、目标和评估标准自动选择研究方向、编辑代码并运行实验,仅保留通过隐藏评估器和独立审查者验证的更改。
MarkTechPost同一件事 · 4 家6767Google 发布 TPU 8i Max 和 TPU 8tx,TPU 8i Max 将 2 个 TPU 8i 芯片整合为 1 个包装,性能翻倍;TPU 8tx 采用 TPU 8t 芯片搭配第 5 代 AMD EPYC 主机,实现机密推理,延迟降低 2 倍。
各家口径不同:MarkTechPost 表示 TPU 8tx 使用 TPU 8t 芯片搭配第 5 代 AMD EPYC,而 TechCrunch 提到它是与 AMD 合作开发,专为机密训练和运行 AI 模型设计,硬件层直接集成安全功能。
 Databricks Blog2222
Sendoso 通过 Genie One AI 代理将购买信号转化为销售管道,无需导出列表或登录其他工具。Databricks Marketplace 上的 MCP 服务器使 Sendoso 功能集成到现有数据环境中,AI 建议礼品、研究收件人和起草便条,支持在 Genie One 中直接与数据显示和原因并置。
Databricks Blog4040Databricks 发布 Unity Catalog Dataset (UCDataset) Beta 版本,通过直接从云存储流式传输 Unity Catalog 表格数据到训练作业中的每个 GPU,将推荐模型工作负载的训练时间平均缩短 10 倍。
 量子位精选7272
百度文心首次披露自动研究系统 ERNIE Evolve,该系统可自主提出研究方向、开展实验并验证结果,已用于文心 5.5 Flash 的推理优化。在昆仑芯 P800 低时延场景优化中,ERNIE Evolve 历时约 168 小时、经过 4 轮方向探索,最优版本生成速度提升至基线的 623.6%;确定性推理吞吐优化用 3 天将吞吐提升至基线的 133.7%。
推荐理由: 百度公开了自动研究系统 ERNIE Evolve 的架构与生产环境优化数据,可观察 RSI 在推理优化上的实际落点。
 NVIDIA Newsroom精选7878
NVIDIA 在 CoRL 上发布开源世界动作模型 GR00T 2,基于 NVIDIA Cosmos 构建,使用 10 万小时 NVIDIA 开源人类第一视角数据训练,可在无任务专属演示的情况下完成 50 项评测任务中的 40 项。
推荐理由: 原文给出 GR00T 2 在少样本任务上的成功率与 Isaac Lab 3.0 的训练吞吐提升,可据此判断仿真训练对机器人落地的推进程度。
IT之家 · AI精选8282美团龙猫将面向长程智能体任务的原生多模态模型 LongCat-2.5 正式开源,采用 MIT 协议,支持商用推理部署与二次训练且无需额外授权。模型总参数 1.6 万亿,每个 token 激活约 480 亿参数,支持一百万上下文,并针对显存与带宽受限的国产算力芯片在架构、芯片适配与部署策略上做了协同优化。
推荐理由: 原文给出总参数、激活参数、上下文长度与开源协议,读者可据此判断长程智能体任务的开源模型选项。
 The Decoder同一件事 · 4 家5858
Google 发布 TPU 8tx 和 TPU 8i Max 两种新系统,分别面向机密计算和高内存需求应用,年内共交付四种 TPU 系统。新系统基于现有芯片,通过不同封装、网络和内存配置实现快速迭代。TPU 8tx 数据在处理时保持加密,TPU 8i Max 在单机架内将计算能力、内存和带宽翻倍,每平方米数据中心空间性能显著提升。
各家口径不同:MarkTechPost 表示 TPU 8tx 使用 TPU 8t 芯片搭配第 5 代 AMD EPYC,而 TechCrunch 提到它是与 AMD 合作开发,专为机密训练和运行 AI 模型设计,硬件层直接集成安全功能。
IT之家 · AI6565大疆 Osmo Pocket 4P 固件更新至 V01.02.11.49,新增 18 倍变焦(不支持慢动作、延时摄影)、舞台与日落场景预设、iPhone 即拍即传(支持 iOS 26.4.1 及以上)及 LivePhoto AI 生成功能。
IT之家 · AI同一件事 · 4 家6767谷歌推出 TPU 8tx 和 TPU 8i Max 两款新品,分别针对机密计算和超长上下文窗口 AI 应用,旨在挑战英伟达在 AI 芯片市场的地位。TPU 8tx 与 AMD 芯片协同工作,TPU 8i Max 集成两颗芯片提供更强计算能力,两款产品预计明年上市。
各家口径不同:MarkTechPost 表示 TPU 8tx 使用 TPU 8t 芯片搭配第 5 代 AMD EPYC,而 TechCrunch 提到它是与 AMD 合作开发,专为机密训练和运行 AI 模型设计,硬件层直接集成安全功能。
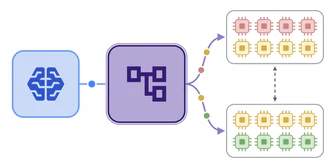
Google Developers Blog精选6565Google 宣布 Pathways 在 Google Cloud Platform 上正式可用(General Availability),这是 Google 用来训练 Gemini 等自家大模型的分布式系统。
推荐理由: Google 工程师解释 Pathways 的单控制器执行模型,并给出它与 Ray 的分层差异,便于判断大规模训练编排的选型。
MarkTechPost5858Reason Machines 发布开源 Git 服务器 Aspen,专为处理数百个 AI 智能体同时推送的仓库设计,独立实现 OpenAI Pando 的设计,单 8 核服务器持续 567 推送/秒,p99 推送延迟 314 毫秒。
IT之家 · AI6565三星准备对 Bixby 进行大幅升级,让语音助手进一步变成能够代用户处理订酒店、预约等日常事务的个人 AI 智能体。用户只需向 Bixby 提出定期执行某项任务的要求,Bixby 便会理解指令并设置相应操作,等待用户确认。该功能有望在明年初随 Galaxy S27 系列推出,但现有 Galaxy 手机能否通过更新获得尚不确定。
IT之家 · AI6565铭凡推出 T5 Max-388 紧凑型台式机,搭载 AMD 锐龙 AI Max+ 388 处理器,配备板载 48GB LPDDR5-6400 内存,采用相变 TIM + 6 风扇散热系统,提供 2 个 M.2 2280 (PCIe Gen4 ×4) 接口和 1TB 存储,到手价为 1,559 美元 / 11,999 港币。
量子位精选7272量子位作者用 LobeHub 组建 AI 编辑部实测:主管 Agent Sienna 在不到 8 分钟内分派三位小编产出 6 条选题简报,随后自行新建网页开发和 QA 两个 Worker,沿用上一轮成果在约 30 分钟内做出可筛选的资讯看板。
推荐理由: 作者用两轮实测展示主管 Agent 如何派活、临时招人并接力交付,可观察多 Agent 协作的实际边界。
 Hacker News · AI 热帖6565
使用 Claude Code 或 Codex 从终端工作时,用户常因任务多线程处理导致脑力耗竭。作者通过将工作组织成类似优先队列的方式,在 git 中管理任务,每项任务为 markdown 文件,状态为 git 快照。AI 智能体按循环处理新任务、运行测试和浏览器检查,但无法做决策,需用户在“所有者收件箱”中处理,并通过 Claude 工具单页查看任务,完成后再关闭,实现一次处理一项任务。
NVIDIA Newsroom3232NVIDIA 发布针对韩国领先开源模型的 Dynamo 优化部署方案,支持 SK Telecom A.X K2、LG AI Research K-EXAONE 2.0、Upstage Solar Open 2 和 Motif Technologies Motif-3,通过优化多 GPU 协调和通信实现高达 2 倍性能提升,加速模型生产化部署。
llama-modchip 发布了一组 ggml/llama.cpp 内核补丁与量化转码工具,将 284.33B 的 DeepSeek-V4-Flash 压缩到 56.56 GiB(1.71 bpw),可在 64 GB 内存的纯 CPU 机器上运行,256K 上下文下峰值内存 57.61 GiB 且无需 swap。
推荐理由: 项目给出了在 64 GB 内存上运行 284B MoE 的量化方案与内核补丁,并附各硬件实测数据,可据此判断纯 CPU 部署的可行边界。
MarkTechPost6262Google AI 开源 Elephant-Goldfish 模型(EGM)插件,让 AI 编码智能体先写规范再写代码。该插件包含 7 项技能、9 种审阅者角色和 6 个头脑风暴透镜,通过 5 个零上下文审阅阶段强制独立审阅规范。
 OpenAI Agents SDK releases2222
OpenAI Agents SDK v0.24.0-alpha.7 发布,支持经典工作流与原生执行,新增语音和托管工具,引入持久会话存储和上下文控制。新版本默认执行策略为严格模式,需更新现有环境;捆绑模型默认推理力度提升至中等。
IT之家 · AI5252特斯拉第六代推理加速器 SI6 算力预计达 HW4 的 80 倍,内存容量为 144GB,采用 2nm 级制程工艺;Dojo D3 放弃晶圆级集成,转向多芯粒设计并搭载堆叠式 HBM 内存,将面向太空部署。
量子位精选7272AI写代码速度加快导致GitHub多次故障,OpenAI拟收购代码托管工具Pierre,并已公开内部Git后端Pando,一次推送的中位耗时降了近八成。Anthropic因日均合并改动从5月约2500项增至9月超3万项,由7名工程师用5个月自研版本控制系统Scion并迁移主代码库;Cursor则推出代码托管服务Origin,允许开发者在Cursor内完成提交、审查与合并。
推荐理由: 从GitHub故障切入,串起OpenAI、Cursor、Anthropic自建代码基础设施的动因与做法,可看清AI写代码对开发工具链的实际压力。
 vLLM Blog3838
vLLM 自 v0.33.0 起 发布 LibTorch ABI Stable CUDA 轮,无需重建即可升级 PyTorch。
Jev 和 Luna 模型在身份解析结果评分上表现尚可(88.8–97.3% 准确率),但 Jev+Opus 混合模型达到前沿准确率的同时成本降低 4 倍。Luna 初始表现优于 Jev,但在复杂案例中差距消失;Jev 的置信度校准更佳,其错误多伴随低置信度,而 Luna 错误多伴随高置信度。
量子位4242Personal Agent 以用户为中心,需支持长时间运行和主动推进,因此必须配备专属“云电脑”。目前主流方案包括本地运行(存在安全风险和离线问题)和云端运行(大厂自建或第三方托管)。PPIO 沙箱提供即开即用、安全隔离、支持长时间运行和大规模用户的云端执行环境,作为 API 供开发者使用,助力开发个人办公、研究及编程助理等场景的 Agent。
IT之家 · AI5858Planet AI 应用推出,用户可通过自然语言搜索、观察和分析地球表面十年影像变化;目前免费使用,AI 结论基于可查看的原始卫星影像;支持“搜索地球”、“探究变化”、“深度分析”三大核心能力,已用于生态保护、土地管理等。
IT之家 · AI6262Amp 推出 Spaces 功能,用户对话主 Agent 即可自动生成和协调多个并行 Agent 线程完成项目。每个 Space 支持团队在单一聊天中规划、执行和追踪任务,主 Agent 负责目标拆解与进度组织,开发者只需定义目标、审查结果。
IT之家 · AI同一件事 · 2 家6060Cursor 今日推出“与智能体实时语音聊天”功能,支持开发者通过语音与编码智能体双向对话,用于描述代码修改需求、询问任务进展等,同时智能体后台完成编码工作。该功能在 Cursor 的 Agents Window、IDE、网页端及 iOS 应用中使用,由 Grok Voice 驱动语音识别与合成,提供 Ara、Eve 等多种语音选择,并支持通话中切换。
Databricks Blog3838OpenSharing 是一个基于 Delta Lake 和 Iceberg 开发的开放协议,用于直接读取客户表而不复制数据。它支持增量拉取变更数据、实时访问最新数据以及平滑回填历史数据,同时降低客户和消费方在数据管理、存储和访问控制上的成本。消费方无需维护 SFTP 或 API 连接,客户通过授权即可共享表格,并可通过系统表追踪访问记录。
Databricks Blog2222Databricks 通过 OpenSharing 将共享 Delta 表暴露为实时数据源,接收方使用 Structured Streaming 读取增量变更,无需本地文件追踪。
 GitHub Blog · AI & ML3838
GitHub Copilot 在 canvases 上支持跨设备会话连续性,让用户在云沙箱中执行任务,通过 Copilot 应用隔离仓库编辑,用存储指令和共享记忆的项目知识提升效率,并可选择 Copilot Fusion 模型匹配工作需求。