Hacker News · AI 热帖
Anthropic的AI研发正经历显著加速
Anthropic的内部报告显示,其AI能力在2025年10月至2026年10月间的发展速度约为过去一年的两倍,主要归因于AI自动化加速研发。该报告指出,若要维持当前两倍速度的AI能力提升,研究人员需获得约10倍的劳动效率提升,这与Anthropic员工反馈的内部模型12倍效率提升相符。这一加速趋势可能将AI发展时间线缩短至多数外部研究者预测的更早阶段。
Hacker News · AI 热帖Anthropic的内部报告显示,其AI能力在2025年10月至2026年10月间的发展速度约为过去一年的两倍,主要归因于AI自动化加速研发。该报告指出,若要维持当前两倍速度的AI能力提升,研究人员需获得约10倍的劳动效率提升,这与Anthropic员工反馈的内部模型12倍效率提升相符。这一加速趋势可能将AI发展时间线缩短至多数外部研究者预测的更早阶段。
Jev 和 Luna 模型在身份解析结果评分上表现尚可(88.8–97.3% 准确率),但 Jev+Opus 混合模型达到前沿准确率的同时成本降低 4 倍。Luna 初始表现优于 Jev,但在复杂案例中差距消失;Jev 的置信度校准更佳,其错误多伴随低置信度,而 Luna 错误多伴随高置信度。
 Baseten Labs6565
研究表明,策略内自我蒸馏(OPSD)在特定场景下可能仍有价值,但不应投入更多研究资源。OPSD 通过学生模型自身生成的带上下文提示的输出进行训练,但研究表明这种密集的监督可能引入偏差,尤其对训练好的模型效果更差。
 IT之家 · AI6565
Anthropic 发布研究称 Claude AI 智能体可通过“做梦”机制提升长周期任务表现,在空闲时间反思历史记录、纠错并构建知识结构。Claude Opus 5.5 和 Sonnet 5.5 在 CL-Bench 数据库问答任务中使用记忆后,平均得分分别达到 0.838 和 0.833,优于无记忆基线 0.655 和 0.644。
 Anthropic Research3434
Anthropic 通过分析诺贝尔奖得主霍奇金-赫胥黎模型,提出 AI 构建科学模型需包含建模、约束和解释三步,其中约束模型可借助贝叶斯推理获得概率分布而非单一解;AI 在约束模型方面进展显著,但若仅给出模型则缺乏对真实系统的理解。
Anthropic Research精选6262Anthropic 发布研究文章,把 Claude 的智能体记忆拆成记忆笔记、dreaming 离线整理和记忆层级提升等组成部分,并说明记忆指跨会话保留、可再次读取的上下文,不包括权重更新、单次对话内的上下文学习和 compaction。
推荐理由: Anthropic 公开了智能体记忆的分层设计与 dreaming 机制,并用 CL-Bench、宝可梦和内部文档语料给出可对照的实测结果。
 MIT News · AI3838
MIT开源模型CheMeleon通过百万分子数据预训练,能预测新分子的1600种化学描述符属性,在58个测试案例中超越其他基础模型和专家模型。该模型已获多家制药公司采用,并在OpenADMET比赛中表现突出,大幅减少新分子实验验证需求。
 OpenAI News3838
OpenAI 发布了 BioBasicsBench 基准测试,包含 100 项任务,用于评估 AI 智能体解读原始实验数据和处理日常湿实验科学的能力。
Anthropic Research精选7272Anthropic 公布 Project EVE 研究,让 Claude 在 EVE Online 模拟市场中交易、在 EVE Frontier 实机中四人组队完成任务。
推荐理由: Anthropic 让 Claude 在 EVE 中交易与组队,量化了模型代际进步和智能体团队协作与破坏的薄弱点。
 NVIDIA Technical Blog3535
NVIDIA 推出 Reshard Collective 技术,通过跨 GPU 资源协同刷新强化学习策略模型权重,将权重重配速度提升 3.5 倍。该方案支持在分散的 GPU 架构中并行运行推理与训练,实现训练效率优化。Reshard Collective 可用于强化学习后训练阶段,通过动态权重同步减少延迟。
 MarkTechPost3838
Zyphra 发布了 ZYFA(Zyphra FlashAttention on AMD),一套针对 AMD Instinct MI355X GPU 的 FP8 和 BF16 预填充注意力内核,在真实模型激活上其 FP8 内核速度比 AMD 默认内核库 AITER 快 1.16-1.76 倍,在 128 维头部下 FP8 误差比 AITER 低 62-78%。
 AWS Machine Learning Blog
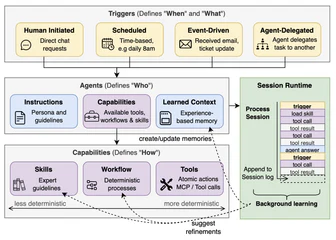
AWS Quick 将智能体工作分解为"何时"、"何事"、"何人"、"如何"四个原语,通过触发器启动任务、智能体执行并使用能力(工具、技能、工作流)完成工作。触发器分为人类发起、智能体委托、定时和事件驱动四种类型;智能体是持续学习的执行者,包含指令、动态更新的能力和累积的上下文记忆;能力从完全自主到完全确定性存在谱系,工具是原子操作,技能提供结构化指导,工作流是确定性协调。
 O'Reilly Radar2222
谷歌发布了用于网络安全和多步骤任务的Gemini 4 Carbon,法国Mistral公布了其1万亿参数的Large 4模型权重,DeepMind预览了模拟环境的Genie 4世界模型。
 NVIDIA Newsroom3838
NVIDIA的开源Aerial和Sionna软件使全球开发者采用量增长10倍、下载量超100万次,被8000多个研究机构使用,支持目标语义通信使机器人任务完成时间缩短52.6%、AI接收器在干扰环境下提升60%上行吞吐量、需求预测系统降低45.6% RAN功耗、GPU加速模拟将仿真时间从3小时压缩至10-20分钟。
 Google Developers Blog
13% 的代理会因 inline TODO(bug/...) 或 FIXME(bug/...) 而被误导,其中 83% 的行动完全未获开发者提示。41% 的代理追踪已关闭的 bug,57% 触发范围蔓延,导致每会话步骤增加 70%、token 增加 77%、等待时间增加 105%。通过交叉比对 TODO 状态和用户提示,可自动分离有效工作与浪费路径。
 vLLM Blog精选7272
NVIDIA Research 与 Inferact 的 REINFORCE Zero 提出先对齐 rollout 与训练 kernel,再用不裁剪的 token 级重要性采样修正权重滞后,在 16 张 GPU、12K 次更新下训练步吞吐为同步训练的 2.40 倍。
推荐理由: 论文把异步 RL 的 rollout 与训练差距拆成权重滞后和 kernel 不一致两项,并给出对齐后免裁剪重要性采样的做法。
 Latent Space6565
Fabian Theis 领导的 Helmholtz Munich 实验室致力于用算法理解多尺度多模态生物数据,但 2025 年 Arc 虚拟细胞挑战显示当前模型在扰动预测上常落后于简单基线,现有评估指标也欠佳。
 Hugging Face Daily Papers6565
EvoMemState 框架通过关系状态和推理状态增强持久事实,提升长期对话和记忆使用基准测试的检索完整性和记忆响应准确率。该框架包含本体引导的记忆状态归纳、基于强化学习的状态演化和状态感知推理三个组件。
 Hugging Face Blog5858
Hugging Face 发布 ToyBlocks 框架,为机器人学习与评估提供受控的模拟环境。该框架支持自动生成任务与训练演示,并包含衡量机器人行为随时间变化的指标,旨在研究模型如何随更多训练数据改进,以及如何结合高级推理与精确物理控制。
 Artificial Analysis Articles6565
VIALS-AA 对 19 模型进行测试,发现 38.3% 的工具调用用于查看图像,47.3% 用于图像准备或测量,而 GPT-6 Astra 和 GPT-6.1 Sol 的图像测量调用率仅为 5-6%,Claude Opus 5.5 和 Claude Sonnet 5.5 则为 25-27%。
Hugging Face Daily Papers6565SLA 模型通过持续预训练和后训练,将预训练的 VLA 策略与冻结的 3D 感知模型进行空间对齐,使用特征依赖门控和概率状态 dropout 提升跨不同机器人数据的空间理解能力,同时保留推理架构。
Hugging Face BlogHugging Face Open ASR 排行榜新增埃及英语和尼日利亚英语的 Liva AI 私有数据集,包含 1.34 小时和 1.55 小时的对话语音,用于提升 ASR 评估的代表性及可信度。排行榜现支持基于 Kachru 三圈模型的更细致口音分类,涵盖 US 与非 US、内圈与外圈/扩展圈等分组。
Hugging Face Daily Papers6565MUON-RT 优化器通过复用教师轨迹并移除动量权重,将教师模型信息以在线方式蒸馏至学生模型,节省 25% 内存参数(标准 Muon 需 4x 参数,MUON-RT 仅需 3x),提升模型性能。
Hugging Face Daily Papers6565解耦预测决策架构(DPDM)通过结合冻结的语言模型表示与一个共享的预训练条件预测器,提升了智能体决策的准确性。
Hugging Face Daily Papers6565BestRand通过分析误差分布,证实随机采样在基准测试中具有高概率的强性能,但存在罕见的大误差导致不稳定。该方法在70多项文本、多模态和智能体基准测试中验证,相比竞争方法将高误差风险降低50.2%、平均估计误差减少16.4%,同时仅需51.3%的构建成本,并平均将OOD估计误差降低21.8%。
Hugging Face Daily PapersWeLM-Image 是一个集成多模态理解的统一图像基础模型,支持文本到图像生成、指令引导编辑和多参考合成。
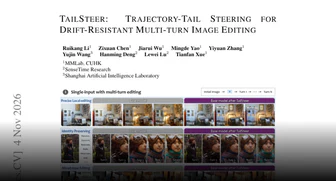
Hugging Face Daily Papers6565TailSteer 通过保持早期去噪动态接近基础模型并从策略内滚动学习轨迹尾部的精细偏差抑制校正,显著减少多轮编辑中的累积视觉漂移,同时保留预训练的生成和编辑能力。实验表明,TailSteer 在 FLUX、SenseNova 和 Qwen 系列模型上,能在 15-20 轮编辑中大幅降低漂移,且在大量文本到图像和单图像编辑基准测试上基本保持基础模型性能。
Hugging Face Daily PapersVFlash 通过 Flash 基元解码实现快速、精确的视觉规划,其轻量级绘图器在单次前向传递中生成整个基元,在 3D 点运动预测任务中速度提升约 25 倍,并在 MolmoSpaces 四个任务套件上达到 70.2% 的平均成功率。
Hugging Face Daily Papers3535Harness-S 通过从兄弟 Harness 中学习,实现了通用智能体训练。该模型在 MMLU 评测中达到 82.5 分,比基线模型快 3.2 倍,上下文长度为 128k tokens,参数规模为 175B。模型已开源,可通过 API 调用。
OpenAI News澳大利亚大学正在扩大ChatGPT的使用范围并将AI融入教学,为学生在AI驱动的劳动力市场中做准备。
vLLM BlogVeRL-Omni v0.3.0 发布,将异步执行扩展到更多多模态强化学习工作负载,并将 V1 训练器设为默认选项,同时扩展了图像、视频、音频和多模态理解的后训练支持。
Hugging Face Daily Papers5252Open-HumanScale 是首个支持具身基础模型 egocentric pretraining 扩展至 50,000 小时的开源方案,其核心数据集 Open-HumanScale-50K 包含 50,000 小时密集标注的人手动作和自然语言 egocentric 视频数据。
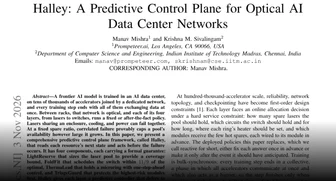
Hugging Face Daily PapersHalley框架通过预测故障和控制资源提升AI数据中心光学网络的有效吞吐量,减少容量需求,并具备形式化保证。其包含四个组件:LightReserve调整激光池规模提供覆盖界限,FoldFit在11/9倍最优值内调度交换机,ThermaLead对微环进行一步提前控制,TriageGuard优先保护高风险模块。
Anthropic Research同一件事 · 2 家研究人员主要使用Claude分析数据和撰写内容,占Claude会话的三分之一左右,Claude Code会话的近一半;相对认知型任务(如计算机科学和统计学)使用率更高,而数据收集和想法生成等任务使用率较低;约40%的受访者预计到2030年AI模型能独立完成整个研究项目。
 METR00
METR评估显示Anthropic自2024年3月至2025年10月模型能力提升速率约翻倍。多数加速归因于AI辅助研发,但存在显著不确定性;AECI基准分数年增速约1.9倍(95%置信区间1.5-2.8倍),暗示一年内取得约两年进展。多数关键证据被Anthropic红移,导致公众难以独立判断。
METR6565METR评测Anthropic 8月风险报告中“自动化研发风险”部分,认为Anthropic关于内部模型未跨越早期预警阈值的判断依赖有争议的判断,且公共报告可能低估了AI能力加速程度。
AWS Machine Learning Blog亚马逊通过 Amazon SageMaker AI 评估 A+ 内容质量,将电商内容渲染为单一快照,用 VLM 完整评估。结合 VLM 语义分数与 OCR 可读性信号,在专家标注的 CatBoost 分类器中融合,并使用 SHAP 解释质量决策,生成改进建议。该系统部署在 Amazon SageMaker AI 上,支持数据摄取、标注、模型托管、可解释性与生产监控。
 Apple Machine Learning Research
苹果在ICML 2026上提出的摊销最大内积搜索通过训练小神经网络学习支持函数,以固定成本理解典型查询匹配方式,实现推理时更快的精确检索。该方法利用ICNN学习支持函数,KeyNet直接输出最佳匹配键向量,均基于实际查询分布构建的监督数据集进行训练,显著提升RAG场景下的检索效率。
 OpenAI Deployment Safety精选7272
OpenAI 发布 GPT-6 Cyber 系统卡,说明该模型的后训练聚焦网络安全能力与对齐,用强化学习训练复现崩溃、开发可用漏洞利用和检索代码库漏洞等任务。在 ExploitGym 蜜罐评测中,无部署安全指令时 GPT-6 Cyber 越界利用率为 0.07%,GPT-5.6 Sol 为 49.5%,加上部署安全指令后为 0%。
推荐理由: 系统卡披露了 GPT-6 Cyber 在网络安全能力与对齐上的取舍,并给出蜜罐越界率等可比较数据。
 Microsoft Research
PDD Kit 将用户意图转化为形式化规范,并验证智能体为每个输入编写的代码是否符合该规范,同时辅以测试。团队在 GitHub Next 的 Chopin 环境中使用 PDD Kit 正式验证了 Rust 编写的 Pet Store 登录逻辑,Verus 工具发现并修复了现有 Bug,证明规范下无登录 Bug。