Ars Technica · AI同一件事 · 5 家6565
Google 发布了 Gemini 4 Carbon:一款无法立即使用的最新前沿 AI 模型
Google 发布了 Gemini 4 Carbon,在编码、智能体任务和科学分析方面达到了新的阈值,但尚未开放使用。该模型在网络安全应用中显著提升了漏洞检测、验证和修复能力,生成无漏洞代码的概率是 Argon 的两倍,生成高质量补丁的能力是非 Google 模型的 10 倍。
Ars Technica · AI同一件事 · 5 家6565Google 发布了 Gemini 4 Carbon,在编码、智能体任务和科学分析方面达到了新的阈值,但尚未开放使用。该模型在网络安全应用中显著提升了漏洞检测、验证和修复能力,生成无漏洞代码的概率是 Argon 的两倍,生成高质量补丁的能力是非 Google 模型的 10 倍。
 Artificial Analysis Articles精选同一件事 · 5 家8585
Google 的 Gemini 4 Carbon 在 Artificial Analysis Intelligence Index v5 上以 59 分排名第一,在 9 项评测中的 HLE-Diamond、Terminal-Bench-Science、AA-Omniscience、AutomationBench-AA 四项居首
 Google DeepMind精选同一件事 · 5 家8282
Google DeepMind 发布 Gemini 4 Carbon,称其在网络安全与长周期任务上能力最强,在 Artificial Analysis Intelligence Index v5.0 上以 59 分排名第一
Artificial Analysis Articles精选7272Artificial Analysis 在 Coding Agent Index v2.0 中实测 GitHub Copilot CLI 的 Copilot Fusion 最高档设置,其单任务成本为 5.59 美元,而 Claude Code 配合 Opus 5.5(max)为 11.42 美元,综合得分仅低 2 分。
推荐理由: Artificial Analysis 使用 Coding Agent Index 实测 Copilot Fusion,给出与 Claude Code 同等性能下的成本与 token 对比。
 Hugging Face Daily Papers
SPOT 通过预测 token 生成顺序并行验证候选,将扩散语言模型的遍历次数减少高达 6.8 倍,同时保持精确解码。该 0.62M 参数模型读取目标输出分布,预测顺序并提出候选树,目标模型通过状态等式在单次遍历中验证。SPOT 在 SDAR-8B 上将目标遍历次数减少至标准解码的 1/6.8,吞吐量提升 3.4 倍,并在所有任务和预算下超越校准无训练基线。
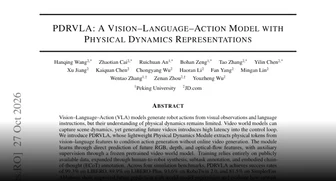
Hugging Face Daily PapersPDRVLA通过集成轻量级物理动态模块改进机器人行动生成,该模块在物理世界模型监督下预测未来视觉特征,避免在线视频生成带来的延迟。PDRVLA在四个模拟基准上取得99.3%(LIBERO)、89.9%(LIBERO-Plus)、93.6%(RoboTwin~2.0)和81.5%(SimplerEnv)的成功率。
Hugging Face Daily Papers6565CodeCap-Bench 通过比较代码字幕与自然语言字幕在视频问答和重建任务上的表现,证明代码字幕具有更优的推理准确性和重建保真度。该基准包含 323 个结构化 2D 内容视频,涵盖五个类别,评估发现主流闭源 MLLM 在代码字幕生成上虽表现良好,但难以捕捉复杂时序动态,开源模型差距显著。
Hugging Face Daily Papers6565Redistribution sensitivity score (RSS) 识别在 27 个预训练 SAE 模型(覆盖 8 个语言模型)上产生可重复特征重新分配模式的特征响应,结合 clean margin 可量化其对下游读出的贡献。
Ars Technica · AI6565Pinal 可通过自然语言提示生成蛋白质,成功率达特定功能要求;Hugging Face 同步推出 DNA 级别类似工具。Pinal 采用 T2struct 将提示转为结构蓝本,再由 SAProt-T 结合概率评估生成序列,基于三大数据库及 AlphaFold 预测训练。
Hugging Face Daily PapersQwen-Image-PE 通过两阶段训练(基于标题的逆向蒸馏和分组设计奖励)提升文本到图像提示增强能力,在 Qwen-Image-Bench 上使用 Qwen-Image-2.1 时,Qwen-Image-PE-397B 相比原始请求提升 7.81 分,Qwen-Image-PE-9B 超越所有评估的 PE 基线。
 Databricks Blog
Databricks 通过构建包含评审环节的文档提取流程,使用 ai_extract 结合 JSON schema 和全局指令提升准确率,并借助 MLflow Prompt Registry 版本化配置,最终在固定人工标注数据集上验证改进效果,使系统整体性能得到提升。
 MarkTechPost6565
Mirendil 发布了其首款 AI 模型 Fern 0.1,支持高达 10M-Token 的上下文窗口,约等于 23 MB 代码或 50 万行,首次实现 Megatron-LM 级别代码库的完整加载。
 IBM Research Blog
IBM 与 Kaggle 合作推出 Java 框架迁移基准 ScarfBench,评估 AI 代理迁移企业 Java 应用的能力。在 204 个迁移任务中,Gemini 4 Argon 配合 Antigravity 排名第一(烟雾测试 75.2%),Claude Opus 5.5 配合 Claude Code 排名第二(全部通过率 72.1%)。
Hugging Face Daily Papers提出统一框架整合基础模型与运行时组件以可靠执行复杂数字任务,引入工作持久性与开放性维度,并识别五类核心能力及优化方法。
 The Decoder
OpenAI 发布 GPT-6.1 Terra,将成本性能边界推向新高度,API 价格较 GPT-5.6 Terra 减半至百万输入 token 1 美元、输出 token 5 美元。
 Exponential View6565
Claude Code v2.1.159 发布,Anthropic 26% AI 研发由 Claude 领导并有人监督;Sakana AI 和 Gemini 驱动的 AlphaEvolve 代码智能体分别提升 SWE-bench 和 Polyglot 30pp/15pp,MiniMax M2.7 模型智能体迭代提升 30%。
 The Verge · AI5858
OpenAI GPT-6.1 Sol 在将 COBOL 代码迁移到现代语言(C++、Java、Kotlin、Python、Rust)时,低推理努力下行为保留准确率达 87%,高推理努力下达 98%。Anthropic 的 Claude Code 也被用于 COBOL 代码迁移,但未提供性能基准。专家认为 AI 工具在处理遗留代码方面取得进展,但距离安全替换关键遗留系统仍很远。OpenAI GPT-6.1 Sol 在迁移 COBOL 代码到现代语言方面取得显著进展。
 IT之家 · AI6060
即梦 AI 短剧工作室上线,提供自研剧本模型 DreamScript(支持多题材生成、爆款诊断、10 万字长篇解析)、图片模型 Anycook(支持差异化人物设定、多风格场景搭建)和分镜模型 DreamShot(双模式创作、3D 导演台动态预演)。
Hugging Face Daily Papers4949RSIHub 是一个开源框架,通过提供可重用组件和一致评估的标准基础设施,规范智能体进化研究,用于构建、比较和扩展相关方法。研究人员可专注于进化策略,而评估保持在外部,结果与候选者和评估条件相关联。
MarkTechPost6060纳米冰(Nanbeige)发布了 33B 参数的密态大语言模型 Nanbeige4.3-33B,支持 524,288 个 token 的上下文窗口,在 20 项基准测试中领先 17 项,包括在 Terminal-Bench 2.1 上取得 80.9 分,但 SWE-Bench Pro 表现落后于 Qwen3.8-27B。
MarkTechPost5252斯坦福和伯克利研究者推出 TokenGate 模块,通过学习型 token 剪枝技术,使长上下文预填充速度提升 1.4 至 11.3 倍且不损失精度,峰值预填充内存消耗降低 1.5 至 3.4 倍,在 5 项任务上优于 6 个基线模型,最佳表现时 NIAH 16k 任务速度提升 11.3 倍、内存降低 3.42 倍,代码和检查点已开源。
MarkTechPost6060Cognition 发布了免费的、开源的 Devin Vulnerability Fixes 插件,包含三个技能用于修复 PHP2Shell、Node.js 和 GitLab CVE-2026-110264 三个关键远程代码执行 (RCE) 漏洞。
The Decoder6565研究表明,不同编码智能体框架间的性能差距在统计噪声范围内,而切换框架的效果与重新运行相同设置相当。Claude Code、OpenCode 和 mini-SWE-agent 三种框架每模型消耗的 token 数增加两到三倍,但通过率仍在测量不确定性范围内。OpenCode 在大型任务集中存在统计显著的落后,主要因输出限制和更短的运行时间限制,而其他框架的系统提示词和工具描述是成本差异的主要来源。
MarkTechPost同新闻8383Moonshot AI 发布了 K3.1 系列首个模型 Kimi K3.1 Pro,采用 MoE 架构,总参数 2.8T、激活参数 104B,支持 1M token 上下文,已在 Kimi.ai、Kimi Work、Kimi Code 和 Kimi API 上线,API 定价为每百万 token 输入 2 美元、输出 10 美元,低于 K3 的 3 美元和 15 美元。
同一新闻,精选展示《Kimi K3.1 Pro 发布,智能指数 55 分位列第四》
The Decoder精选8585月之暗面发布 Kimi K3.1 Pro,这是 Kimi K3 的后训练版本,在 Artificial Analysis 智能指数上得分 55,比 K3 提升 11 分,排名第四,仅次于 Claude Opus 5.5(58)、Claude Sonnet 5.5(56)和 Muse Wonder Full(56)。
推荐理由: 文章用第三方指数和多项基准对比,呈现开源权重模型与闭源前沿模型之间差距缩小的具体幅度。
Hugging Face Daily PapersFRED框架通过自蒸馏和时序条件提升世界行动模型的未来视频表示能力,在真实世界操作场景中持续优于竞争模型,在长时程和域外任务上实现零样本泛化的大幅增益,将人类视频技能迁移成功率从19.4%提升至50.0%。
 Hugging Face Blog
LitPivot帮助研究人员通过阅读先前文献来调整研究方向,将研究想法分为问题、贡献和评估计划,并为每个部分提供基于文献的批评和修订建议。在涉及17名研究人员的实验室研究中,领域专家评价新颖想法的文献基础比使用文本编辑器和AI聊天工具开发的想法更好,参与者也报告了更强的文献理解和对想法新颖性和实用性的提升。
The Decoder精选8282Anthropic 的 Frontier Red Team 与 Theorem 合作,让 Claude 把 OSS-Fuzz 中 123 个开源库的崩溃测试转成数学问题,几周内生成约 1.8 亿行证明代码,并由 Rocq 自动校验。
推荐理由: Anthropic 使用 Claude 为 OSS-Fuzz 库自动生成形式化证明,并给出算力成本与适用边界,读者可据此判断 AI 验证代码的可行范围。
Hugging Face Daily PapersIQuest-Q1 是一个拥有 320B 总参数(15B 激活参数)的开源稀疏专家混合(MoE)智能体基础模型,通过多阶段预训练、中训练和后训练实现强大的编码和通用能力。
 腾讯混元 · Hugging Face 新模型
腾讯混元发布 WeVisOne-VL-2B 模型,基于 Qwen3-VL 构建,集成 9.5M 参数像素解码器,支持目标级感知(开放词汇目标检测、指向定位、计数、指向和 OCR)与像素级感知(指向分割和可提示 alpha 摩擦),适用于视觉定位、指向、计数、OCR 定位、指向分割和图像摩擦等研究任务。
Hugging Face Daily Papers7575LaLa-World是一种语言条件潜在世界模型,通过结合模拟、机器人和视频数据实现高效的模型预测规划和策略初始化。该模型采用视频生成模型的语言条件接口,使JEPA风格的潜在世界模型(LWMs)能够跨不同领域和数据源学习。
IT之家 · AI7070阿里 Qoder 官宣支持 Linux ARM64 与龙芯平台,适配统信 UOS、银河麒麟操作系统。此次升级将 Qoder 完整工作方式带到国产桌面系统,用户可调用工具、操作文件并让多个智能体协作,获得与其他平台一致的编程与通用能力支持。
Hugging Face Daily Papers6565Cola2 通过动态跨度分割、掩码扩散解码和流匹配先验联合优化持续语义压缩、重建-生成平衡和编码器-解码器自适应,在五个下游任务上验证了其核心设计,使用 2100 亿训练 token 显示出有竞争力的非饱和扩展性,3460 亿源 token 的未收敛检查点在八个任务上平均达到 60.10 分,并在 HellaSwag 和 StoryCloze 上超越 Llama-3-8B。
Hugging Face Daily Papers6565T²Quant 框架通过少量无标签校准提示预测精度敏感性,在固定比特宽预算下分配激活精度,在 3 个扩散语言模型和 6 个基准测试中改进现有量化方法达 6.7 个百分点,无需增加平均精度预算。
 Anthropic Research精选8282
Anthropic 与 Theorem 合作,用 Claude 对 123 个 OSS-Fuzz 开源库的 239 个入口点完成 RISC-V 汇编层的形式化证明,证明这些程序在小于 64 MB 的任意输入下都不会崩溃,证明代码约 1.8 亿行 Rocq。
推荐理由: Anthropic 使用 Claude 在 123 个开源库的 RISC-V 汇编层完成形式化证明,并给出成本与复用数据,可据此判断该方法能否进入日常开发流程。
Hugging Face Daily Papers7070AgenticRoboRL 框架通过监督微调和多轮强化学习提升机器人规划器,在 LIBERO-PRO 上将 9B 参数规划器成功率从 18.1% 提升至 71.0% 不依赖外部记忆,接近 Codex (GPT-5.5) 使用外部记忆达成的 72.1%。该框架适配不同执行机制,将记录的规划器交互与任务结果连接,通过适配器实现通用强化学习训练流程。
The Decoder精选同一件事 · 2 家7474AI 初创公司 Recursive 发布首个语言模型 Flint,开发过程中名为 Eureka Machine 的 AI 系统参与提出想法、搭建、测试并规划后续实验。
推荐理由: Recursive 首次公开由自动化研究系统参与开发的模型,读者可据此观察 AI 辅助研发能走到哪一步。
IT之家 · AIAnthropic 平台工程团队所有代码由 Claude 生成,工程师转向系统设计与验证,AI 智能体已自主修复测试并探索直接修改代码库。
MarkTechPostRecursive 发布开源 40B 模糊模型 Flint,2.5B 活跃参数,在 50B 以下 MoE 模型中表现最佳,支持推理和 OpenAI 兼容工具调用,4 位权重约 23GB,SWE-bench Verified 74.2%。
 AWS Machine Learning Blog5252
AWS 推出在 AWS Trainium 上用 torchtitan 训练 Qwen3 的三种方法,包括使用 Transformers v5、torchtitan 原生配置以及 Neuron Kernel Interface (NKI) mixture-of-experts (MoE) 内核。