跳到正文
实时
11月10日周二
  1. The Decoder71

    字节跳动 Seed 发布 Seedream 5.5 图像生成模型

    字节跳动 Seed 推出面向专业生产工作流的图像生成模型 Seedream 5.5,称其支持最多 100 轮多轮编辑,未改动区域在像素级保持一致且不出现偏色。该模型可原生生成带透明背景的 RGBA 图像,无需手动抠图即可作为设计素材使用,并称在光照、材质、皮肤质感和密集小文字还原上更准确。Seedream 5.5 正通过即梦、豆包、豆包 Work 和火山引擎方舟逐步开放,Pro 版本已在计划中。
    推荐理由: 原文列出多轮编辑稳定性、原生 RGBA 输出和文字渲染三项能力,可据此判断它在设计生产流程中的位置。

  2. Epoch AI

    Inference Performance Index (IPI) 如何衡量推理能力

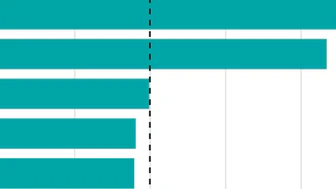
    Nvidia GB300 相比 H100 在智能体推理任务上的能力提升达 25 倍,远超 8 位 FLOP/s 的 2.5 倍增长。IPI 指数通过比较芯片在多种输出速度要求下能同时处理的请求数量来衡量推理能力,GB300 设为基准值 1,得分为 1 的芯片能同等条件下服务两倍用户。IPI 版本 1 结合四款代表性模型结果,采用 GB300 当作参考基准。

  3. Artificial Analysis Articles66

    Meta 最新模型 Muse Ember 在 AI 指数上得分 36,与 Claude Haiku 5.5 相当但成本更低

    Muse Ember 得分 36,与 Claude Haiku 5.5 相当但任务成本仅为 0.14 美元,较后者低三分之二;其输入输出 token 价格与 Claude Haiku 5.5 和 GPT-6 Luna 相同,但缓存输入成本更低。在 AutomationBench-AA 上得分 68.1%,与 Muse Wonder 相当,但在知识准确率上最低(21.1%)

  4. TechCrunch · AI72

    Meta 发布轻量模型 Muse Ember,主打智能体执行与低成本

    Meta Superintelligence Lab 发布轻量模型 Muse Ember,输入价格为每百万 token 10 美分,主打工具调用、编码子任务、路由、抽取和长文档解析等智能体高频工作。

    推荐理由: Meta 用每百万输入 token 10 美分的定价和 Artificial Analysis 综合基准,把轻量模型放进智能体执行环节与 Haiku、Luna 比较。

11月9日周一
  1. IT之家 · AI82

    美团龙猫开源 LongCat-2.5 模型,总参数 1.6 万亿、支持百万上下文

    美团龙猫将面向长程智能体任务的原生多模态模型 LongCat-2.5 正式开源,采用 MIT 协议,支持商用推理部署与二次训练且无需额外授权。模型总参数 1.6 万亿,每个 token 激活约 480 亿参数,支持一百万上下文,并针对显存与带宽受限的国产算力芯片在架构、芯片适配与部署策略上做了协同优化。

    推荐理由: 原文给出总参数、激活参数、上下文长度与开源协议,读者可据此判断长程智能体任务的开源模型选项。

  2. 量子位82

    腾讯混元Hy4发布:770B总参数、49B激活参数,首次支持原生视觉与电脑操作

    腾讯混元Hy4正式发布,770B总参数、49B激活参数,首次引入原生视觉能力和电脑操作支持,指令遵循、长文理解与长程Agent能力同步升级。模型已在腾讯云TokenHub、WorkBuddy/CodeBuddy、元宝等产品上线,API接入OpenRouter、Hermes、OpenCode等平台,权重将于近期开源。

    推荐理由: 作者用多个长程任务实测混元Hy4的自主执行与自检能力,可据此判断开源模型在Agent交付上的实际水平。

  3. MIT News · AI38

    麻省理工学院开发FLEX平台助机器人理解自然语言指令

    由麻省理工学院和纽约大学研究人员开发的FLEX平台使机器人能够从自然语言指令中推断深层含义,提升运动规划能力。该平台通过GPT-4o分析指令模式,让机器人在虚拟场景中避开笔记本电脑和手机等电子设备,无需明确指示。整个过程耗时约五秒,旨在让机器人理解人类指令背后的潜在意图。

  4. Artificial Analysis Articles38

    介绍 Artificial Analysis 决策指数 v2

    Artificial Analysis 发布决策指数 v2,采用新指标奖励模型正确性与校准置信度,45%基准基于私有数据集;Drex Max v1.1(Nace AI)以 73 分领先,GPT-6 Luna(Max)以 76 分位列语言模型第一,但成本与推理时间显著更高。

11月8日周日
  1. MiniMax · Hugging Face 新模型

    MiniMax-H3-Image-PE 提供提示扩展功能

    MiniMax-H3-Image-PE 通过提示扩展(PE)将简短请求转换为详细图像描述并推荐宽高比。它支持文本到图像(T2I)和图像编辑两种工作流程,使用微调自 Qwen3.8-27B 的 FP4 权重。在线 API 可通过 platform.minimax.io 或 platform.minimax.cn 访问,文档提供中英文支持。

  2. MarkTechPost65

    如何使用 llama.cpp 运行 NVIDIA Dory 4B:逐层指南

    使用 llama.cpp 运行 NVIDIA Dory 1.0 4B 模型,该模型通过重复中间层计算实现推理增强,每个额外循环增加计算量但不增加参数。构建指定分支的 llama.cpp,下载 3.7 GB GGUF 文件,分析每层循环的参数和缓存消耗,测试解码速度和缓存影响,并在 GSM8K 上评估精度、答案长度和推理时间随循环次数的变化。

  3. The Decoder65

    思考机器的 Inkling 2 Small 在基准测试中使用了 316 次脏话

    Vals AI研究人员分析了Inkling 2 Small在13个基准测试的2,655次运行中的思考日志,发现其中50次使用了"fuck"或其变体,共316次,其中241次来自两次失控的运行。一次任务中,模型计算小行星轨迹时生成50万字符的单一响应,重复相同句子并包含158个脏话。ProgramBench受影响最严重,200次运行中有20次出现脏话。

11月7日周六
  1. IT之家 · AI65

    Meta 推出基于 Muse Wonder 训练的现有模型专用版本,主动记忆与专注能力下放

    Meta 推出基于 Muse Wonder 训练的现有模型专用版本,将主动记忆与主动专注能力下放至 Muse 与 Meta AI 专用模型群,Muse 模型在 90% 任务中正确使用关键上下文比例提升至 76%,Meta AI 模型在 Meta“个人超级智能指数”得分从 38% 提升至 47%,新模型优先向订阅用户开放,订阅价格为每月 20 美元或 100 美元。

  2. The Decoder65

    递归智能发布开源模型 Ripple-65B Preview,在编码基准中表现优异

    Ripple-65B Preview 在 TerminalBench 2.1 编码基准中取得 80.52 分,成为开源美国模型中的最佳成绩。该模型基于 12 万亿 tokens 预训练,使用密集 Transformer 架构,参数量 65B,并针对 Nvidia 硬件优化,部署成本较低,总研发费用仅 3200 万美元。模型在 Hugging Face 上以 Apache 2.0 许可证开源。

  3. O'Reilly Radar22

    本周AI速览:进步的成本

    谷歌发布了用于网络安全和多步骤任务的Gemini 4 Carbon,法国Mistral公布了其1万亿参数的Large 4模型权重,DeepMind预览了模拟环境的Genie 4世界模型。

11月6日周五
  1. The Decoder73

    Thinking Machines 发布 Inkling 2 Small,称其为最强西方开源权重模型

    Thinking Machines 发布第二代模型 Inkling 2 Small,采用 MoE 架构,总参数 594B、激活参数 17B,支持文本与图像输入并可调节思考深度。

    推荐理由: 原文给出新模型在智能指数、智能体任务和成本上的具体对比,读者可据此判断开源权重模型的竞争位置。

  2. IT之家 · AI58

    Pangram正式发布AI图像检测模型Pangram Image 1.0,准确率达99.96%

    Pangram Image 1.0 模型通过热力图定位 AI 生成内容,在 1200 张照片测试数据集上准确率达 99.96%。该模型能对抗压缩、缩放和人工修饰影响,256×256 分辨率下准确度仍达 96.4%。同时发布的 Pangram Image Flash 1.0 视频检测模型在 DF26 数据集上准确率 98.7%,领先第二名 29 个百分点。

  3. Hugging Face Daily Papers65

    BestRand:一种稳定且低成本的基准压缩方法

    BestRand通过分析误差分布,证实随机采样在基准测试中具有高概率的强性能,但存在罕见的大误差导致不稳定。该方法在70多项文本、多模态和智能体基准测试中验证,相比竞争方法将高误差风险降低50.2%、平均估计误差减少16.4%,同时仅需51.3%的构建成本,并平均将OOD估计误差降低21.8%。

  4. MarkTechPost71

    Thinking Machines 发布 Inkling 2 Small:594B 总参数、17B 激活的 MoE 模型

    Thinking Machines Lab 发布第二代 Inkling 的首个模型 Inkling 2 Small,为 594B 总参数、17B 激活参数的稀疏 MoE,支持文本与图像输入和可变推理强度,上下文 1M token。

  5. IT之家 · AI55

    webAI 开源 TwIL-8B 推理模型:聚焦数学与编程,长板表现优于 Gemma 4 31B

    webAI 推出 TwIL-8B 推理模型,基于 IBM Granite-4.2-8B 优化数学与代码任务,MATH-500 和 AIME 2025 测试成绩优于 Gemma 4 31B,LiveCodeBench 同组最佳,IFBench 与 Gemma 4 12B 持平。模型推理能力达前沿模型的 88~93%,降低 AI 使用成本但知识储备有限。