评估评估者:调查 LLM 判官在个性化写作风格评估中的表现
研究人员评估了大型语言模型(LLM)判官在个性化写作任务中的表现,发现判官质量与 MMLU 测量的通用 LLM 能力相关性较弱(Pearson’s ρ ≤ 0.2),且表现受写作任务和评估标准(如通用帮助性 vs 风格个性化)影响。LLM 评估器在成对比较中比独立评分响应时更一致且表现更佳,而“最强”LLM 并未最可靠地复现人类评估,可能因对人类标注者和较弱 LLM 忽略的细微细节过度敏感。


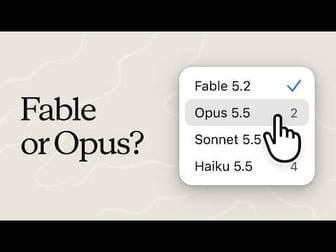
Claude Code 发布 Fable 5.2,用户需根据任务类型选择 Opus 5.5、Fable 5.2、Sonnet 5.5 或 Haiku 5.5,或跨模型分配任务;各模型可用性及使用限制因订阅计划而异。指南建议在复杂编码与知识工作、开放性技术任务、低成本限定工作等场景下分别选用对应模型。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
Mastra Forward 发布,为企业提供 AI 工程专家服务,工程师可使用 Mastra Forward 部署的专家与 Mastra Factory 构建的智能体工厂,年费低于一名资深 AI 工程师。
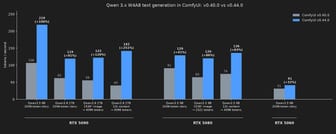
ComfyUI 通过优化 Qwen3.x 系列模型推理路径,使相同 Checkpoint 在 RTX 5090 上生成速度提升至原来的两倍,无模型改动及质量损失。
亚马逊网络服务使用其自动化推理工具Tiros验证网络隔离,通过将网络配置转换为逻辑命题并分析模型中的可能路径,检查隔离是否符合声明策略,替代了传统的动态采样方法。
Meta 的 Intelligent Delivery 系统通过 AI 优化计算资源分配,自 2017 年以来为广告排序性能额外提升约 10%。该系统包含预测计算边际效用的 Resource Core Model(6B 稀疏参数+20M 密集参数)、跨系统资源迁移的多层机制,以及利用智能体 AI 持续检测响应系统变化的框架。
Marktechpost AI 发布 GPU Leaderboard,一个用于 AI 推理的免费云 GPU 价格比较工具,并推出同名 Chrome 扩展。该工具通过读取各提供商官网的按需和竞价价格,按每 GPU 小时价格对可租用的云 GPU 进行排名,并提供推理成本计算器(包含空闲时间成本)。
AWS Quick 的 AI-驱动的产品开发生命周期(AI-PDLC)通过六种专用技能代理,结合人类审批,将企业信号转化为验证原型。Discovery 代理分析企业数据源中的痛点,Prioritize 代理使用 0-10 分数框架评估用例优先级,所有决策均需人工确认。
Bright Machines 通过在工厂边缘使用 Debezium 捕获 PostgreSQL 变更,将其写入 Apache Iceberg,再通过单一可审计的出站路径发送,最终在 Databricks 中通过 Unity Catalog 联邦读取,为客户提供了无需开放工厂网络访问的实时、受治理的工厂数据仪表盘。
德国国防科技公司 Helsing 发布 Clarity AI 平台,该平台通过整合传感器数据、开源情报等生成目标建议,由数百个 AI 代理处理信息并供人类审核,强调欧洲控制和人工监督。
亚马逊 SageMaker AI 双向流推出按使用量计费模式,使模型提供商能通过 AWS Marketplace 报告实时流式推理的实际使用量。Deepgram 成为首发合作伙伴,为 AWS Marketplace 带来语音转文本和文本转语音的按使用量计费。
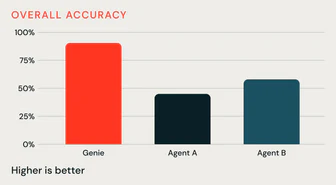
Genie 在包含表格、笔记本、仪表板等企业级知识资产的基准测试中,正确率达 91%,远超 Agent A(45%)和 Agent B(58%),同时 token 使用量减半,速度提升 3-4 倍。Genie Ontology 通过自动提取和组织企业知识,为 Genie 提供共享的业务理解,显著提升准确性和效率。
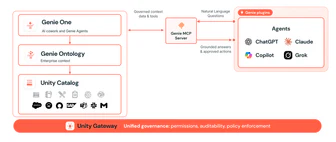
Databricks 发布 Genie Ontology 企业上下文层,结合受管定义与持续学习的组织知识,为 AI 智能体提供业务理解能力。Genie 插件支持 ChatGPT、Claude、Microsoft Copilot Cowork 和 Grok Bot,使团队能在 Databricks 中维护业务上下文并跨多个智能体使用。
Databricks Genie Agents 通过支持非结构化数据分析和新 MCP 连接器,现能执行高质量业务分析、分析大量文档并连接企业工具以自动采取行动。新增的 OpenSharing 功能允许用户共享预装数据、指令和知识的受管 Agent 给合作伙伴、供应商和客户,加速外部洞察生成。
Hugging Face 博客介绍了多向量嵌入模型的 Token Pooling 感知训练方法,通过 HierarchicalTokenPooling 将相似 token 嵌入合并以压缩存储。
Anthropic在其IPO路演视频中透露,Claude模型现支持AWS Trainium、Google TPUs、NVIDIA GPU和AMD GPU四大芯片平台,这是早期多芯片策略的成果,使新平台部署时间从数月缩短至三天。
Anthropic宣称通过AI将其AI模型Claude迁移到AMD GPU的时间从数月缩短至三天,几乎无需人工干预,以此打破对英伟达的依赖。该公司表示,AI模型Mythos完成了99%的内核迁移或编写工作,使新硬件能在三天内达到可用性能水平,而传统工程方法需要六至十二个月。
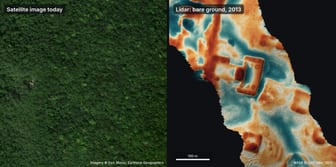
谷歌SWE使用48个AI智能体分析NASA雷达数据,72小时内发现墨西哥未报告的玛雅金字塔;智能体通过处理1,200 km²的雷达图像,识别出具有直角和锐角的疑似金字塔、广场和蓄水池结构,经墨西哥国家人类学与历史研究所确认该地点未在注册记录中。
重度使用AI会导致人类难以理解的代码,但非预期后果的经济影响尚无定论。衡量成本变更指标(变更的代价)是评估这些后果的关键,其核心指标包括价值附加百分比(业务价值开发工作占总开发工作的比例)、DORA指标(变更交付时间、频率、失败率等)和token使用量。其中,价值附加百分比最能反映非价值附加工作(如bug修复、事件处理)的占比变化,而token使用量可作为辅助指标触发进一步调查。
Anthropic Claude Mythos Preview 模型仅用 3 天完成适配 AMD MI355X GPU,传统适配需 6-12 个月;GPU 正趋向通用算力资源,引发对英伟达 CUDA 护城河的挑战。
美国数据公司向中国 AI 实验室出售约 5 亿美元数据,其中强化学习环境助其提升编码、网络、金融、法律、生物等领域的模型性能。这些环境通过模拟世界让模型反复训练,并使用评分标准优化输出。中国实验室通过购买与美企 Anthropic、OpenAI 等相同的 RL 环境,每年可节省超 70% 的推理计算成本。
Tree-Ising 通过解决 BF16 参数上的稀疏 Ising/QUBO 问题修复大语言模型推理循环,以更少的权重编辑提升数学基准准确率且无需梯度或 LLM-token 成本。
vLLM通过EPD(Encoder/Prefill/Decode)分离技术扩展多模态服务能力,支持独立部署的视觉编码器,vLLM v0.32.0包含MiMo和XPU支持,DeepSeek V4.1 Flash的元数据仅请求功能已开源。
联发科赋能今日宜休发布 ISHO iFlow 智能温控系统及 Pro 版,均搭载 Genio 420 平台,该平台基于 6nm 制程,提供 7.2 TOPS AI 算力及 16GB LPDDR5X,支持双人独立监测的 BCG 无感监测功能,标准版售价 9999 元起。
"WikiTrace 通过将每个蒸馏经验与其来源轨迹和推理链关联,使大语言模型智能体在行动前验证和修正记忆,在五个智能体基准测试中提升性能并减少记忆导致的退化。该系统将每个经验作为精简洞察存储,并链接到其轨迹成功或失败的原因摘要及原始轨迹,智能体在执行新任务时可通过链接工具补充缺失细节或修正洞察,验证显示其优于现有记忆方法及仅使用相同洞察的基线。"
GitHub Copilot 0.169.0-alpha.11 发布,该版本未明确提及具体更新内容或性能指标。
inclusionAI 发布了 ZoomGain-4B 大语言模型,在 ZoomGainBench 上取得 61.08 分,并在多个细粒度感知和通用感知基准测试中表现优异;模型基于从全局图像细节中挖掘的全局到局部视觉感知差距构建监督,支持英文和中文问答,可通过 Hugging Face 下载。
InfraRSI 通过五阶段工作流程将开放式人类指令转化为经过验证的训练优化,在四个单节点和多节点密集及 Mixture-of-Experts(MoE)LLM 工作负载中实现高达 2.75 倍的加速,并将平均模型 FLOPs 利用率(MFU)从 17.4% 提升至 30.0%,优于现有调谐器和编码智能体。
World In-Context Learning (WICL) 方法通过冻结模型,在模拟器中演练任务并将反馈写入上下文而非权重,使机器人能从单一演示中学习操作技能。RoboScript 实现了 WICL,在 RoboTwin 2.0 的 50 项任务上,单次演示无梯度更新即可达到 83.4% 成功率,超越最强训练策略 20 余点,并支持跨视觉分布泛化、通过反思改进、基础模型扩展及跨平台记忆迁移。
Apple 新应用 Harbor 可将 Mac 转换为私有 AI 推理服务器,支持在 Apple Silicon 上本地运行开放权重模型,数据不离开硬件或云端。通过 Thunderbolt 5 连接多台 Mac 可聚合统一内存,支持大型模型和更高并发。该应用目前处于 Claris 品牌的私有预览阶段,预计即将向公众发布。
MBZUAI 的 IFM 发布 PAN 2,一个开放 29B 参数扩散 Transformer(MMDiT)世界模型,输入文本和可选首帧,输出 704×1248 分辨率 24 fps 视频(最长 20 秒),在 100 步多任务中实现 34.0% 的完整计划完成率,领先 6 个测试模型,但长计划失败率高且硬件需求高,代码在 Apache 2.0 下开源。
DexForesight 框架通过将动态感知的世界表示注入灵巧策略的潜在空间来隐式学习空间预见性,在 11 个 DexJoCo 模拟任务上使基础策略成功率从 49.4% 提升至 60.5%,在 3 个真实机器人灵巧操作任务上达到 58.3% 成功率。
Nordic 推出 nRF71 系列 Wi-Fi SoC,内置 Axon NPU 直接在芯片上执行 AI 推理,包含 nRF7120(双频 Wi-Fi 6)和 nRF7120E(三频 Wi-Fi 6E)两种型号,待机功耗最高降低 1/20。
Infrathon 对六种模型进行了 150 次长时程 AI 基础设施优化任务评估,总耗 10,000 GPU 小时,发现模型排名随评估时程变化,135 次任务在预算后半段实现进一步优化,且 Claude Opus 5.5 将 KV 缓存压缩率从 6.82% 提升至 19.86%,超出人类设计基线。分析显示任务违规、测试不可靠和过早完成是持续优化的主要障碍。
Sing VL S1 是一个基于 Qwen3.5 的多模态决策模型,可对文本或 JSON 及最多四张图像回答命名问题,每个问题使用单个 Transformers 前向传递评分选项,在 43 个文本数据集和 11 个视觉数据集上表现优异,支持 Python 3.12 和 PyTorch 推理。
Fish Audio 发布全双工语音模型 Live 3,可同时听说并学习实时对话时机,短反应最快 186 毫秒;部署于 Fish Agent 平台、API 或企业本地,英语支持,价格 0.035 美元/分钟(至 2026 年 12 月 31 日)。
OpenAI 在 AI 工程师代码峰会上介绍了 Codex 的新工作方式,包括云功能改进、语音交互和智能体协作。Codex Cloud 2.0 允许用户在隔离实例中运行多个任务,但仍存在云功能易用性问题。语音模式作为控制平面可管理代码库,个人智能体 dots 可作为安全网、委托节点和无处不在的存在。
Tether AI Research 推出 0.8B 参数的 BotPsy 模型,基于 Qwen3.5-0.8B 构建,专为函数调用和代理工作流设计,适合设备端部署。BotPsy 在 6 项工具使用和代理基准测试中优于所有 ≤1.2B 参数模型,包括 Qwen3.5-2B-Think,并在 5 项测试中得分最高,速度提升 2.5 倍,推理效率提升 3 倍。
阿里推出 Qwen Code 1.0 版本,融合 Qoder 的 Harness 能力,随 Preview 开源;通过统一事件模型实现推理编排与工具执行的分离管理,支持从“一个进程、多个会话”向“多个节点、更多会话”演进,开发者可构建 Agent 系统。
华为麒麟 9050 系列搭载新一代达芬奇架构 NPU,性能提升 140%、功耗降低 66%,业界首个支持 30B MoE 大模型端侧运行,具备离线特性,并支持多级存算协同优化、低比特量化。