Hugging Face Daily Papers6565
当潜在预测误差支持物理意外主张时——视频世界模型研究
研究表明视频世界模型的潜在预测误差反映外观和运动而非可靠测量物理意外。在IntPhys2基准上,潜在预测、掩码像素重建和简单视觉统计的比较显示,外观易于解码,V-JEPA2仅略微揭示事件是否可能。
Hugging Face Daily Papers6565研究表明视频世界模型的潜在预测误差反映外观和运动而非可靠测量物理意外。在IntPhys2基准上,潜在预测、掩码像素重建和简单视觉统计的比较显示,外观易于解码,V-JEPA2仅略微揭示事件是否可能。
Hugging Face Daily Papers6565Hugging Face Daily Papers发布了一份关于由大语言模型驱动的代理计算机图形学的报告,提出了统一分类法和文献系统,分析了人机协作和长期规划的趋势与挑战。报告介绍了用于表征不同计算机图形任务中代理系统的统一分类法,并开发了可协助研究人员大规模分析现有及新发表论文的代理文献系统。
Hugging Face Daily Papers6060NorthCUA 通过经验飞轮、递归自改进、分阶段学习和强化学习来规模化计算机使用智能体,在 GUI 和网页交互方面取得开源模型顶尖结果。
 Hugging Face Blog
Transformers 支持超过 750 模型类型,其测试套件包含 88,000+ CPU 测试和 200,000+ GPU 测试。Hugging Face 发布 Model Integration Contracts (MIC) 标准,包含压缩模型(如 66 MB 权重的 UMT5 固定件)、可运行示例(如 SmolLM 文本生成)和人工审核基线。
 MiniMax · Hugging Face 新模型
MiniMax-H3-Image 是 MiniMax H3 家族的一款开源图像生成与编辑模型,支持 16MP 图像生成、图像编辑及最多 16 张参考图像,采用 H3 架构并使用 Qwen3-VL 文本编码器,在 Hugging Face 上提供 68.65GB 的 BF16 精度模型权重。
Hugging Face Daily Papers6565CEPO 通过将共享协调与智能体特定执行分离,提升了多智能体系统的提示优化效果,并在 11 个跨四个领域的基准测试中持续改进了四种现有提示优化器的性能。该框架使用共享协调器提示和智能体特定执行提示,指导它们根据各自角色更新,使共享协调规则能在所有智能体间一致优化,同时保持执行指令的独立调整。实验表明 CEPO 提升了优化预算效率,并随智能体数量增加而扩展性能。
Hugging Face Daily Papers5959Apriel Voice 27B Preview 是一个开源语音语言模型,通过两阶段训练流程(含在线蒸馏)整合语音理解、推理和工具使用,在音频基准测试中表现优异。
Hugging Face Daily Papers6565HiFOR 通过层级预测未来状态并检索相关未来信息来指导行动生成,提升机器人操作能力。该框架通过层级依赖掩码(HDM)联合预测短期状态演变、语义里程碑和最终目标状态,建立跨时间范围依赖关系;结构感知潜在世界建模沿时间、视角和空间维度组织未来潜在表示,促进细粒度检索;行动引导分解世界检索根据去噪过程中的行动表示自适应检索相关未来信息,为行动生成提供针对性指导。
Hugging Face Daily Papers6565FrameForge通过动态时间专家和中间推理路径建模预训练视频模型的先验,实现自适应条件图像生成,在DreamBench、COCO2017和GEdit-Bench上取得优于对比方法的性能。
 IT之家 · AI6565
研究人员使用50个GPT-6.1 Sol智能体在《我的世界》中搭建文明群落,因官僚化倾向未能发展壮大;10个GPT-6.1 Sol对阵10个Claude Opus 5.5的起床战争测试中,GPT智能体策略更激进,完成问题诊断并共享解决方案;七局Mindustry对战中GPT智能体六胜一负,体现蜂群模式优势。
Hugging Face Daily Papers5858Wizard解耦角色动画、场景操控和游戏逻辑与视觉生成,通过结构化视觉代理让智能体控制关节骨骼和场景几何,实现24 FPS的实时交互,零样本泛化到未见场景、角色和动作。团队构建了50.3小时对齐的代理-视频对,包含750场景和178个角色,支持角色自适应遮罩、因果适应和少步蒸馏技术。
 Moonshot AI · Hugging Face 新模型
Kimi K3.1 Pro 是 Moonshot AI 开源的多模态智能体模型,参数量 2.8T,激活参数 104B,上下文窗口 1M tokens,在编码、3D 创建、金融研究等领域表现优异。与 Kimi K3 相比,采用 Gated DSA 层提升长文本处理效率,在 Terminal-Bench 4.0 等评测中超越 Claude Fable 5.1 和 GPT-6 Astra 等竞品。
Hugging Face Daily Papers4545Co-Design Bench 基准包含 273 个任务和 2,331 项专家编写的验收标准,源自 26,314 次真实用户编码会话。在 10 个模型端点上,gpt-6-astra 平均通过每项任务 69.9% 的标准,但仅 26.4% 的任务完全满足;Qwen3.8-27B 总体严格完成率 64.4%,在仓库编辑子集排名第二。
Hugging Face Daily Papers2222HairDeck 使用扩散 Transformer 从单张图像生成卡通发型卡牌和弹簧骨动画,准确性和速度优于现有方法。它将发型视为艺术家定义的原始集,通过扩散 Transformer 一起去噪生成每个卡牌为单个 token 的发型。
Hugging Face Daily Papers6060Youtu-Parsing-Omni 将文档、图像、音频和视频编码为时空结构化记录,通过自进化策略蒸馏实现最优解析效果。单模态编码器共享权重并融合跨模态信息,单架构统一十种解析任务输出,5B参数版本在 OmniDocBench v1.6 和 OmniParsingBench 上取得 96.96 和 75.08 的顶尖成绩,代码和权重开源。
Hugging Face Daily Papers3131SpecSlot 通过使用局部频谱槽和限制全局注意力来改进像素空间生成 Transformer,在不增加计算成本的情况下提高图像细节。SpecSlot 将每个空间锚点扩展到多个槽,每个槽分配一个不同的 DCT 系数带,这分离了锚点密度和频谱细分;每个锚点只有最低频的槽参与全局注意力,而所有槽都进行局部交互。
 Transformers releases66
GitHub Copilot 发布 v5.22.1 补丁版本,包含最新功能改进和修复。
 量子位精选7575
SoMark 团队开源 1.3B 文档解析模型 OXR,在 OmniDocBench(97.18)、olmOCR-Bench(87.84)和 DocParsingBench(87.76)三项榜单排名第一。
推荐理由: 1.3B 模型靠 RSI 后训练在三个文档解析榜单登顶,并给出可插拔架构与免费 API 的工程取舍。
Hugging Face Daily Papers6565研究通过难度度量形式化基准评估,识别测量不匹配和覆盖缺口,提出诊断指标和重写算法改善基准覆盖;分析25个跨7领域的流行基准,发现多数基准隐式高估特定难度区域或未覆盖难度轴大部分区域,限制模型改进监控能力;引入BenchFill算法有效减少局部覆盖缺口。
IT之家 · AI精选同一件事 · 2 家8282Mistral AI 于当地时间 10 月 29 日正式开放 Mistral Large 4(代号 le Chonk)模型权重,这是一款 1 万亿总参数、490 亿激活参数的原生多模态模型,在欧洲自有数据中心用 3,800 块 NVIDIA Grace Blackwell GPU 从零训练。
Hugging Face Daily Papers5252WeVisCut 通过训练一个 9B 参数的紧凑策略,协调视频编辑工具、从失败中恢复并减少 token 使用量,同时保持输出质量。该系统采用四阶段数据管道,结合编辑反演和验证重放,从 3,750 个成品视频中生成超过 130K 个训练示例,用于训练单一策略。
 MarkTechPost
Baseten 发布了 joey-1,一款 2B 参数决策模型,返回标签和校准概率而非生成文本,用于高容量路由、分类和护栏检查,每百万输入 token 价格为 0.01 美元,权重在 Hugging Face 上以 MIT 许可证开源。
 TechCrunch · AI精选同一件事 · 2 家7878
Mistral 发布了其万亿参数开源模型 Mistral Large 4(ML4,昵称 Le Chonk)的权重,企业与政府可在 Hugging Face 和 API 上获取并自行部署。
Hugging Face BlogProject ProtoStar 项目发布,旨在通过使数据集、模型和代码更易获取和复用,解锁公共资助科学研究的潜力。该项目汇集了大学、研究机构、产业和开放科学社区,支持以 AI 兼容、机器可操作的格式发布科学成果,并通过一系列公开挑战展示其价值。首个挑战由卡内基梅隆大学主办,将于 11 月 2 日启动。
 The Decoder同一件事 · 3 家
美国司法部正在调查英伟达计划收购开源平台 Hugging Face 的交易,官员们质疑该收购是否会让英伟达控制 AI 分发关键枢纽并损害竞争对手,交易额达 129.3 亿美元,预计 2027 年上半年完成。
Hugging Face Blog精选8585Mistral 发布多模态 MoE 模型 Mistral Large 4(Le Chonk),约 1T 总参数、49B 激活参数,上下文窗口 1M tokens,提供 FP8 与 NVFP4 两个官方版本,另有 Unsloth 和 llama.cpp 团队制作的 GGUF。
推荐理由: 原文给出 1T 总参数、49B 激活的 MoE 多模态模型在网络安全与编码基准上的具体分数,并附本地与端点部署实测吞吐。
Hugging Face BlogHugging Face 发布 Granite Switch 4.1.1,在 4.1 基础上增量更新,保留完全向后兼容性。新增多语言语音转写模型(支持 10 种语言带原生标点)和 Jev 决策指数测试集性能提升的决策适配器。团队通过仅更新适配器未重新计算基础模型,实现快速部署,未来将支持第三方自定义适配器。
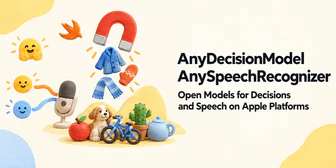
Hugging Face Blog5050Hugging Face 发布开源语音识别 AnySpeechRecognizer 和决策模型 AnyDecisionModel,支持 NVIDIA Parakeet 和阿里云 Qwen3-ASR 等引擎,可在苹果平台本地运行。
Hugging Face Daily PapersProx模型通过top-k通道选择和基于权重的读取器加速专家混合推理,同时保持准确率,无需校准数据。在13%和18%的预算下,Prox的top-k版本在43次比较中的40次得分不低于或优于阈值版本,包括所有23次生成任务,且避免了校准阈值在Gemma 4上引起的重复循环崩溃。
Transformers releases33GitHub Copilot 发布 v5.21.1 补丁版本,原文未提供具体更新内容。
IT之家 · AI精选7878英伟达于 10 月 28 日推出开放权重语音转录模型 Nemotron 3.5 Transcribe,整合转录、说话人归属、翻译和音频问答,采用 MoE 架构,总参数约 340 亿、激活参数约 43 亿,可处理最长 1 小时录音,支持 40 种语言转录、最多区分 8 名说话人。
推荐理由: 英伟达开源语音转录模型,公开了参数规模、多语言与说话人分离能力及榜单成绩,可对照现有开源 ASR 方案。
Hugging Face Daily PapersEmbeddingGemma 2 是一个开源的多模态嵌入模型,将文本、图像、音频和视频表示统一在高效且资源灵活的设计中,并在基准测试中表现优异。它在所有模态的嵌入基准测试中建立了新的帕累托前沿,优于专业模型和规模大两到十二倍的其他模型。该模型支持选择性模态编码器加载、可调节的视觉标记预算、可截断的嵌入维度和量化权重,以适应资源受限的环境。
Hugging Face Daily PapersFalcon是一个因果音视频目标说话人提取模型,通过目标说话人嘴部视频从嘈杂重叠语音中提取其声音,结合单次多尺度时频分离器和编码器空间说话人对比损失,在不增加推理成本的情况下减少干扰说话人泄露。
 36氪 · AI同一件事 · 3 家
美国司法部就英伟达收购开源平台 Hugging Face 的交易将如何影响人工智能领域的竞争展开问询,询问这笔收购是否会让英伟达掌控 AI 领域一个基础性的分发渠道。司法部官员同时询问英伟达的收购、投资和销售行为,以及该公司是否曾向客户施压。
IT之家 · AI同一件事 · 3 家美国司法部就英伟达 129.3 亿美元收购 Hugging Face 的交易展开问询,关注其对 AI 竞争的影响。司法部官员重点审查英伟达的并购、投资、销售模式及对客户压力,并审查其 2025 年 12 月对 SchedMD 的收购。
Hugging Face Daily PapersEvidenceConnect 框架通过合成图像区域缩略视图生成比较、聚合或链式视觉证据问题,提升 VLM 的证据连接能力,ZwZ2 模型基于此框架训练,未针对任何下游基准但提升细粒度与空间感知,并在具身空间推理、多模态长上下文理解、多模态智能体任务及通用视觉推理上取得进展
Hugging Face Blog精选7878NVIDIA 发布开源权重模型 Nemotron 3.5 Transcribe,把转写、说话人分离、翻译和音频问答合入同一 checkpoint,支持 40 种语言转写、31 种语言与英语互译、13 种语言说话人标注,可处理最长 1 小时录音并标注最多 8 位说话人。
推荐理由: 原文给出多语言转写、说话人分离与翻译的统一权重模型,并附开放数据管线和微调配方,可据此判断语音场景的适配路径。
Hugging Face Daily Papers分解矢量量化技术通过在互补特征视图上使用并行码本提升了离散视觉token质量,使其在多模态理解中能匹配连续表示,在工业级多模态数据上训练的模型在九项指标平均上比 UniAR 和 Emu3-Chat 分别高 22.8% 和 59.2%,是目前首个能与 Qwen3-VL 等强连续表示模型竞争的离散表示模型。
Hugging Face Daily Papers6565大规模评估显示,专用记忆系统常弱于简单检索增强生成,引入记忆收益与记忆税框架评估净价值。记忆在长时程智能体中日益普遍,但构建记忆相较于直接从原始历史检索的净价值仍不明确。
Hugging Face Daily PapersThe Trinity 框架通过将任务组织成能力树、生成模拟训练世界、路由专业 Harness 模块,递归改进多模态智能体,在 28 个训练基准和 18 个未见基准上提升均值性能 34 和 26 点,包括两个真实世界具身任务。