量子位
科大讯飞首发星辰TaaS平台,让Token真正成为千行百业的生产力
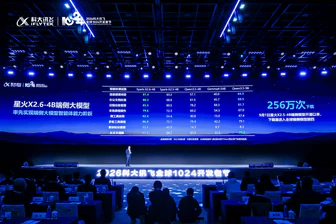
科大讯飞发布星辰TaaS平台,通过模型调度、智能体引擎等中间层能力,将Token消耗转化为同传翻译、数字员工等业务价值,面向企业服务、金融、医疗等行业提供解决方案,让Token不空转。星火X2.6端侧模型开源,上下文窗口扩容至百万Tokens,端云路由准确率达96.1%。
量子位科大讯飞发布星辰TaaS平台,通过模型调度、智能体引擎等中间层能力,将Token消耗转化为同传翻译、数字员工等业务价值,面向企业服务、金融、医疗等行业提供解决方案,让Token不空转。星火X2.6端侧模型开源,上下文窗口扩容至百万Tokens,端云路由准确率达96.1%。
 NVIDIA Technical Blog5555
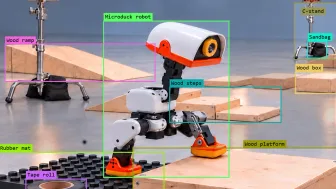
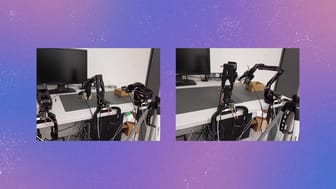
NVIDIA 开发 AI 智能体让 Microduck 在模拟环境中学会行走。模型通过感知环境、维持平衡和调整动作来导航障碍路线。该技术结合了资产创建、物理模拟和训练评估等阶段。
 Tessl Blog3838
代理生成的代码量与速度使人工审查成为瓶颈,团队需用工具替代;代理仅负责编写代码而无部署权限,部署由管道控制;所有代理读取的数据均视为不可信,管道需通过哈希验证和短期身份确保安全,并持续监控权限变更。
 MarkTechPost5858
You.com 推出推理路由器,一个兼容 OpenAI 的托管 API,可运行 12 个开源模型,提供 99.9% 正常运行时间 SLA 和零数据保留。该服务采用按量付费模式,无平台费,并包含 100% 美国托管和服务器端网络搜索。
 36氪 · AI7575
宇树创始人王兴兴在2026世界物理AI大会上表示,物理AI可能在未来一至三年迎来重大突破,并认为通用大模型如GPT-6 Astra能直接控制机器人完成部分任务,尽管在感知真实环境变化和纠正操作失误方面仍存在不足。
36氪 · AI6565宸境科技在2026宇树科技合作伙伴生态大会上亮相钢铁行业物理AI巡检方案,基于通用四足机器人实现自主导航避障、设备数据采集、隐患识别预警,替代高风险、重复性人工巡检。该方案已在多家钢厂落地,验证模型与真机对齐在工业场景的可行性。
 IT之家 · AI
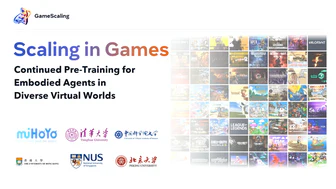
米哈游联合清华北大等高校发布开源 GameScaling 游戏模型,覆盖 0.8B 至 27B 参数规模。该系列 8 个模型基于 Qwen3.5 视觉语言模型继续预训练,训练数据涉及《我的世界》《毁灭战士》等游戏。模型接收游戏画面及操作记录生成后续指令,支持实时游戏交互,4 种参数规模各有 S1、S3 两个版本,采用 Apache 2.0 许可证。
 Hugging Face Daily Papers6565
研究通过在数据规模、多样性和模型大小三个维度上进行持续预训练(CPT),提升了虚拟世界中的具身智能体学习能力,但在远距离世界泛化上存在局限。研究测试了涵盖 0.8B 至 27B 参数、50 至 1600 小时数据预算、五种数据混合的 120 种配置,发现数据量增加提升内部表现,多样性改善相关世界迁移,模型规模提升数据效率但远距离泛化更差。
 AWS Machine Learning Blog
自适应智能体框架 (AAIF) 使用 Strands Agents,通过本地小语言模型 (SLMs) 处理常规任务,复杂请求则路由至 Amazon Bedrock 云模型,降低成本并保持低延迟。
 Hugging Face Blog5858
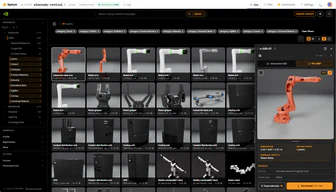
NVIDIA 在 Hugging Face 上线 SimReady Central Library,汇集 2000 多个可直接用于仿真的 OpenUSD 资产,覆盖机械臂、夹爪、仓储设备、机架和冷却设施,免费且无需申请即可使用。
 NVIDIA Blog5858
NVIDIA 欧洲合作伙伴正扩展区域计算能力,支持模型训练与推理,帮助开发者构建 agentic 和物理 AI 应用。Nscale 使用 NVIDIA DSX 平台实现 37% 更多 GPU 和 50% 更高推理吞吐量,Crusoe 开发液冷 AI 工厂支持低延迟推理,Nebius 采用 NVIDIA Groq 3 LPX 加速敏感应用。
量子位6565生数科技Motubrain团队开启2.0训练全流程直播,持续半个月展示具身模型训练过程。直播涵盖预训练、后训练、Agent任务执行和RSI探索四个环节,向公众开放模型从训练到能力迭代的过程。此举旨在提升Physical AI研发透明度,分享规模化训练、跨任务泛化等研究经验。
 TechCrunch · AI
Eka Robotics的机器人能以超人类水平处理物体,刚完成1.5亿美元A轮融资,估值14.5亿美元。其核心是视觉-力-行动模型,而非常见的视觉-语言-行动模型,通过物理模拟和强化学习实现无需重新训练即可适应多种物体,可靠抓取成功率超95%。创始人来自MIT和DeepMind,该技术旨在弥合通用性与性能的差距。
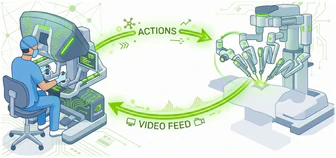
Hugging Face Blog精选6666NVIDIA 发布 Cosmos3-H-Dreams,把交互式生成模拟扩展到临床胆囊切除场景,可依据器械动作实时生成手术画面。
推荐理由: 原文交代了从桌面缝合到临床胆囊切除场景的迁移路径,以及四步与两步蒸馏检查点之间的质量与延迟取舍。
Tessl Blog7575工程团队对 AI 代码助手的信任程度决定其使用范围,从仅查看代码差异到完全授权合并,信任建立依赖于快速验证机制。开发平台成本随 AI 智能体工作强度增加而上升,约 80% 的预算被 20% 的重度使用者消耗,需评估单位有效工作成本。成功团队从辅助性任务开始逐步扩大 AI 范围,而非直接应用于核心系统。
 AI as Normal Technology7575
研究人员提出了33项AI智能体评估的兴起趋势,指出评估智能体比评估模型更复杂,需要关注整个行为轨迹而非仅结果,并强调评估范围需扩展至实验室、特定用例和现实世界,同时呼吁更多跨学科评估者参与并确保其独立性。
 O'Reilly Radar6565
ContextCue 项目通过记录会议录音、保留语音讨论、屏幕共享视觉上下文、决策依据及来源,创建可跨团队的共享协作上下文。该实验针对 GitHub Copilot 和 Claude 等工具已提升编码效率但未改善团队间理解协作的问题,将会议记录转化为围绕请求或决策而非会议本身的 Markdown 格式输出,以解决分布式团队因时差和沟通断点导致需求理解偏差的挑战。
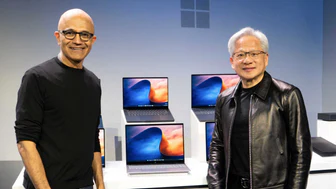
NVIDIA BlogNVIDIA RTX Spark 笔记本电脑开始发售,配备 Blackwell RTX 显卡、最高 128GB 联合内存和完整的 NVIDIA AI 平台,起售价 2399 美元,由华硕、戴尔、惠普、联想、微软和微星推出,为便携设备带来强大的本地 AI、内容创作和游戏能力。NVIDIA 在全球举办发布会庆祝,包括柏林活动,创始人黄仁勋惊喜现身。
 Baseten Blog
Reflection 推出 Beam 大模型,采用 501B 参数的专家混合 (MoE) 架构,每 token 活跃参数 23B,上下文窗口达 100 万 tokens,专为编码和智能体工作负载设计,在编码、智能体、推理和 STEM 基准测试中表现优异,通过强化学习训练以减少 token 使用量,用户可调整推理力度参数,通过 Baseten 提供 API 和专用推理服务。
 Meta Engineering
Meta 使用 AI 智能体参与工程流程构建 Forum 应用,将 AI 视为工程过程的参与者而非辅助工具。该实验以生产就绪成果而非代码量衡量成功,通过 Human-On-The-Loop 模式让 AI 自主执行计划、实施、测试和验证,工程师负责设定目标、监督和验收。
NVIDIA Blog北欧地区已成为欧洲独角兽企业密度最高的地区,每百万人口诞生最多价值10亿美元的初创公司。NVIDIA在过去一年中投资了北欧的技术生态系统,包括瑞典的Lovable和Legora等领先初创企业。
 Ars Technica · AI6565
英伟达的物理 AI 全栈安全解决方案已被机器人公司采用,旨在提升自动驾驶与仿生机器人的安全性。
NVIDIA Blog英伟达与微软合作推出 RTX Spark 笔记本电脑和 Windows AI 代理基础设施,支持本地运行 125B 参数 Qwen 3.8 Flash Next 模型;微软发布 MXC 操作系统级容器保障代理安全运行,预购 RTX Spark 从今日起开放,搭配 Grace Blackwell 芯片,提供高达 20 PFLOPS 推理性能。
AWS Machine Learning BlogAWS 提出自动化价值模型,重新定义智能体自动化商业案例。传统 RPA 投资回报模型忽略智能体自动化在异常处理、决策质量、流程适应性和价值实现方面的价值。企业需考虑释放工时的再部署价值或现金成本降低,以及异常修正成本,才能构建可信的商业案例。
Baseten BlogMetaInfer 技能工具箱通过仅用知识构建自定义推理引擎,在单流解码速度上使 Qwen-3.6-35B-A3B 模型比 vLLM 0.25.1 快 90%,TTFT 提升 2.33 倍。该框架无需模型微调或专用适配器,通过定义约束和优化目标,使 LLM 可针对特定部署实现高度优化的推理引擎。
 Anthropic Research精选7171
Anthropic 发布机器人暴露指数研究,用 Claude 评估 O*NET 约 1.9 万个任务,发现现有机器人可完成美国 74% 的体力任务、占全部工作时间的 34%,但多数限于受控环境。
推荐理由: Anthropic 用 Claude 给 O*NET 任务逐条评级,量化机器人当前能覆盖多少工作,并给出成本与监管的约束条件。
 Google DeepMind
Gemini 3.8 Live with Live Avatar 发布,通过将实时视频生成与语音原生耦合,为 Gemini 对话 AI 增强近实时视觉呈现能力,支持 97 语言同步,可在 Gemini Enterprise 中使用。
 Microsoft Research
将物理 AI 推理卸载到边缘或云 GPU 可显著提升机器人任务成功率、支持更大模型并延长电池寿命。在移动操作任务中,卸载推理使机器人响应速度和准确性提升,电池续航增加,成本降低。Microsoft Research 开发了基于 Kubernetes 的工具集,支持在机器人、边缘设备和云端进行分布式推理部署。
 Meta AI Blog
Meta AI 的 DINOv3 和 SAM 模型在边缘计算中实现实时感知,支持匹兹堡大学 RAMMP 项目开发辅助机器人,通过自然语言与图像数据交互,降低用户认知负荷,已在原型中集成自动门按钮检测、杯子识别及导航辅助功能,并计划增加语音和触控输入支持。
 Cognition Blog
Devin Fusion 在新编码基准 FrontierCode 上以 60% 更低成本保持前沿和 Fable 5 级性能,主要通过运行前沿模型与成本效益型“助手”模型并行的双代理架构实现。该架构通过动态中会话路由和深度调优的交互模式,避免基准测试过拟合并提升任务通用性,在实施导向会话中效率提升最显著。用户可通过 app.devin.ai/signup 试用预览版。
 Prime Intellect Blog
True Agents Model the World 预训练方法使 LLM 能以高精度模拟环境。在 forth-lang 环境中,RLHF 结合 SFT 的方法使模型工具调用更智能,alpha=0.05 时 lookup_doc 使用率显著提升但早期即下降,alpha=1.0 时奖励提升更稳定。
 LangChain Blog
开源大语言模型 GLM-5 和 MiniMax M2.7 在文件操作、工具使用和指令遵循等核心智能体任务上,与闭源前沿模型(如 Claude Opus 4.6、GPT-5.4)表现相似,工具调用可靠且指令遵循一致。
 Dify Blog
Dify 团队 2025 年底走访欧洲,在伦敦、柏林、奥斯陆、里斯本和巴黎与合作伙伴交流,观察到 Dify 在德国历史城镇本地服务器部署、独立开发者个人电脑上构建新工具以及全球企业复杂基础设施中规模化应用的不同场景。
Prime Intellect BlogDeepSeek 发布 SYNTHETIC-2,包含 20 项复杂强化学习任务及验证推理轨迹,支持从消费级 GPU 到超大规模集群的异构计算,采用 DeepSeek-R1-0528 模型生成数据并标注难度。