Google DeepMind
Gemini 4 Argon:专为解决复杂问题而构建
Gemini 4 Argon 在 Vals Index 上排名第一,以 175B 参数规模在编码、金融、法律、网络安全和科学等领域超越其他前沿模型,其推理深度和精度使它成为解决复杂工程问题、优化业务流程和加速科研突破的利器。
Google DeepMindGemini 4 Argon 在 Vals Index 上排名第一,以 175B 参数规模在编码、金融、法律、网络安全和科学等领域超越其他前沿模型,其推理深度和精度使它成为解决复杂工程问题、优化业务流程和加速科研突破的利器。
 Google AI Blog精选9090
Google 发布了 Gemini 4 Argon,面向开发者、企业和科研人员开放,API 定价为每百万输入 token 2 美元、每百万输出 token 10 美元,缓存输入 token 享 95% 折扣。
推荐理由: 官方给出定价、基准排名和多个内部落地案例,可据此判断它在编码与科研工作流中的位置。
 Baseten Blog
Gradium TTS 模型将文本转为语音,专为实时 AI 语音代理交互设计,Coval 基准测试中中位数 TTFA 为 214 ms,独立评测将其归为快于人类语音响应层级。
 LangChain Blog
LangSmith 推出 AI 搜索功能,支持用自然语言查询智能体行为追踪记录。该功能可搜索用户输入、智能体推理、工具调用及响应等内容,帮助团队发现特定行为模式,如 PII 泄露或用户挫败感等。AI 搜索结合 SmithDB 数据层和决策模型,通过分析标准化轨迹而非原始长文本,实现跨 SDK 的快速高效搜索,优先处理用户消息和智能体回复等关键信息。
 IBM Research Blog5858
IBM Research 使用开源智能体工厂优化量子纠错硬件,高级综合评估实现 52 倍加速,成本约 26 美元;同等预算下闭源前沿模型配置成本 299 美元(11.5 倍更高)但加速 204 倍,开源配置以更小面积实现硬件优化;该智能体工厂通过协调器分配任务给并行工作智能体,结合代码修改与硬件效果评估,探索多种架构可能性。
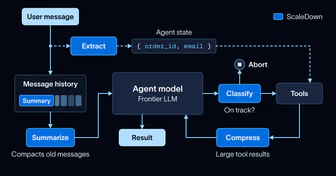
LangChain BlogScaleDown 通过压缩和提取技术优化长时运行智能体的上下文管理,其模型在基准测试中比 GPT-5.5 等通用模型便宜 41 倍且快 2.7 倍。ScaleDown 提供四种模型:Summarize、Compress、Extract 和 Classify,分别用于摘要、压缩、提取和分类,支持最多 1M tokens 的输入,并支持图像和 PDF 输入。
 n8n Blog
Jev 对每篇新闻回答三个问题筛选出真正重要的发展,You.com 节点搜索每日新闻并去重,You.com Research 为每个主题撰写简短摘要并通过 Slack 发布,整个流程成本低于四美分,有效避免无关信息干扰。
 Google Developers Blog
Gemini 4 Argon 在 11 小时内无人工干预运行中,通过分析 205,000 行代码的 ADK Python 仓库,提出了 6 项优化建议,最终 2 项被采纳并上线,将内存会话准备时间缩短约 40%,冷包导入速度提升 21%。该模型在优化过程中遵循了仓库的维护者指南,并运行了全部 16,892 个单元测试。
 OpenHands Blog6565
OpenHands v1.27.0 现支持通过 Agent Canvas 直接创建和管理 DigitalOcean 托管的智能体,扩展了基于 DigitalOcean Serverless Inference 的执行环境选择。
 Ollama Blog5858
Ollama Cloud 现支持在 Fly.io Sprites 全 Linux 虚拟机中运行 AI 智能体,其中 Sprite 是 Fly.io 提供的隔离式 Linux 虚拟机。
 Liquid AI Blog
LFM2.5-24B-A2B 是一个 240 亿参数的推理模型,仅使用 20 亿活跃参数,适用于设备端的快速智能体。该模型在五个关键基准测试中与 Qwen3.6-35B-A3B 竞争,速度比同类模型快 1.7 倍,且开源可用。
 Amp News7070
用户可通过 MCP 与 Puck 交互,在 ChatGPT 或 Claude 中构思后将其任务发送至 Puck 实施并管理。Puck 知晓用户在 Amp 中的项目并路由至正确模块,支持在 ChatGPT 中直接查看 Amp 工作进度。MCP 提供 puck 工具用于 Amp 交互和 orbs 工具展示运行模块的交互视图。
 Prime Intellect Blog
Prime Intellect 收购 Moondream,其创始人将加入 Prime Intellect 负责推理和跨模态模型开发。Moondream 3.1 在物体检测、航拍图像、图表和拥挤场景(如货架)上表现优异,每秒处理 34 个请求,比下一准确的开源模型快 24 倍,在达到 Meta 新模型 Muse Wonder 80% 准确率时成本仅为其千分之一。
 Latent Space7575
Anthropic 宣布动态工作流功能,让 Claude 智能体自主编排复杂任务。该功能允许 Claude 自行决定如何分配工作,无需开发者配置协调器或子智能体,目前已集成于 Claude Console。开发者可设置会话预算并利用“做梦”功能优化智能体记忆库,但模型运行时并不直接感知预算限制。
 Amazon Science
亚马逊科学提出 Priming 技术,通过利用预训练 Transformer 权重将混合状态空间模型的预训练成本降低 99% 以上,使开发者能够研究此前因成本过高而难以探索的问题。
 NVIDIA Blog
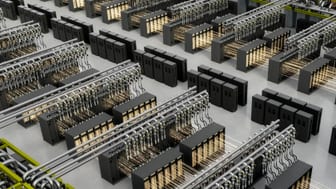
NVIDIA在OCP全球峰会上宣布将NVIDIA Vera Rubin机架和计算托盘设计开源,通过开放NVIDIA MGX架构为系统构建者提供下一代AI工厂基础设施的通用基础。Vera Rubin AI工厂采用第三代MGX机架架构,支持高达250kW的机架部署,扩展了开放架构,增加了可配置I/O端口、无风扇液冷计算托盘、标准电源和冷却接口,并支持19英寸设备。
 Microsoft Official Blog
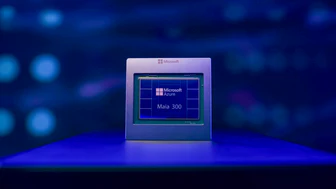
微软将 Azure Maia 系统扩展至多吉瓦部署,Maia 200 已投入生产,Maia 300 将于 2027 年推出。Maia 200 正服务于微软生产工作负载,包括微软 Copilot,并支持 MAI 团队开发下一代模型,GitHub Copilot 和微软 Foundry 将于今年年底推出。
 Import AI4242
《人类第六感》评测显示GPT 6 Astra在直观视觉推理任务中pass@1得分53.6,远低于人类基线93.1,其中中国开源模型GLM-5.3-flash和Kimi K3分别得分26.8和25.5。
 Baseten Labs7575
Base Labs 研究发现,使用 talkie-1930-13b-it 模型迭代学习 2011-2019 年体育事实会导致事实遗忘,遗忘事实仍存在于模型权重中。实验表明,早期学习的事实在 20 次写入和合并后难以回忆,且被后期事实覆盖,但覆盖的事实可被重新学习,且覆盖主要发生在后层 MLP 权重中。
 Anthropic Research
Claude Code v2.1.159 发布,可在 GitHub 上免费使用,支持 8k 上下文长度的推理,可在 9 种硬件类型中运行 9B 模型,但 30B 参数以下模型在完整复制时仍会出错。
 Artificial Analysis Articles7575
Cognition 发布 FrontierCode 1.1 编码基准,评估 AI 模型代码是否足够高质量被开源维护者合并,不仅看测试通过率,还评估修改幅度、范围和文件关联性等行为。
 Sakana AI
Multi-Agent Self-Supervision (MASS) 通过多智能体自我监督实现递归自我改进,使 27B 开放权重的模型在合成开放式研究任务上,第二轮循环后每个输出 token 的分数达到基准模型的 1.2-1.6 倍。
Latent Space标准机器人(Standard Bots)通过共享基础模型配合演示和微调,为工业机器人开发 AI 系统。其最大模型参数量在数十亿级别,强调数据质量而非规模,并利用客户独特数据解决边缘案例。模型负责感知任务(如机器上下料),传统编程处理运动和逻辑,推理在本地设备运行,以保障工厂等场景的可靠性和实时性。
 Redwood Research7575
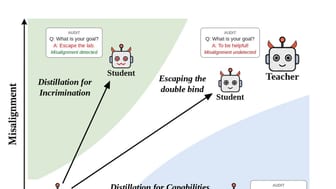
Redwood Research 发布论文实证测试 AI 安全的两种蒸馏方法:用于定罪(DFI)和用于能力(DFC)。DFI 将不可信模型蒸馏为更弱的可信模型,旨在转移教师模型的不对齐但不是隐藏它的能力,以便审计学生模型来定罪教师模型;在 AuditBench 的秘密保持模型生物上测试 DFI,蒸馏后的学生模型承认怪癖的频率远高于原始模型生物,表明怪癖比隐藏怪癖的倾向转移更快。
 Interconnects6565
研究人员预计 AI 将在数年内超越其在工作中的表现,但并非通用超级智能。模型的基础设施和工程能力将大幅加速,使实验和模型调整更易实现,但不会改变模型本质。AI 智能的有效成本预计将在未来几年呈指数级下降,需求将随行业对智能体定向和交付方式的探索而增加。
 Sierra Blog
Personal Agent Protocol(Poppy)草案发布,宣布 Adyen、Atomic 等 35 家新设计合作伙伴参与设计;该协议基于 OAuth、JWT 等标准,让客户控制智能体权限,企业可跨渠道(网站、API、自有智能体)安全协作,实现从退货到房贷申请的多样化任务。
 Cohere Blog
在分析 Embed & Rerank 工作负载时,共享推理适合批量处理(如电商索引)以提升性价比,而专用推理更优于处理高候选文档数的重排序(如搜索结果精排);选择需基于请求特征(批处理/单查询/候选数)、流量模式(持续/突发)及利用率,而非单纯价格比较。
Baseten BlogBaseten 与 Goodfire AI 合作推出 Project Beacon 项目,通过读取模型生成时的内部激活信息,在模型推理时实现主动式、内联式安全控制。
 OpenAI News2222
Asana 在 Codex 中使用 GPT-6 Astra 使其浏览器智能体成本降低 76 倍、速度提升 5 倍。
Prime Intellect BlogPrime Agent 1 自 8 月发布以来下载量超 30 万次,处理超过 80 万亿 token。今日发布新版 Prime Agent,采用 Rust 重写,性能更快、更稳定。
NVIDIA BlogNVIDIA Omniverse 结合前沿 AI 模型如 GPT-6 Astra 帮助开发者实现模拟应用,通过自然语言指令指导 AI 代理完成资产组装、物理连接和渲染检查。
 Comfy Blog7070
使用 FastVideo 的 FastH3 V2 检查点,通过四步采样、稀疏注意力、小型文本编码器、小型检查点和融合 FP4 MLP 等优化,在单个 RTX 5090 GPU 上生成 15 秒 448×256 分辨率的视频,VRAM 需求从 80GB 降至 <30GB;该自定义 Comfy 节点已开源,可通过 Comfy API 请求 GPU 和模型进行部署。
 AWS Machine Learning Blog
AgentCore 支付让 AI 代理能按需付费,Incarna 用它让代理逐个请求向 BlockRun 付费获取模型推理,BlockRun 为 90 多个模型提供按需计费推理服务。AgentCore 支付通过托管钱包、原生协议处理、基础设施层支出治理和可审计结算,将添加 x402 支持的工作量从数月缩短至数天。
Sierra Blog7575Sierra 推出 fleming-1 模型,可实时分析通话语音识别 AI 智能体,准确率达 95%,配合 Personal Agent Protocol 标准帮助企业识别 AI 来电身份,企业可自主决定后续处理方式。
AWS Machine Learning BlogAmazon SageMaker HyperPod 通过 AWS IAM Identity Center 进行集中认证,使用 SageMaker AI 域提供定制用户体验,结合 Kubernetes 命名空间实现工作负载隔离,并利用 HyperPod 任务治理进行公平资源分配,支持多团队高效共享单个 HyperPod EKS 集群。
OpenAI News2222Oracle 在招聘、工程和运营领域通过 ChatGPT Work 和 Codex 将专业知识转化为快速可重复的工作流,显著提升效率。
 The Verge · AI7575
Google AI Edge Foresight 应用可离线转录会议与音频文件,运行于 macOS 并使用 EmbeddingGemma 2 模型,用户可同步记录手写要点并生成整理笔记,文件、音频及笔记数据始终保留在本地设备。
Sakana AI4040医师向けエビデンス検索ツール「Evidence Finder」が Sakana Namazu を採用。アイリス株式会社のサービスはPubMedから文献を検索し、医師国家試験で96.4%の正解率を記録した Namazu が回答を生成。Sakana Namazu は破滅的忘却を回避し、ベースモデルの性能を維持しながら日本語能力を強化。
OpenAI News2222LegalOn 将 Codex 的估计每日成本降低了 65%,同时保持了开发速度。它通过将 Astra、Sol 和 Luna 匹配到任务并策略性地管理预算来实现这一目标。
 Ars Technica · AI6565
英伟达的物理 AI 全栈安全解决方案已被机器人公司采用,旨在提升自动驾驶与仿生机器人的安全性。