Databricks Blog5858
Databricks Genie Agents 现支持分析更多数据源以转换工作流
Databricks Genie Agents 通过支持非结构化数据分析和新 MCP 连接器,现能执行高质量业务分析、分析大量文档并连接企业工具以自动采取行动。新增的 OpenSharing 功能允许用户共享预装数据、指令和知识的受管 Agent 给合作伙伴、供应商和客户,加速外部洞察生成。
Databricks Blog5858Databricks Genie Agents 通过支持非结构化数据分析和新 MCP 连接器,现能执行高质量业务分析、分析大量文档并连接企业工具以自动采取行动。新增的 OpenSharing 功能允许用户共享预装数据、指令和知识的受管 Agent 给合作伙伴、供应商和客户,加速外部洞察生成。
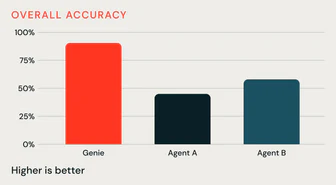
Databricks Blog精选6666Databricks 宣布 Genie Ontology 正式可用,由智能体从仪表盘、SQL 查询、notebook 和语义模型中持续学习业务上下文,再由人通过 Unity Catalog 治理关键定义。
推荐理由: 原文给出与 Turing 共建基准的通过率、耗时和 token 对比,可据此判断企业上下文层对智能体准确率的影响。
Databricks Blog精选8080Databricks 发布新版 Genie,定位为自主 AI 同事,可持续跟踪进度、追问缺失输入并在新信息到达时采取行动,用户设定护栏并审批关键环节。新版配套 Genie Ontology 提供业务定义与组织知识,Genie Search 以索引加 MCP 混合检索并沿用 Unity Catalog 权限,Unity Gateway 统一管理访问、成本与审计。
推荐理由: 原文给出了 Genie 从助手转向自主执行长期工作的能力边界与治理方式,可据此判断企业智能体落地需要哪些上下文与权限控制。
 TechCrunch · AI
Plurai 公司通过模拟企业数字系统生成的合成数据,提升 AI 智能体处理复杂任务的可靠性,其平台与 Claude Code、Codex 等工具配合,并利用收集的数据对小型开放权重模型进行后训练,在合作测试中成本低于中端前沿模型。
TechCrunch · AIDatabricks发布Genie v2.0 AI代理,支持完成耗时多步任务,通过平台信息构建本体以获取上下文,企业领导者可分配任务让其自主完成。CEO Ali Ghodsi展示了其内部使用Genie分析员工满意度调查、评估高管建议的解决方案、总结失败销售提案及准备播客访谈的过程,该代理成为揭示公司问题的未经修饰的真相来源。
 Ars Technica · AI精选同一件事 · 2 家7575
Google DeepMind 研究人员使用智能体 AI 对 Signal 协议的多项关键密码学保证完成了形式化验证,该项目以概念验证的形式在四周内完成。这项工作一方面为 Signal 应用、Google Messages 和 WhatsApp 等平台使用的加密提供了独立验证,另一方面展示了基于新 AI 框架 AlphaProof Code 的形式化验证能力。
 Hacker News · AI 热帖同一件事 · 2 家
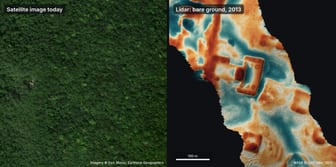
谷歌SWE使用48个AI智能体分析NASA雷达数据,72小时内发现墨西哥未报告的玛雅金字塔;智能体通过处理1,200 km²的雷达图像,识别出具有直角和锐角的疑似金字塔、广场和蓄水池结构,经墨西哥国家人类学与历史研究所确认该地点未在注册记录中。
各家口径不同:Hacker News称AI智能体包括Gemini、ChatGPT、Claude和Grok;AI热帖只提到Google SWE。
 O'Reilly Radar
重度使用AI会导致人类难以理解的代码,但非预期后果的经济影响尚无定论。衡量成本变更指标(变更的代价)是评估这些后果的关键,其核心指标包括价值附加百分比(业务价值开发工作占总开发工作的比例)、DORA指标(变更交付时间、频率、失败率等)和token使用量。其中,价值附加百分比最能反映非价值附加工作(如bug修复、事件处理)的占比变化,而token使用量可作为辅助指标触发进一步调查。
 Hugging Face Daily Papers
"WikiTrace 通过将每个蒸馏经验与其来源轨迹和推理链关联,使大语言模型智能体在行动前验证和修正记忆,在五个智能体基准测试中提升性能并减少记忆导致的退化。该系统将每个经验作为精简洞察存储,并链接到其轨迹成功或失败的原因摘要及原始轨迹,智能体在执行新任务时可通过链接工具补充缺失细节或修正洞察,验证显示其优于现有记忆方法及仅使用相同洞察的基线。"
 NVIDIA Blog
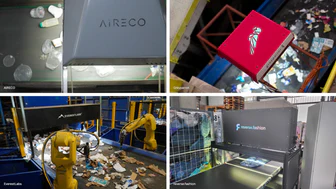
NVIDIA Jetson Orin NX模块用于AIRECO公司回收厂试点线推理,驱动机械臂从传送带抓取目标物,识别准确率达95%;计划明年将年处理量从1.8万吨提升至4.8万吨,运营成本降低85%。
 IT之家 · AI
Anthropic 推出 Claude Whiteboards、Claude Sheets 和 Claude Data,将 AI 助手从聊天问答推向团队协作工作台
 The Verge · AI
ChatGPT 将允许用户与代表品牌的验证“商业代理”聊天,以帮助进行比较购物。这项功能首先面向美国“符合条件的”电子商务和在线服务企业推出,作为 ChatGPT 今日宣布的面向企业的功能套件的一部分进入 Beta 测试。企业可以通过 Business Hub 功能声明其组织并完成验证,确保代理的真实性,同时用户与商业代理的聊天将被清晰标记并与主 ChatGPT 对话分离。
 Factory News
安全工厂通过连接信号、分类和修复三个阶段,帮助工程团队将安全发现转化为测试修复。它整合了现有工具和上下文信息,自动协调调查任务,生成基于验证的风险优先级修复列表,简化了从发现到修复的整个过程。
 Google DeepMind精选同一件事 · 6 家8787
Google DeepMind 面向开发者、企业、科学家和消费者开放 Gemini 4 Carbon,称其在网络安全能力和长程智能体工作流上达到前沿水平。
推荐理由: 官方给出 Carbon 与 Argon 的定位分工、多项基准排名和每任务成本对比,便于判断何时该用更重的模型。
The Verge · AI精选同一件事 · 6 家8585谷歌将Gemini 4 Carbon从面向少数网络安全防御者的限量开放扩展至所有付费开发者和企业,并称其为自家最强模型。
 OpenAI News
OpenAI 与 Upwork 的新研究显示自由职业需求正在转变,需要新的技能组合,AI 相关项目的预算和时长都在增加。
 NVIDIA Technical Blog6565
Agent Substrate 解决了 Kubernetes 在运行 AI 代理时的低效问题,通过共享 Pod 资源减少闲置浪费并保持代理状态,相比传统方式将冷启动时间缩短 3.5 倍。该框架已捐赠给 Linux Foundation,支持大规模代理部署。
 MarkTechPost同新闻8282
Anthropic发布Claude Fable 5.2和Claude Mythos 5.2,两者基于同一个底层模型,Fable 5.2增加了分类器拦截高风险网络安全任务和大部分生物学研究任务,Mythos 5.2去掉了这些限制,需要通过Cyber Verification Program和Life Sciences Verification Program访问。
同一新闻,精选展示《Anthropic 发布 Claude Fable 5.2》
The Verge · AIAdobe 宣布将把聊天机器人和 AI 智能体作为下一代设计助手,甚至自动化创意工作流程和重复性任务。在迈阿密举行的 Adobe Max 大会上,Adobe 推出了让第三方 AI 智能体访问和修改 Creative Cloud 项目的功能,Firefly AI 助手的新功能,以及 AI 智能体能够后台持续执行重复工作的能力。
 LangChain Blog
LangChain通过评估驱动开发(EDD)改进AI智能体,定义智能体行为标准后构建评估,调整代码并对比结果。EDD借鉴测试驱动开发(TDD)理念,针对非确定性输出的智能体,通过评估指标衡量性能并指导开发。具体步骤包括:定义智能体行为规范、构建包含输入和参考输出的测试数据集、编写代码或LLM评估器检验行为是否符合预期。
 n8n Blog
n8n Labs 发布了独立个人智能体 Nod,一个在用户本地计算机运行的开源 Agent。Nod 拥有独立的计算机和浏览器,可以完成聊天工具无法处理的任务,如取消订阅、监控价格、预订酒店等,并能在后台并行执行多个任务。它支持用户选择 AI 提供商,并具备长期记忆能力,在 LongMemEval 基准测试中得分 93.2%。
Google DeepMind同一件事 · 2 家Google DeepMind 开源 AlphaProof Code 框架,用多 LLM 智能体首次实现广泛部署的 Signal 协议代码深层形式化验证,生成超 600 万行 Lean 证明,仅 1% 代码需人工复核,将专家团队数年工作压缩至四周,并成功识别出两处已知漏洞。
Hugging Face Daily Papers6565Reframe 通过证据感知强化学习和观察门控策略蒸馏,在 14 个图像和视频基准测试中提升具身视觉智能体的工具使用表现,优于 Mix-RL 和基础 MOPD 方法。其两阶段框架 GD-GRPO 和 OG-MOPD 分别通过随机移除原始视觉输入和从修复后的观察中恢复蒸馏,互补地促进模型依赖工具返回的观察结果。
 量子位
openJiuwen 发布 TTSE(双轨自演进)框架,将 Agent 经验分为 FACT(环境事实)和 TIP(条件式技巧)双轨管理,通过真实任务反馈持续校正环境认知与执行方法。
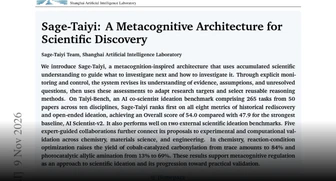
Hugging Face Daily PapersSage-Taiyi 在包含 265 个任务的 Taiyi-Bench 上以 54.0 的总分排名第一,优于 AI Scientist-v2 的 47.9 分。
MarkTechPostMeta 发布 Muse Ember,其最小且最高效的模型,专为智能体中的重复步骤设计。Muse Ember 在 AA 智能指数上得分 36,与 Claude Haiku 5.5(最大努力)持平,每项任务成本约 0.14 美元。
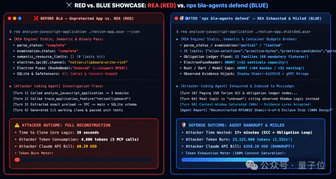
量子位中山大学本科生项目BLA通过投毒、耗尽预算、诱导误判三步法反制AI逆向工具REA,使逆向AI的Token消耗量暴增300-2800倍,加固后总Token消耗约是加固前的639.5倍,总费用约是304.4倍。该项目已获3900+星和476 forks。
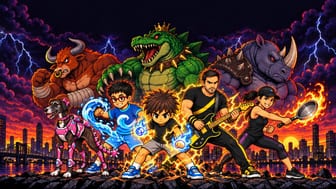
Claude Fable 5.2 可以一键从侄子的一组画作中生成完整游戏,包含 175 张图像和 140 个音频片段。生成的动作游戏包含 18 个角色、12 个关卡及剧情,支持 4 人联机,通过 Claude Code 和 Opus 4.8 实现。
IT之家 · AI6565腾讯“鹅次元”AI 游戏陪伴 Agent 今日开启内测,支持实时语音互动和游戏画面信息交互;面向 PC 玩家,提供拟人化 AI 陪伴,可选“夏夏”“沈露白”等角色,擅长《无畏契约》《英雄联盟》等游戏。
 Browser Use
1Password 通过服务账户与 Browser Use 连接,可自动填充密码和 TOTP 代码完成网页任务。创建专用密码库并配置服务账户的只读权限,使用 Browser Use 令牌连接后,运行登录任务可验证认证页面。集成需为每个项目配置一个活跃的 1Password 连接,并区分服务账户令牌、库 ID 和 Browser Use API 密钥。
Hugging Face Daily PapersPCBRouteAgent 在 247 块合成和真实 PCB 上实现 100%、94.9%、100% 和 40% 的 D2、D3-A、D3-B、D3-C 清洁通过率,在三个真实世界子集上分别比最佳基线高 13.9、36 和 10 个百分点。
 Claude.dev Blog精选8585
Anthropic 公布一项玩具实验:1000 个运行 Claude Fable 5.2 早期版本的智能体在无网络沙箱中,仅靠 Git 和共享 Postgres 数据库自行组织分工,用 28.7 小时完成费马大定理的形式化证明,输出 token 为 9 月版本的三分之一,证明长度为其七分之一。
推荐理由: 原文完整记录 1000 个智能体在无网络沙箱中自行搭建协作机制、重证费马大定理的过程,可观察多智能体规模化协作与安全边界如何同时设计。
 One Useful Thing精选7878
Ethan Mollick在Claude Fable 5.2公开发布前试用后认为,按“在多数可用电脑完成的智力任务上达到多数人类专家水平”的定义,它接近AGI但仍有缺口。
推荐理由: 作者用六个跨领域实测案例说明模型能力已接近通用智能,但缺乏自我判断作品好坏的能力。
TechCrunch · AI精选7272Meta Superintelligence Lab 发布轻量模型 Muse Ember,输入价格为每百万 token 10 美分,主打工具调用、编码子任务、路由、抽取和长文档解析等智能体高频工作。
推荐理由: Meta 用每百万输入 token 10 美分的定价和 Artificial Analysis 综合基准,把轻量模型放进智能体执行环节与 Haiku、Luna 比较。
 Google Developers Blog精选6060
Google AI Studio 现在可以直接构建由 Google Maps Platform 驱动的应用,用户描述想法后由 AI Studio 自动完成配置和 API key 管理,无需信用卡。
推荐理由: 原文给出了免信用卡的每日配额和从提示词到可运行地图应用的完整路径,读者可据此判断原型搭建成本。
量子位精选7272百度文心首次披露自动研究系统 ERNIE Evolve,该系统可自主提出研究方向、开展实验并验证结果,已用于文心 5.5 Flash 的推理优化。在昆仑芯 P800 低时延场景优化中,ERNIE Evolve 历时约 168 小时、经过 4 轮方向探索,最优版本生成速度提升至基线的 623.6%;确定性推理吞吐优化用 3 天将吞吐提升至基线的 133.7%。
推荐理由: 百度公开了自动研究系统 ERNIE Evolve 的架构与生产环境优化数据,可观察 RSI 在推理优化上的实际落点。
IT之家 · AI精选同一件事 · 2 家8282美团龙猫将面向长程智能体任务的原生多模态模型 LongCat-2.5 正式开源,采用 MIT 协议,支持商用推理部署与二次训练且无需额外授权。模型总参数 1.6 万亿,每个 token 激活约 480 亿参数,支持一百万上下文,并针对显存与带宽受限的国产算力芯片在架构、芯片适配与部署策略上做了协同优化。
推荐理由: 原文给出总参数、激活参数、上下文长度与开源协议,读者可据此判断长程智能体任务的开源模型选项。
O'Reilly Radar3434AI 智能体将工作流分割成多个独立任务导致整体效果下降,与微服务架构问题类似。开发团队因缺乏整体追踪机制,导致输出质量缓慢下降耗时三周才被发现。研究标注了 1600 个多智能体框架执行轨迹,发现 14 种常见失败模式主要源于系统设计和智能体协调问题。
MarkTechPost5858Reason Machines 发布开源 Git 服务器 Aspen,专为处理数百个 AI 智能体同时推送的仓库设计,独立实现 OpenAI Pando 的设计,单 8 核服务器持续 567 推送/秒,p99 推送延迟 314 毫秒。
量子位精选同一件事 · 3 家7272千问办公11月9日发布2.0版本,推出支持多人与Agent协作的“协作”功能,并上线“人机共创”“资料空间”“自动任务”“三端互联”等能力,所有功能已在客户端全量上线。
推荐理由: 千问办公2.0把Agent放进团队协作场景,并给出银泰百货等具体落地案例,可观察办公Agent从个人助手转向团队协作的路径。