AWS Machine Learning Blog3434
在 Amazon SageMaker JumpStart 上部署 OpenFold3:预测生物分子结构
OpenFold3-preview 可在 Amazon SageMaker JumpStart 上部署,该开源生物分子结构预测模型由 OpenFold Consortium 和哥伦比亚大学的 AlQuraishi Lab 开发,支持蛋白质、DNA、RNA、小分子配体及其复合物的 3D 结构预测。
AWS Machine Learning Blog3434OpenFold3-preview 可在 Amazon SageMaker JumpStart 上部署,该开源生物分子结构预测模型由 OpenFold Consortium 和哥伦比亚大学的 AlQuraishi Lab 开发,支持蛋白质、DNA、RNA、小分子配体及其复合物的 3D 结构预测。
 Hugging Face Blog
使用 UR17G 手臂、Robotiq 2F-140 夹爪和饮料罐在 Isaac Sim 中构建抓取放置模拟,需检查关节、运动和接触行为。SimReady Central 提供资产模型和模拟设置,并使用 GPT-6 Sol 生成任务代码。
Hugging Face Blog精选6565llama.cpp 与 ggml 发布 v1.0.0,将公共 C API 的破坏性变更与主版本号绑定,后续两者都按语义化版本规则发布。项目已支持超过 150 种模型架构和主流投机解码方法,并提供 Linux、macOS、Windows、Android、iOS 的预发布产物及 Docker、Homebrew、conda-forge 等分发渠道。
推荐理由: llama.cpp 与 ggml 同步发布 v1.0.0,并明确主版本号对应 C API 破坏性变更,下游依赖者可据此规划升级节奏。
 蚂蚁 inclusionAI · Hugging Face 新模型
inclusionAI 发布 Duo 1.0 causal-base 模型,这是一个用于实时音视频交互的全双工多模态世界模型,包含实现权重和主干、意图模型和适配器、音视频编解码器、语音识别器和强制对齐器。该模型权重基于 MiniMax H3 初始化,并已开源。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI 发布 FP8-量化四步蒸馏的 Duo 1.0 Realization 权重,用于其因果基础模型,支持全双工实时音视频交互,需与因果基础模型权重叠加使用。
 vLLM Blog
DeepSeek-V4.1-Flash 在单台 NVIDIA Vera Rubin NVL72 机架中实现每 GPU 1.7M tokens/s 的服务能力,单个用户达 387 tokens/s,较 GB300 NVL72 提升 58 倍。
Hugging Face BlogHugging Face 发布用于微调 3D 生成模型 TRELLIS.2 的脚本和容器,支持本地或 Hugging Face Jobs 部署,通过 LoRA 技术仅微调结构预测和几何生成阶段,以提升特定任务(如鞋类)的精度。
Hugging Face Blog3838Hugging Face 博客介绍了多向量嵌入模型的 Token Pooling 感知训练方法,通过 HierarchicalTokenPooling 将相似 token 嵌入合并以压缩存储。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI/ZoomGain-4B-GGUF 是一个 175B 参数的多模态模型,支持图像输入,使用 FP16、Q8_0 和 Q4_K_M 精度量化。模型包含语言模型和 mmproj 视觉编码器/投影器,通过 llama.cpp 转换为 GGUF 格式。提供 llama-mtmd-cli 命令行推理和 llama-server 网络聊天功能。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI/ZoomGain-9B 的 GGUF 格式权重已发布,使用 llama.cpp 转换,语言模型为 FP16、Q8_0、Q4_K_M,视觉编码器和投影器(mmproj)同样采用该量化方案。需同时提供语言模型和 mmproj 文件进行图像输入,支持 CLI 推理(llama-mtmd-cli)和 Web Chat(llama-server)部署。
蚂蚁 inclusionAI · Hugging Face 新模型Sing VL S1 是一个基于 Qwen3.5 的多模态决策模型,可对文本或 JSON 及最多四张图像回答命名问题,每个问题使用单个 Transformers 前向传递评分选项,在 43 个文本数据集和 11 个视觉数据集上表现优异,支持 Python 3.12 和 PyTorch 推理。
Hugging Face Blog用户现可通过 Google Cloud Marketplace 将 Hugging Face 组织与 Google Cloud 账户关联,使 Hugging Face 使用量计入 Google Cloud 账单而非信用卡支付。
Hugging Face BlogHugging Face 探索决策模型在非文本生成场景的应用,如将 LLM 用于客户支持系统处理退款请求,模型直接评估选项并返回概率分布而非生成文本。决策模型输入状态和问题,输出结构化决策及概率,优于 LLM 直接生成 JSON 的方式,后者可能不遵循请求模式且效率低。决策模型与分类模型不同,前者输出类别可动态调整,后者输出类别固定且需重新训练扩展。
 Claude.dev Blog
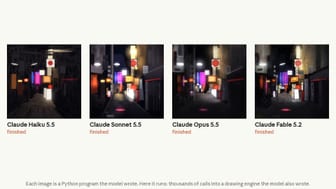
Anthropic 推出四种 Claude 模型供用户选择:Claude Haiku 5.5、Claude Sonnet 5.5、Claude Opus 5.5 和 Claude Fable 5.2。
Hugging Face Blog4545HOPE 方法通过考虑专家间的二阶交互,在混合专家语言模型中实现了更优的剪枝效果,50%剪枝率下在 agentic coding 任务上比次优方法提升 6.1%。该方法基于 Qwen3.5-122B 等模型验证,每个 MoE 层有 256 个专家,剪枝后可减少约 250 GB 内存占用,且与量化兼容。
Hugging Face Blog5858Hugging Face 发布 ToyBlocks 框架,为机器人学习与评估提供受控的模拟环境。该框架支持自动生成任务与训练演示,并包含衡量机器人行为随时间变化的指标,旨在研究模型如何随更多训练数据改进,以及如何结合高级推理与精确物理控制。
Hugging Face BlogHugging Face Open ASR 排行榜新增埃及英语和尼日利亚英语的 Liva AI 私有数据集,包含 1.34 小时和 1.55 小时的对话语音,用于提升 ASR 评估的代表性及可信度。排行榜现支持基于 Kachru 三圈模型的更细致口音分类,涵盖 US 与非 US、内圈与外圈/扩展圈等分组。
Hugging Face Blog精选7171NVIDIA 在 Cosmos 世界模型平台下新增四个 Cosmos 3 开源权重检查点,均为 Cosmos 3 Nano 的后训练版本,含 16B 可训练参数,采用 OpenMDW1.1 许可,允许商用与非商用。
推荐理由: 原文给出四个开源权重检查点及四阶段后训练配方,读者可据此判断如何把世界模型适配到自有传感器与机器人本体。
Hugging Face Blog精选7272Phonon 发布可在本地设备运行的小型 TTS 模型,无需服务器和网络,提供约 65 MB 和 75 MB 两个版本,覆盖英语、法语、德语、西班牙语和葡萄牙语。
推荐理由: 原文交代了端侧 TTS 的模型规格、开源许可与榜单表现,可据此判断小模型在本地语音场景的可用边界。
Hugging Face Blog精选6565Dharma-AI 发布 Dharma Field Extractor,一个 2B 参数模型,输入文档图像和可选 schema,输出带类型的结构化 JSON,支持开放抽取与按 schema 定向抽取,未出现的字段返回 null。
推荐理由: 原文给出自建基准上的质量与成本对比,读者可据此判断小模型专精路线在字段抽取任务上的可行性。
Hugging Face Blog精选6060IBM 研究团队微调 20B 开源权重模型 Palette,采用设计师编写 JSON 简报、编码器逐页生成 pptxgenjs 代码的两角色 LoRA 方案,根据 IBM 设计语言生成幻灯片。
推荐理由: IBM 使用合成数据加检查修复闭环训练 20B 小模型制作幻灯片,提供可迁移到其他结构化产出的方法。
Hugging Face Blog精选6262IBM团队使用同一个开源权重模型GLM-5.3-flash在AppWorld的90个任务上对比CUGA、Hermes和Deep Agents,任务通过率分别为81.1%、46.7%和30.0%,三变体全部通过的场景数为20、8、2。
推荐理由: 同一模型换harness后任务完成率从30%升至81%,文中还给出了可复现的配置与评测入口。
Hugging Face BlogTransformers 支持超过 750 模型类型,其测试套件包含 88,000+ CPU 测试和 200,000+ GPU 测试。Hugging Face 发布 Model Integration Contracts (MIC) 标准,包含压缩模型(如 66 MB 权重的 UMT5 固定件)、可运行示例(如 SmolLM 文本生成)和人工审核基线。
 MiniMax · Hugging Face 新模型
MiniMax-H3-Image 是 MiniMax H3 家族的一款开源图像生成与编辑模型,支持 16MP 图像生成、图像编辑及最多 16 张参考图像,采用 H3 架构并使用 Qwen3-VL 文本编码器,在 Hugging Face 上提供 68.65GB 的 BF16 精度模型权重。
 Moonshot AI · Hugging Face 新模型
Kimi K3.1 Pro 是 Moonshot AI 开源的多模态智能体模型,参数量 2.8T,激活参数 104B,上下文窗口 1M tokens,在编码、3D 创建、金融研究等领域表现优异。与 Kimi K3 相比,采用 Gated DSA 层提升长文本处理效率,在 Terminal-Bench 4.0 等评测中超越 Claude Fable 5.1 和 GPT-6 Astra 等竞品。
Hugging Face BlogProject ProtoStar 项目发布,旨在通过使数据集、模型和代码更易获取和复用,解锁公共资助科学研究的潜力。该项目汇集了大学、研究机构、产业和开放科学社区,支持以 AI 兼容、机器可操作的格式发布科学成果,并通过一系列公开挑战展示其价值。首个挑战由卡内基梅隆大学主办,将于 11 月 2 日启动。
Hugging Face Blog精选8585Mistral 发布多模态 MoE 模型 Mistral Large 4(Le Chonk),约 1T 总参数、49B 激活参数,上下文窗口 1M tokens,提供 FP8 与 NVFP4 两个官方版本,另有 Unsloth 和 llama.cpp 团队制作的 GGUF。
推荐理由: 原文给出 1T 总参数、49B 激活的 MoE 多模态模型在网络安全与编码基准上的具体分数,并附本地与端点部署实测吞吐。
Hugging Face BlogHugging Face 发布 Granite Switch 4.1.1,在 4.1 基础上增量更新,保留完全向后兼容性。新增多语言语音转写模型(支持 10 种语言带原生标点)和 Jev 决策指数测试集性能提升的决策适配器。团队通过仅更新适配器未重新计算基础模型,实现快速部署,未来将支持第三方自定义适配器。
Hugging Face Blog5050Hugging Face 发布开源语音识别 AnySpeechRecognizer 和决策模型 AnyDecisionModel,支持 NVIDIA Parakeet 和阿里云 Qwen3-ASR 等引擎,可在苹果平台本地运行。
Hugging Face Blog精选7878NVIDIA 发布开源权重模型 Nemotron 3.5 Transcribe,把转写、说话人分离、翻译和音频问答合入同一 checkpoint,支持 40 种语言转写、31 种语言与英语互译、13 种语言说话人标注,可处理最长 1 小时录音并标注最多 8 位说话人。
推荐理由: 原文给出多语言转写、说话人分离与翻译的统一权重模型,并附开放数据管线和微调配方,可据此判断语音场景的适配路径。
Hugging Face Blog精选7676Liquid AI 发布 LFM3 新一代 Liquid Foundation Models,以 LFM3-1.7B-Base 为共享骨干派生六个 2B 级模型,覆盖文本、视觉、音频、全模态和决策,全部在 Hugging Face 开放权重。
推荐理由: Liquid AI 用同一 2B 级骨干派生六个模态模型,并给出单卡微调与端侧部署路径,可据此判断小模型专用化路线。
Hugging Face BlogHugging Face 发布 Old Ideas, Novel Problems 研究,评估六款 LLM(GPT-5.1至5.4、Claude Sonnet 4.5至4.6)判断科研创新性的可靠性。
蚂蚁 inclusionAI · Hugging Face 新模型5858inclusionAI/Ling-3.1-flash-1019 发布,560B 参数量,25B 活跃参数/Token,1M 上下文窗口,推理能力提升,AA-Briefcase 分数 1524 Elo,AutomationBench-AA 68%,Artificial Analysis Intelligence Index v4.3.2 44 分。支持 SGLang 和 vLLM 推理。
 腾讯混元 · Hugging Face 新模型精选7171
腾讯混元在 Hugging Face 发布 Hy-Nomas 的 BF16 Diffusers 格式蒸馏权重,该视频世界生成模型支持通过文本指令和相机控制进行多轮自由交互,逐段生成同一世界。
推荐理由: 官方放出蒸馏版 BF16 Diffusers 权重和配套基准,读者可据此判断多轮交互式世界生成的实际用法与门槛。
Hugging Face BlogHugging Face 发布 torch-neuronx 模型支持查询 Space,检测 AWS Trainium 兼容性。该 Space 支持查询 Hugging Face Hub 上 175B 参数规模的主流模型(如 Qwen3-0.6B)是否能在 Trainium 上无修改运行,并提供运行脚本。
Hugging Face Blog精选6666微软与 Hugging Face 发布 ThinkingBox-Training,把 ThinkingBox 对数据库终态的确定性校验直接当作强化学习奖励,用 GRPO 对 Qwen3.8-27B 训练 50 步。
推荐理由: 微软与 Hugging Face 把数据库终态校验直接当作强化学习奖励,并公开了任务筛选与训练代码,可迁移到其他有状态智能体训练。
Hugging Face BlogHugging Face 发布 OlmoEarth v1.3,一款卫星嵌入模型,提供全球预计算嵌入(10米分辨率,64及128维度),用户无需登录或技术知识即可使用。模型在27项评测中表现最佳,128维度嵌入在20项评测中得分最高,64维度嵌入在18项评测中领先。模型训练成本较v1.2降低53%,较v1降低18%,碳排放也相应减少,权重、数据和代码全部开源。
 NVIDIA Newsroom
英伟达与华盛顿大学医学院蛋白质设计研究所联合发布 RFD4-Proteina 开源模型,结合可编程蛋白质设计与搜索能力,在四项基准测试中超越基线模型,帮助科学家探索药物设计候选者。
Hugging Face BlogHugging Face发布IBM Granite时间序列模型集成预测方案,结合四款Granite模型(PatchTST-FM-r1、PatchTST-FM-r2、FlowState-r1.1、TTM-r3)提供无微调的集成预测。
Hugging Face Blog精选7878NVIDIA 发布预训练关系型基础模型 Kumo Relational,可直接在企业数据库上做预测,无需任务特定训练、特征工程或表展平。模型在 15 个数据库的 41 个任务上超过监督式关系深度学习和专家特征工程梯度提升树,在 SAP SALT 基准上 MRR 比 AutoGluon 集成高 8%。
推荐理由: 原文给出预训练关系模型在 41 个任务上的对比结果与开源入口,读者可据此判断它能否替代现有 XGBoost 流水线。