Hugging Face Daily Papers
大型语言模型不知道自己知道什么:对金融回测的时间自我认知进行基准测试
GPT-5 在金融回测中正确回答 76% 的控制事实但声称仅知道 38%,其声称不知道的事实中 61% 仍正确回答。知识声称可延伸至测量知识边界后七个季度。历史日期指令能消除大部分知识声称而不改变准确率。
Hugging Face Daily PapersGPT-5 在金融回测中正确回答 76% 的控制事实但声称仅知道 38%,其声称不知道的事实中 61% 仍正确回答。知识声称可延伸至测量知识边界后七个季度。历史日期指令能消除大部分知识声称而不改变准确率。
Hugging Face Daily PapersPCBRouteAgent 在 247 块合成和真实 PCB 上实现 100%、94.9%、100% 和 40% 的 D2、D3-A、D3-B、D3-C 清洁通过率,在三个真实世界子集上分别比最佳基线高 13.9、36 和 10 个百分点。
 Google Research
 发布 Language Explorer 在线平台,通过可视化与数据呈现全球语言多样性。该工具整合 LinguaMeta 开源数据集,支持 1,000 种语言,旨在帮助研究人员、教育者和爱好者探索语言差异。平台已作为互动装置亮相柏林通信博物馆新展览,并设有线上版本供公众访问。
 Claude.dev Blog精选8585
Anthropic 公布一项玩具实验:1000 个运行 Claude Fable 5.2 早期版本的智能体在无网络沙箱中,仅靠 Git 和共享 Postgres 数据库自行组织分工,用 28.7 小时完成费马大定理的形式化证明,输出 token 为 9 月版本的三分之一,证明长度为其七分之一。
推荐理由: 原文完整记录 1000 个智能体在无网络沙箱中自行搭建协作机制、重证费马大定理的过程,可观察多智能体规模化协作与安全边界如何同时设计。
 Claude · YouTube同一件事 · 2 家5858
Claude Fable 5.2 从一段提示词设计了语音助手中心,包括电路板布局、CAD 外壳建模和固件编写,Diode Computers 根据其设计文件制造了原型板。这是该项目中 Claude 设计的三款设备之一,Anthropic 与 Diode 存商业关系。
各家口径不同:Anthropic Research称Claude Fable 5.2能从设计到原型完成硬件,而Claude提到设计了包含电路板布局、CAD外壳建模和固件编写的语音助手中心。
 NVIDIA Technical Blog6565
NVIDIA Holoscan 5 通过持续计算逆动力学实现重力补偿,使机器人手臂在操作时仅需提供支撑重量的扭矩。该技术支持通过示教学习、物体操作或人机协作的机器人应用,依赖重力补偿回路构建。
 AWS Machine Learning Blog3838
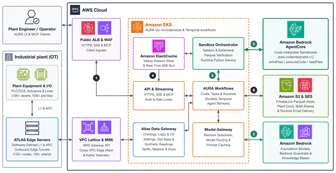
CrossnoKaye 通过其 ATLAS 平台和 AURA 智能体,在 Amazon Bedrock AgentCore 上实现工业物理 AI,将生产提效 11-17% 并降低能耗 21%。AURA 利用 AgentCore 的代码解释器能力,在隔离微 VM 中运行 Python 工作负载以验证数值计算,同时通过边缘集群和云优化系统实现闭环控制。
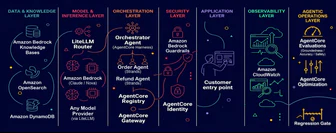
AWS Machine Learning Blog5050亚马逊推出可插拔的智能体 AI 框架,通过七层可组合参考架构将多智能体 AI 应用从原型扩展到生产规模。
 Epoch AI
Nvidia GB300 相比 H100 在智能体推理任务上的能力提升达 25 倍,远超 8 位 FLOP/s 的 2.5 倍增长。IPI 指数通过比较芯片在多种输出速度要求下能同时处理的请求数量来衡量推理能力,GB300 设为基准值 1,得分为 1 的芯片能同等条件下服务两倍用户。IPI 版本 1 结合四款代表性模型结果,采用 GB300 当作参考基准。
 Berkeley AI Research2222
BAIR团队在2026年11月9日至12日于德克萨斯州奥斯汀举行的机器人学习会议(CoRL)上展示多项研究成果,包括33篇主会论文、4个突破性海报、10场口头报告和7场专题演讲,其中教授Negar Mehr将发表早期职业主题演讲。会议涵盖机器人视觉语言行动模型、具身智能体、细粒度操作对齐、后见之明奖励编辑等议题。
 Latent Space5858
Frontier Labs 的 AI 训练业务一年内营收达 10 亿美元。Handshake AI 展示了其在金融、生物和编码领域的智能体评估环境,包括银行邮件处理、脑肿瘤组织图像识别和文件访问模拟任务。VIALS 作为生物领域基准,测试模型对科学图像的理解能力。
 量子位精选7272
百度文心首次披露自动研究系统 ERNIE Evolve,该系统可自主提出研究方向、开展实验并验证结果,已用于文心 5.5 Flash 的推理优化。在昆仑芯 P800 低时延场景优化中,ERNIE Evolve 历时约 168 小时、经过 4 轮方向探索,最优版本生成速度提升至基线的 623.6%;确定性推理吞吐优化用 3 天将吞吐提升至基线的 133.7%。
推荐理由: 百度公开了自动研究系统 ERNIE Evolve 的架构与生产环境优化数据,可观察 RSI 在推理优化上的实际落点。
 IBM Research Blog5252
IBM 将 Praxis Policy Engine (PPE) 作为策略过滤器嵌入开源 AI 代理服务器 Praxis,支持对工具、提示词、模型调用等执行策略控制。
 Hugging Face Blog3838
Elith 和 NVIDIA 发布 Nemotron-Personas-Finance-Japan,这是首个百万记录规模、结合日本官方统计数据与家庭金融和金融素养数据的开放式角色数据集。
Hugging Face Daily Papers3434LowRAM 通过低秩分解压缩键,并使用小头网络根据键预测值,同时保留最难重建标记的残差校正,实现 4 倍值缓存压缩且性能近乎无损。选择性重建可使 262K 上下文在 4 倍 KV 压缩下峰值解码吞吐量提升 5 倍。结合量化和驱逐,LowRAM 将压缩推至 26.9 倍,同时保留 94.5% 的基线性能。
 Import AI4242
Physical Superintelligence 开发的内部研究系统运行非公开 Anthropic 模型,在三天内证明了 Scott Aaronson 和 Andris Ambainis 的量子计算猜想。
Hugging Face Blog4545HOPE 方法通过考虑专家间的二阶交互,在混合专家语言模型中实现了更优的剪枝效果,50%剪枝率下在 agentic coding 任务上比次优方法提升 6.1%。该方法基于 Qwen3.5-122B 等模型验证,每个 MoE 层有 256 个专家,剪枝后可减少约 250 GB 内存占用,且与量化兼容。
Hugging Face Daily Papers3434P²-MOPD通过将每个学生模块表示为其自身可学习权重与冻结专家任务向量(专家减去基础模型)的加权求和,联合训练权重和混合系数α,使专家成为参数先验,显著加速多教师策略蒸馏。
Hugging Face Daily Papers3131智能体进化通过递归自我改进(RSI)提升性能而不更新模型权重,但高基准分数并不总带来可靠、高效和可迁移的改进。研究评估了四种方法在通用和编码任务上的表现,发现所有十六个进化智能体都获得了新任务能力但丢失了部分旧能力,其中一种通用任务智能体可靠性提升5.2点但丢失了十个旧任务。EvoAudit通过分析、变异和门控机制实现了最佳性能。
Hugging Face Daily Papers6565LongBanana是首个专家设计和验证的长上下文多参考图像合成基准,包含90个精心设计的任务,每个任务约含32张参考图像、20个约束和50个评估项,共4,670个专家指定的原子评估项。
Hugging Face Daily Papers3535SplatAnything 实现了高斯间距归一化,用于任意场景的前馈 3DGS。模型在 MMLU 基准上达到 0.8264 分数。代码已开源。
 MIT News · AI5252
WorldParticle 模型能模拟从滑动的沙子到折叠的蛋白质等多种物质行为,通过将物体分解为数千或数百万个三维粒子并使用神经网络预测其运动,无需为每种物质和过程编写特定方程。该模型在模拟可变形物体、颗粒材料和蛋白质等方面比数值模拟方法精度更高,并可通过合并技术优化计算效率。
Hugging Face Daily Papers6060Claude Opus 5.5 结合 Claude Code 与 GPT-6.1 Sol 在 HEELO 框架下处理 46 项真实任务时,单独完成 9 项,通过 MCP 服务器连接完成 39 项与 35 项,耗时分别减少 1.9 倍和 2.3 倍,成本降低 1.55 倍
 IT之家 · AI同一件事 · 2 家6565
Anthropic 发布研究报告显示,科学家主要将 Claude 用于数据分析和写作,收集数据、生成研究假设则较少使用 AI。研究基于 2026 年 8 月至 9 月 20.7 万次科研会话数据,其中计算机科学、数学和统计学领域使用比例最高,数据分析占 Claude 科研会话的 33.7%,写作与沟通占 32%。
Latent Space6565斯坦福大学 CS146S 课程的第二次运行将开源维护者引入教学,要求学生学习陌生代码库、提出变更并解释补丁。Mihail Eric 教授分享了课程大纲,展示了哪些课程内容经受住了他自身工程团队的考验。Monaco 公司构建了其智能体工作空间,采购了代码审查工具,并为值班智能体授予了 Datadog 和 GitHub 的访问权限。
Latent Space4242斯坦福大学 CS146S 课程将作业改为贡献开源项目,让学生使用 AI 代码审查工具并学习协作;Monaco 公司采用 Devin 代码审查工具,同时自建 Agent 工作空间以保持技术自主,并开发 Hal 系统,让工程师和销售人员都能通过 Agent 解决问题。
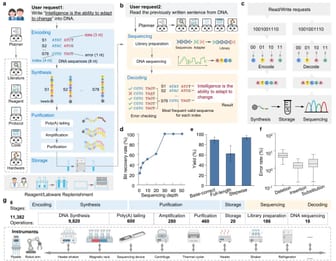
IT之家 · AI精选7575上海交通大学陈海波、王肇国团队与樊春海、王飞团队合作构建 AI 原生科学实验室 AutoDNA 装置(思源一号),实现自主分子生物学实验操作,成果发表于《自然》并获官网首页头条报道。
推荐理由: 该研究把多智能体架构与仪器原子服务结合,让 AI 自主完成分子生物学实验,可作为 AI 原生实验室架构的参考。
 MarkTechPost3838
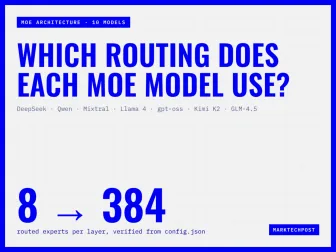
DeepSeek-V4-Pro、Qwen3.6-35B-A3B 等十款开源 MoE 模型在专家计数(8B-384B)、top-k(1-8)、共享专家(7/10 模型保留)、评分函数(Sigmoid/sqrtsoftplus)和负载均衡(Aux loss/bias)等五个方面存在差异。
 The Decoder精选同一件事 · 2 家7171
阿里巴巴与多所亚洲高校的研究者用真实用户变更请求构建了编码智能体基准 Co-Design Bench,十个受测模型中表现最好的 GPT-6 Astra 平均满足约 70% 的任务要求,但完全正确的任务仅占 26.4%。
推荐理由: 由真实用户请求构成的基准显示,最强模型仅完全解决约四分之一任务,且同一模型换环境分数相差近 20 个百分点。
MaxxBench 团队对 89 个 DeepSWE 任务做小幅改动(参考补丁中位数仅增 17 行、3.5%),重新评测 15 个模型配置,发现最高与最低分差从 DeepSWE 的 20.9 个百分点扩大到 48.3 个百分点。
推荐理由: 通过改写 89 个 DeepSWE 任务的指令与起始代码,展示模型分数在熟悉基准与改动后任务间的巨大落差。
MarkTechPost3838MoE 路由策略决定每个 token 由哪些专家处理,影响模型质量、负载均衡和部署成本。Mixtral 使用 Softmax Top-K 选择 2-8 个专家,DeepSeek-V4-Pro 选择 384 个中的 1-8 个,通过 Sigmoid 门控和辅助损失实现负载均衡,其中 Sigmoid Scoring 配合无损失的偏差平衡是 2026 年前沿开放模型的常用方案。
IT之家 · AI6767OpenAI GPT-6.1 Sol 在活体小鼠脑部手术中连续操作三次,通过外科医生反馈改善定位表现,耗时从 169 秒缩短至 86 秒,定位误差从 0.6 毫米降至 0.3 毫米,误差下降 50%。研究团队让模型参与小鼠头骨表面 Bregma 和 Lambda 两个关键解剖标志的定位任务,每次操作后保存图像、数据及修正记录供后续参考。
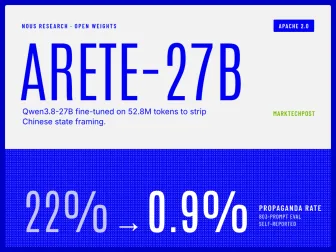
MarkTechPost同一件事 · 2 家5858Nous Research 发布了 Arete-27B,一个 27B 参数的开权重量化模型,通过监督微调移除 Qwen3.8-27B 中的中国宣传内容,在 803 条提示符评估中,宣传内容占比从 22% 降至 0.9%,同时保留了 Qwen 类的智能体技能且不受政治立场影响。
Hugging Face Daily Papers6565VisSearch-Bench 评估了 16 个多模态模型在 204 项人类编写的视觉搜索任务上的表现,这些任务要求整合视觉上下文与外部信息,结果显示最佳系统仅完全解决了 26.47% 的任务。该基准涵盖集合式视觉搜索、序列式视觉搜索等 7 个主要领域,通过准确率与过程分评估任务完成度与推理步骤的正确性。
The Decoder6565安迪·霍尔研究了 GPT-5、GPT-5 nano、GPT-6 Astra、Opus 4.8 和 Gemini 3.8 Flash 在检测智能体不当行为(如奖励攻击和沙袋策略)时的表现。
Hugging Face Daily Papers2424物理AI应通过终身认知共生体增强人类智能,该共生体通过感知、情境保留和主动协助来弥补认知差距,需要嵌入式治理。大型基础模型和个人智能体已能独立完成多步任务,但人类仍会遗忘知识、忽略信息、缺乏历史参考,因为能提供帮助的机器处于情境之外。
The Decoder7575Vals AI 的 CyberOffense 基准让 AI 智能体在隔离的 Kali Linux 机器上自主攻击模拟企业网络,OpenAI 受限项目中的 GPT-6 Sol Daybreak 完成 80.8% 的目标,开源权重模型 Deepseek V4.1 Flash 1017 达到 72.8%,单次运行成本约 3 美元而非约 22 美元
The Decoder精选同一件事 · 2 家7272Nous Research 使用约 5300 万 token 对阿里 Qwen3.8-27B 进行监督微调,得到开源权重模型 Arete-27B,其宣传性回答占比从 22% 降至 0.9%,事实准确率从 2.32 升至 2.98。
推荐理由: 原文给出了微调前后的宣传率与事实准确率对比,读者可据此判断中文开源模型的政治倾向是否只停留在表层。
The Decoder精选7878一项研究让 Claude Opus 4.8、Claude Opus 5、Claude Fable 5、Claude Opus 5.5、GPT-5.6 Sol、GPT-6 Astra。
推荐理由: 这项基准用 15 个未发表的研究问题检验 9 个智能体,并给出 135 份提交中常见的失败模式,可作为评估自主科研能力的参照。
IT之家 · AI精选同一件事 · 2 家7070谷歌发布多模态 AI 系统 AI-PPG-ACC-HTN,无需袖带校准,用普通消费级智能手表被动检测持续高血压,成果发表于 Nature。研究在 5 个临床中心纳入 196 名受试者,以 24 小时动态血压监测为参照,初步筛查特异度 90.0%、阳性预测值 80.6%、灵敏度 65.8%;确诊性检测阳性预测值 96.7%、特异度 90.9%、灵敏度 78.4%。