跳到正文
实时
  1. vLLM Blog60

    vLLM-Omni 在 NVIDIA Vera Rubin 上支持 MiniMax H3-Image,4K 生成 0.87 秒

    vLLM-Omni 团队将 MiniMax H3-Image 接入 NVIDIA Vera Rubin,四卡 SP4 配置下原生 4096×4096 文生图短提示词基准中位延迟 0.87 秒,四副本 SP1×DP4 吞吐达 6115 张/小时。
    推荐理由: 原文给出 H3-Image 在 Vera Rubin 上的实测延迟、吞吐与跨硬件部署配置,可据此判断 4K 图像生成的部署成本。

  2. AWS Machine Learning Blog60

    AWS开源UAEF:跨框架闭环评测AI智能体

    AWS 发布开源框架 UAEF,用适配器将 LangGraph、LangChain、Strands Agents、Amazon Bedrock AgentCore 和 Langfuse 的执行轨迹统一为 AgentTrace,再用 7 个维度 36 项内置指标打分。

    推荐理由: 原文给出跨框架统一评测的适配器与指标设计,读者可据此判断多框架智能体版本对比的落地方式。

  1. OpenRouter Blog70

    OpenRouter 教程:如何修复 OpenAI 与 Claude 的 429 限流错误

    OpenRouter 发布了教程,讲解如何读取 429 响应头并按 limit_source 判断限流来源,给出了重试、模型回退、供应商故障转移三种修复方式。

    推荐理由: 作者用同一批 60 条请求实测三种 429 处理方式,给出耗时与成本对比,可直接迁移到自己的重试逻辑。

  1. Hacker News · 300+ 热帖78

    llama-modchip 使 284B DeepSeek-V4-Flash 在 64GB 内存无 GPU 运行

    llama-modchip 发布了一组 ggml/llama.cpp 内核补丁与量化转码工具,将 284.33B 的 DeepSeek-V4-Flash 压缩到 56.56 GiB(1.71 bpw),可在 64 GB 内存的纯 CPU 机器上运行,256K 上下文下峰值内存 57.61 GiB 且无需 swap。

    推荐理由: 项目给出了在 64 GB 内存上运行 284B MoE 的量化方案与内核补丁,并附各硬件实测数据,可据此判断纯 CPU 部署的可行边界。

  1. AWS Machine Learning Blog60

    生产级 AI 智能体的四层上下文工程:Deep Insight 在可运行代码中的实践

    AWS 团队以开源多智能体数据分析方案 Deep Insight 为参考实现,把生产级 AI 智能体的上下文工程拆成四层:多智能体架构隔离上下文、用提示词限制输出、把重内容外置到文件系统、用验证智能体与兜底机制把关。

    推荐理由: AWS 团队把上下文工程拆成四层,并给出开源参考实现中的具体代码与 token 节省数据,可直接对照改造自家 Agent。

  1. OpenHands Blog71

    OpenHands 与 Snowflake 推出用自有 Agent harness 后训练模型的工作流

    OpenHands与Snowflake AI Research合作,让开发者用现有的OpenHands Agent harness直接进行强化学习后训练,无需在训练框架中重建harness。

    推荐理由: 原文给出了用现有 Agent harness 直接做 RL 后训练的具体配置方式和代码定位实验,读者可据此判断训练与部署能否共用一套 harness。

  1. Google Developers Blog62

    用 A2UI 与 CopilotKit 智能体构建生成式 UI 应用

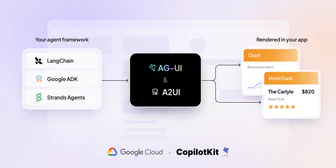
    谷歌介绍其框架无关的开放标准 A2UI,让智能体以声明式 JSON 描述界面,由应用用已有组件渲染,并配合 CopilotKit 的 AG-UI 协议接入 LangChain、Google ADK、Mastra、Strands 等智能体框架。

    推荐理由: 原文给出 A2UI 与 CopilotKit 的完整接入代码和双向交互示例,可据此判断生成式 UI 的落地方式。

  1. LangChain Blog71

    LangChain 如何搭建设计智能体 Content Studio

    LangChain 介绍了其内部设计智能体 Content Studio 的搭建过程,该智能体在 Slack 中接收一句提示词即可产出视频、社交图、UI 图和幻灯片,所有素材均以代码生成。

    推荐理由: LangChain 公开了设计智能体 Content Studio 的完整搭建过程,包括技能、wiki、检查门与异步子智能体的分工方式,可作为构建垂直 Agent 的参考。

  1. vLLM Blog60

    vLLM在GB300 NVL72上服务DeepSeek-V4.1-Flash:性能追平DeepInfer并扩展至整机架

    vLLM 团队在 NVIDIA GB300 NVL72 单机架上用 P/D 分离与 Wide-EP 服务 DeepSeek-V4.1-Flash,在 SemiAnalysis AgentX 上达到每 GPU 954K tokens/s、单用户 P90 196 tokens/s,为早期单节点结果的 7.9 倍。

    推荐理由: vLLM 团队公开了在 GB300 NVL72 上服务 DeepSeek-V4.1-Flash 的逐项优化与实测数据,可与 DeepSeek 自家引擎 DeepInfer 对照。

  1. vLLM Blog62

    vLLM 详解 GLM-5.3 在 16 张 H200 上的 PCP、DCP 与 Hybrid HiSparse 优化

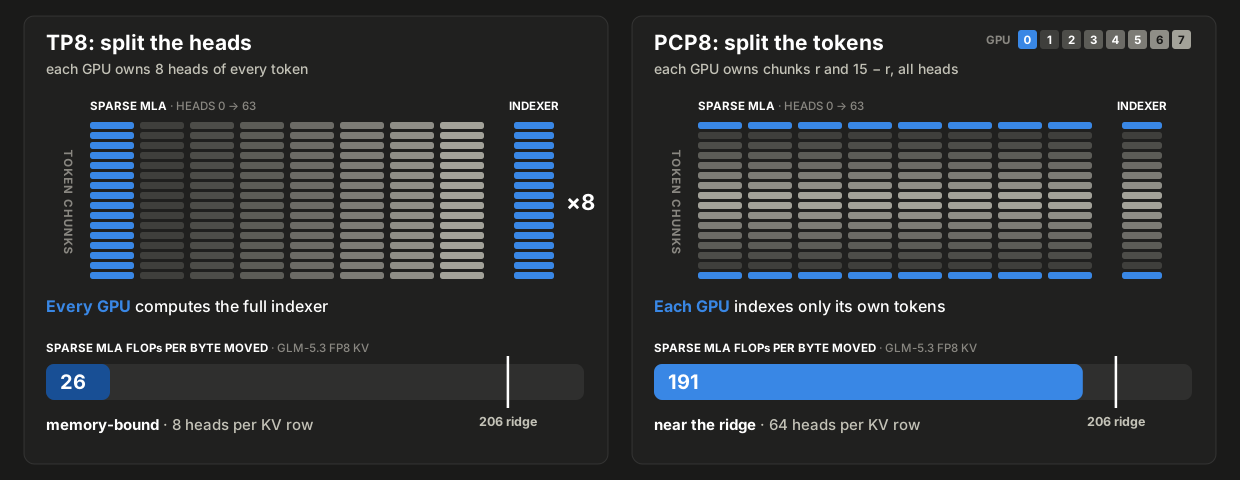
    vLLM 团队发布 GLM-5.3 优化第二部分,在 16 张 H200 上以 1 个预填节点加 1 个解码节点部署,用 PCP 按 token 切分预填、DCP 按 token 切分 KV cache,使 1M 上下文可放入预填节点

    推荐理由: vLLM 团队拆解了 PCP、DCP 与 Hybrid HiSparse 如何在 16 张 H200 上组合,读者可据此理解长上下文部署的内存与预填瓶颈。

  1. Databricks Blog60

    Databricks 谈 AI 账单:如何把编码智能体单位成本降低九成

    Databricks 高管 Patrick 复盘公司全面采用 AI 编码智能体后成本指数级上升、再通过控制层把单位成本最多降低 90% 的过程。他提到把流量迁到更便宜的新模型贡献了 50% 以上降幅,Smart Router 在接近最贵模型质量下把平均任务成本降低 30% 以上。这套内部方案后来产品化为 Unity Gateway,目前已有数千家客户使用。

    推荐理由: Databricks 高管复盘自家 AI 编码成本从失控到单位成本降九成的过程,给出网关、路由与自建评测的可迁移做法。

  1. vLLM engineering42

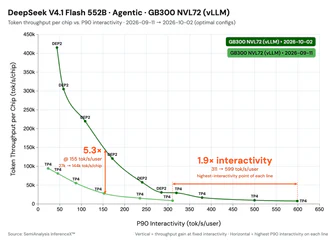
    vLLM 解释了 DeepSeek-V4.1-Flash 的 5.3× 吞吐量提升

    Inferact 和 vLLM 团队在经过三周的优化后,报告称在 150-tokens-per-second 的限制下,低并发服务的速度提高了 1.9×,吞吐量提高了 5.3×。这些更改结合了滑动窗口注意力的有界重放、CUDA 图和融合内核。他们的帖子解释了缓存重建和跳过提示词预填充的某些部分如何减少服务工作量。

    推荐理由: 编辑要点:仅凭模型基准测试无法描述服务成本。这份工程分析有助于识别缓存和内核瓶颈;所报告的收益适用于其基准测试条件,而非每一次部署。

  1. LangChain Blog71

    LangChain 如何构建付费媒体智能体

    LangChain 公开其付费媒体智能体的构建方法,该智能体运行在 Slack 中,每周汇总广告平台与仓库数据并生成报告,付费媒体在六个月内从贡献 0 提升到营销管道的 20%,单条合格线索成本在 6 月至 8 月下降 30%。

    推荐理由: LangChain 公开付费媒体智能体的完整工程细节,包括上下文分层、工具按需发现和子智能体隔离,可作为自建长时运行智能体的参考。

  1. Anthropic Research62

    Anthropic 发布 Claude Code 智能体编码最佳实践

    Anthropic 发布 Claude Code 智能体编码最佳实践,覆盖 CLAUDE.md 配置、工具权限管理、MCP 接入、常见工作流与多 Claude 并行等做法。文中建议先用子智能体探索和规划再写代码,并给出测试驱动、截图迭代、无头模式自动化等具体流程。该文已迁移至官方文档,原博客不再维护。

    推荐理由: Anthropic 官方系统整理了 Claude Code 的配置、工作流与多实例并行方法,可作为搭建智能体编码流程的参考。

已浏览全部内容