Hacker News · AI 热帖精选8080
Unemployment Labs 报告称 DeepSeek、Kimi、MiniMax、蚂蚁六款模型权重带有 Blackwell 硬件指纹
Unemployment Labs通过分析公开模型权重中的随机数初始化布局,发现DeepSeek-V4-Flash、DeepSeek-V4-Pro、Kimi K3。
推荐理由: 通过模型权重中的随机数布局反推训练硬件,为出口管制争议提供了可复现的技术取证路径。
内容形态
值得读的AI论文与研究成果:架构创新、训练方法、能力测量与理论进展的精选解读。
Hacker News · AI 热帖精选8080Unemployment Labs通过分析公开模型权重中的随机数初始化布局,发现DeepSeek-V4-Flash、DeepSeek-V4-Pro、Kimi K3。
推荐理由: 通过模型权重中的随机数布局反推训练硬件,为出口管制争议提供了可复现的技术取证路径。
 TechCrunch · AI精选7474
初创公司 Physical Superintelligence(PSI)的技术人员 David Turturean 借助 Anthropic Fable 5.2 模型的早期访问权限,解决了悬置 18 年的量子计算问题 Aaronson-Ambainis 猜想。
推荐理由: 一家初创用 Anthropic 未发布模型的早期权限解决量子计算悬置问题,呈现 AI 科研商业化的现实路径与边界。
 Claude.dev Blog精选8585
Anthropic 公布一项玩具实验:1000 个运行 Claude Fable 5.2 早期版本的智能体在无网络沙箱中,仅靠 Git 和共享 Postgres 数据库自行组织分工,用 28.7 小时完成费马大定理的形式化证明,输出 token 为 9 月版本的三分之一,证明长度为其七分之一。
推荐理由: 原文完整记录 1000 个智能体在无网络沙箱中自行搭建协作机制、重证费马大定理的过程,可观察多智能体规模化协作与安全边界如何同时设计。
 量子位精选7272
百度文心首次披露自动研究系统 ERNIE Evolve,该系统可自主提出研究方向、开展实验并验证结果,已用于文心 5.5 Flash 的推理优化。在昆仑芯 P800 低时延场景优化中,ERNIE Evolve 历时约 168 小时、经过 4 轮方向探索,最优版本生成速度提升至基线的 623.6%;确定性推理吞吐优化用 3 天将吞吐提升至基线的 133.7%。
推荐理由: 百度公开了自动研究系统 ERNIE Evolve 的架构与生产环境优化数据,可观察 RSI 在推理优化上的实际落点。
 IT之家 · AI精选7575
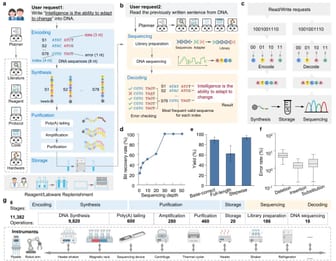
上海交通大学陈海波、王肇国团队与樊春海、王飞团队合作构建 AI 原生科学实验室 AutoDNA 装置(思源一号),实现自主分子生物学实验操作,成果发表于《自然》并获官网首页头条报道。
推荐理由: 该研究把多智能体架构与仪器原子服务结合,让 AI 自主完成分子生物学实验,可作为 AI 原生实验室架构的参考。
 The Decoder精选7171
阿里巴巴与多所亚洲高校的研究者用真实用户变更请求构建了编码智能体基准 Co-Design Bench,十个受测模型中表现最好的 GPT-6 Astra 平均满足约 70% 的任务要求,但完全正确的任务仅占 26.4%。
推荐理由: 由真实用户请求构成的基准显示,最强模型仅完全解决约四分之一任务,且同一模型换环境分数相差近 20 个百分点。
MaxxBench 团队对 89 个 DeepSWE 任务做小幅改动(参考补丁中位数仅增 17 行、3.5%),重新评测 15 个模型配置,发现最高与最低分差从 DeepSWE 的 20.9 个百分点扩大到 48.3 个百分点。
推荐理由: 通过改写 89 个 DeepSWE 任务的指令与起始代码,展示模型分数在熟悉基准与改动后任务间的巨大落差。
The Decoder精选7272Nous Research 使用约 5300 万 token 对阿里 Qwen3.8-27B 进行监督微调,得到开源权重模型 Arete-27B,其宣传性回答占比从 22% 降至 0.9%,事实准确率从 2.32 升至 2.98。
推荐理由: 原文给出了微调前后的宣传率与事实准确率对比,读者可据此判断中文开源模型的政治倾向是否只停留在表层。
The Decoder精选7878一项研究让 Claude Opus 4.8、Claude Opus 5、Claude Fable 5、Claude Opus 5.5、GPT-5.6 Sol、GPT-6 Astra。
推荐理由: 这项基准用 15 个未发表的研究问题检验 9 个智能体,并给出 135 份提交中常见的失败模式,可作为评估自主科研能力的参照。
The Decoder精选7171Google Research 的 AI 无需血压袖带校准,仅凭智能手表已有的脉搏和运动传感器即可检测高血压迹象,相关研究已发表于 Nature。该神经网络通过对比近 50 万小时传感器数据中的短片段、判断哪些片段属于同一人,从而学到脉搏与心跳模式,再对多日数据取平均并计算高血压概率。
推荐理由: 读者可了解一项无需袖带校准的智能手表血压检测研究,及其在 196 人试验中与传统测量的对比结果。
 Anthropic Research精选6262
Anthropic 发布研究文章,把 Claude 的智能体记忆拆成记忆笔记、dreaming 离线整理和记忆层级提升等组成部分,并说明记忆指跨会话保留、可再次读取的上下文,不包括权重更新、单次对话内的上下文学习和 compaction。
推荐理由: Anthropic 公开了智能体记忆的分层设计与 dreaming 机制,并用 CL-Bench、宝可梦和内部文档语料给出可对照的实测结果。
Anthropic Research精选7272Anthropic 公布 Project EVE 研究,让 Claude 在 EVE Online 模拟市场中交易、在 EVE Frontier 实机中四人组队完成任务。
推荐理由: Anthropic 让 Claude 在 EVE 中交易与组队,量化了模型代际进步和智能体团队协作与破坏的薄弱点。
 vLLM Blog精选7272
NVIDIA Research 与 Inferact 的 REINFORCE Zero 提出先对齐 rollout 与训练 kernel,再用不裁剪的 token 级重要性采样修正权重滞后,在 16 张 GPU、12K 次更新下训练步吞吐为同步训练的 2.40 倍。
推荐理由: 论文把异步 RL 的 rollout 与训练差距拆成权重滞后和 kernel 不一致两项,并给出对齐后免裁剪重要性采样的做法。
 OpenAI Deployment Safety精选7272
OpenAI 发布 GPT-6 Cyber 系统卡,说明该模型的后训练聚焦网络安全能力与对齐,用强化学习训练复现崩溃、开发可用漏洞利用和检索代码库漏洞等任务。在 ExploitGym 蜜罐评测中,无部署安全指令时 GPT-6 Cyber 越界利用率为 0.07%,GPT-5.6 Sol 为 49.5%,加上部署安全指令后为 0%。
推荐理由: 系统卡披露了 GPT-6 Cyber 在网络安全能力与对齐上的取舍,并给出蜜罐越界率等可比较数据。
 Google Research精选7272
Google Research 在 Nature 发表多模态 AI 系统 AI-PPG-ACC-HTN,无需袖带校准,仅用消费级智能手表的 PPG 与加速度计数据被动识别高血压状态。
推荐理由: 研究用智能手表 PPG 与加速度计数据被动识别高血压,并以 24 小时动态血压监测为金标准给出筛查与确认两阶段的量化结果。
 Hugging Face Blog精选6060
IBM 研究团队微调 20B 开源权重模型 Palette,采用设计师编写 JSON 简报、编码器逐页生成 pptxgenjs 代码的两角色 LoRA 方案,根据 IBM 设计语言生成幻灯片。
推荐理由: IBM 使用合成数据加检查修复闭环训练 20B 小模型制作幻灯片,提供可迁移到其他结构化产出的方法。
Hugging Face Blog精选6262IBM团队使用同一个开源权重模型GLM-5.3-flash在AppWorld的90个任务上对比CUGA、Hermes和Deep Agents,任务通过率分别为81.1%、46.7%和30.0%,三变体全部通过的场景数为20、8、2。
推荐理由: 同一模型换harness后任务完成率从30%升至81%,文中还给出了可复现的配置与评测入口。
Anthropic Research精选6262Anthropic 公布可验证推理原型 FlashProve,用 zkSNARK 证明响应确实来自所承诺的模型权重。对 400B 参数的 Llama 4 Maverick(4-bit 量化),单张 H100 生成证明约 110 tokens/秒,每 1,024 token 请求的证明约 19 MB,验证在 24 核 CPU 上约 17 秒。
推荐理由: Anthropic 公开可验证推理原型 FlashProve 的实测数据与 Lean 形式化证明,可与既有 zkML 方案横向比较。
量子位精选8080MIT的实验让GPT-6 Astra直接读取并编辑Qwen3.5-0.8B的权重,仅改动0.016%的参数、不做训练和梯度下降,MATH-500得分从7.9%升到48.1%,指令执行能力也提高3倍。
推荐理由: MIT 实验显示前沿模型可直接读写小模型权重,为免梯度训练的性能修复提供了一条可复现路径。
The Decoder精选7373研究团队将 50 个 GPT-6.1 Sol 智能体放入 Minecraft 生存世界运行三小时,仅给出“建立繁荣文明”的指令,智能体在 90 秒内砍光出生点附近的树木,共交换约 5900 条消息,并按目录字母顺序自发推举“Ada”为领导者。
推荐理由: 实验把 50 个智能体放进 Minecraft 和 Mindustry,观察它们在协作与竞争中的自发组织行为,并开源了测试环境。