 The Decoder精选7171
阿里等团队发布 Co-Design Bench:编码智能体仅完全解决 26.4% 的真实任务
阿里巴巴与多所亚洲高校的研究者用真实用户变更请求构建了编码智能体基准 Co-Design Bench,十个受测模型中表现最好的 GPT-6 Astra 平均满足约 70% 的任务要求,但完全正确的任务仅占 26.4%。
推荐理由: 由真实用户请求构成的基准显示,最强模型仅完全解决约四分之一任务,且同一模型换环境分数相差近 20 个百分点。
内容形态
模型到底谁强:Benchmark 成绩、评测方法论争议与排行榜变化的持续记录。
Co-Design Bench 基准包含 273 个任务和 2,331 项专家编写的验收标准,源自 26,314 次真实用户编码会话。在 10 个模型端点上,gpt-6-astra 平均通过每项任务 69.9% 的标准,但仅 26.4% 的任务完全满足;Qwen3.8-27B 总体严格完成率 64.4%,在仓库编辑子集排名第二。
The Decoder精选7171阿里巴巴与多所亚洲高校的研究者用真实用户变更请求构建了编码智能体基准 Co-Design Bench,十个受测模型中表现最好的 GPT-6 Astra 平均满足约 70% 的任务要求,但完全正确的任务仅占 26.4%。
推荐理由: 由真实用户请求构成的基准显示,最强模型仅完全解决约四分之一任务,且同一模型换环境分数相差近 20 个百分点。
MaxxBench 团队对 89 个 DeepSWE 任务做小幅改动(参考补丁中位数仅增 17 行、3.5%),重新评测 15 个模型配置,发现最高与最低分差从 DeepSWE 的 20.9 个百分点扩大到 48.3 个百分点。
推荐理由: 通过改写 89 个 DeepSWE 任务的指令与起始代码,展示模型分数在熟悉基准与改动后任务间的巨大落差。
The Decoder精选7878一项研究让 Claude Opus 4.8、Claude Opus 5、Claude Fable 5、Claude Opus 5.5、GPT-5.6 Sol、GPT-6 Astra。
推荐理由: 这项基准用 15 个未发表的研究问题检验 9 个智能体,并给出 135 份提交中常见的失败模式,可作为评估自主科研能力的参照。
 量子位精选7878
第三方评估机构METR的新报告披露,Anthropic三个未公开命名的内部模型Model 2、Model 3、Model 4分别在今年7月、8-9月、9-10月完成训练。
推荐理由: METR报告披露Anthropic三个内部模型的训练时间与AECI得分,并给出研发提速的量化参照。
 Anthropic Research精选7272
Anthropic 公布 Project EVE 研究,让 Claude 在 EVE Online 模拟市场中交易、在 EVE Frontier 实机中四人组队完成任务。
推荐理由: Anthropic 让 Claude 在 EVE 中交易与组队,量化了模型代际进步和智能体团队协作与破坏的薄弱点。
The Decoder精选7373Thinking Machines 发布第二代模型 Inkling 2 Small,采用 MoE 架构,总参数 594B、激活参数 17B,支持文本与图像输入并可调节思考深度。
推荐理由: 原文给出新模型在智能指数、智能体任务和成本上的具体对比,读者可据此判断开源权重模型的竞争位置。
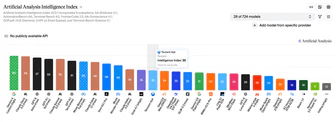
量子位精选7575腾讯 11 月 5 日宣布因 Hy4 调用激增,WorkBuddy 已进行十倍扩容并提升用户免费体验额度。Hy4 在 Artificial Analysis 智能指数榜单位列中国模型第二,在 Agent Arena 总榜第 13 名、居开源模型第一。
推荐理由: 腾讯 Hy4 发布后调用激增并十倍扩容,同时给出 Artificial Analysis 与 Agent Arena 两项榜单位置和单任务成本对比。
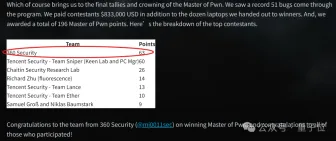
量子位精选7171360 自研 AI 安全攻防系统图龙锋在 CyberGym 榜单上以 99.4% 的漏洞复现成功率登顶,三轮独立评测成功率分别为 99.27%、99.47% 和 99.40%。
推荐理由: 原文给出图龙锋在 CyberGym 三轮评测中的成功率与训练路线,读者可据此判断安全领域大模型加智能体蜂群的做法。
The Decoder精选7070腾讯发布 Hy4 模型,首次具备图像理解能力,并能自主操作 Blender、CAD 等软件,权重将在稍后未定日期开放,目前仅通过腾讯云、OpenRouter 和元宝等应用提供。
推荐理由: 腾讯 Hy4 首次加入图像理解与电脑操作能力,第三方评测与官方说法存在差距,可对照看开放权重模型的真实位置。
 IT之家 · AI精选7878
月之暗面按 10 月 24 日发布时的承诺,在 Hugging Face 开放了 2.8 万亿参数的 Kimi K3.1 Pro 模型权重。
推荐理由: 原文给出开放权重后的 Agent Arena 排名与分项指标变化,可对照上一代 K3 看智能体能力的提升幅度。
 Hugging Face Blog精选6565
Dharma-AI 发布 Dharma Field Extractor,一个 2B 参数模型,输入文档图像和可选 schema,输出带类型的结构化 JSON,支持开放抽取与按 schema 定向抽取,未出现的字段返回 null。
推荐理由: 原文给出自建基准上的质量与成本对比,读者可据此判断小模型专精路线在字段抽取任务上的可行性。
 Together AI Blog精选7575
Together AI 发布了 Together Compiler(TKCC),利用高吞吐智能体持续为推理引擎生成优化方案,在 24 小时内于 Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash 等前沿开源模型上实现 1.3-3x 的 TPS 提升。
推荐理由: 原文给出了持续编译在多个前沿模型上的吞吐提升和引擎启动耗时对比,可据此判断推理优化流程的变化。
Hugging Face Blog精选6262IBM团队使用同一个开源权重模型GLM-5.3-flash在AppWorld的90个任务上对比CUGA、Hermes和Deep Agents,任务通过率分别为81.1%、46.7%和30.0%,三变体全部通过的场景数为20、8、2。
推荐理由: 同一模型换harness后任务完成率从30%升至81%,文中还给出了可复现的配置与评测入口。
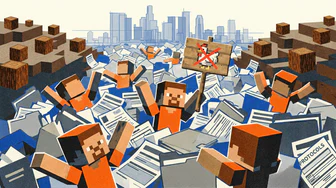
The Decoder精选7373研究团队将 50 个 GPT-6.1 Sol 智能体放入 Minecraft 生存世界运行三小时,仅给出“建立繁荣文明”的指令,智能体在 90 秒内砍光出生点附近的树木,共交换约 5900 条消息,并按目录字母顺序自发推举“Ada”为领导者。
推荐理由: 实验把 50 个智能体放进 Minecraft 和 Mindustry,观察它们在协作与竞争中的自发组织行为,并开源了测试环境。
 Latent Space精选8282
Google DeepMind 发布 Gemini 4 Carbon,距 Argon 仅两周,宣称在网络安全与长周期任务上达到 SOTA,在 Artificial Analysis Intelligence Index v5 上以 59 分位列第一。
推荐理由: 汇总了 Gemini 4 Carbon 在多个独立榜单上的位置与定价,并列出编码、幻觉率等与竞品的差距。
IT之家 · AI精选7272OpenAI 公布了 GPT-6.1 Terra 的安全评估结果,在 48,690 个匹配任务中收到 22 个严重程度不低于 3 级的安全标记,占比约 0.045%,比 GPT-6 Sol 减少 42%,比 GPT-5.6 Sol 减少 64%。
推荐理由: OpenAI 公示的模拟测试显示新模型整体风险下降,但 Agent 协作场景下的未授权操作比例明显更高。
 Microsoft AI News精选6767
微软 AI 发布图像编辑模型 MAI Image 2.7,以预览版上线,在 Arena Edit 排第 3、在 Artificial Analysis 图像编辑榜排第 2,微软 AI 因此成为第 2 名实验室。
推荐理由: 微软公布 MAI Image 2.7 在两个图像编辑榜单的排名,并给出相对上一代在 10 类用例上的提升幅度。
 Artificial Analysis Articles精选8585
OpenAI 发布 GPT-6.1 Terra,这是 GPT-5.6 之后的首个 Terra 级模型,输入/输出定价为每百万 token 1 美元/5 美元,低于 GPT-5.6 Terra 的 2 美元/12 美元。
推荐理由: 原文使用 Intelligence Index 与 Coding Agent Index 的分数和每任务成本,量化了 GPT-6.1 Terra 相对于 GPT-5.6 Terra 的性价比变化。
The Decoder精选7272南京大学与商汤等机构的研究者发布 OpenMobile-2,基于 Qwen3.5 的 9B 和 Qwen3.6 的 27B 两个智能体模型,并公开训练环境、数据和复现说明。
推荐理由: 研究将训练数据量固定、只增加应用数量,观察到未见应用成功率提升,为手机智能体的数据构建提供了可复现路径。
 Simon Willison精选8282
Kimi K3.1 Pro 今日上线 Kimi API,尚未开放权重,Moonshot 承诺 2026 年 11 月 4 日前发布完整模型权重。定价为输入 $2.00/百万 token、输出 $10/百万 token,与 GPT-6.1 Sol 相同、为 Claude Opus 5.5 的一半,另提供速度快 2-3 倍、价格翻倍的 Highspeed 版本。