The Decoder精选8585
Google DeepMind 推出 AlphaProof Code,四周验证 Signal 加密核心
谷歌 DeepMind 发布 AlphaProof Code,一款符合安全规范的 AI 数学证明软件,并在四周内完成了通常需要数年才能在 Signal 加密协议上完成的验证工作。
推荐理由: AlphaProof Code 将形式化验证从理论设计推进到实际运行代码,四周完成通常需数年的工作,并给出人工复核比例。
技术方向
AI 写代码的一切:编码助手、Vibe Coding、代码模型评测与开发工作流变革。
The Decoder精选8585谷歌 DeepMind 发布 AlphaProof Code,一款符合安全规范的 AI 数学证明软件,并在四周内完成了通常需要数年才能在 Signal 加密协议上完成的验证工作。
推荐理由: AlphaProof Code 将形式化验证从理论设计推进到实际运行代码,四周完成通常需数年的工作,并给出人工复核比例。
 Google DeepMind精选8787
Google DeepMind 面向开发者、企业、科学家和消费者开放 Gemini 4 Carbon,称其在网络安全能力和长程智能体工作流上达到前沿水平。
推荐理由: 官方给出 Carbon 与 Argon 的定位分工、多项基准排名和每任务成本对比,便于判断何时该用更重的模型。
 Claude · YouTube精选7575
Anthropic 发布 Claude Fable 5.2,面向最艰巨的技术挑战,在编码、推理和视觉方面有所提升,适合最具野心的开放式技术工作。官方建议多数编码与知识任务优先使用 Opus 5.5,Fable 5.2 已在 Pro、Max、Team 和 Enterprise 套餐上线。
推荐理由: 官方说明了 Fable 5.2 的定位与适用场景,并给出与 Opus 5.5 的选择建议,便于判断该用哪个模型。
The Decoder精选7171阿里巴巴与多所亚洲高校的研究者用真实用户变更请求构建了编码智能体基准 Co-Design Bench,十个受测模型中表现最好的 GPT-6 Astra 平均满足约 70% 的任务要求,但完全正确的任务仅占 26.4%。
推荐理由: 由真实用户请求构成的基准显示,最强模型仅完全解决约四分之一任务,且同一模型换环境分数相差近 20 个百分点。
MaxxBench 团队对 89 个 DeepSWE 任务做小幅改动(参考补丁中位数仅增 17 行、3.5%),重新评测 15 个模型配置,发现最高与最低分差从 DeepSWE 的 20.9 个百分点扩大到 48.3 个百分点。
推荐理由: 通过改写 89 个 DeepSWE 任务的指令与起始代码,展示模型分数在熟悉基准与改动后任务间的巨大落差。
Apiiro 的研究指出,Claude Code 的 Don't Ask Again 选项使密码等敏感信息出现在 1,122 个公开 GitHub 文件中。该文在 Hacker News 获得 582 分和 394 条评论。
 OpenAI News精选6060
OpenAI 宣布将收购 Pierre Computer Company,以扩展 Codex 在代码构建、理解和审查方面的工具能力。原文未披露交易金额、时间表及收购后团队与产品的具体安排。
推荐理由: 官方披露的收购动作,读者可据此了解 Codex 在代码构建与审查工具上的补强方向。
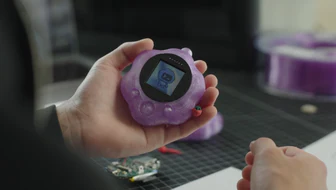
The Decoder精选7474OpenAI 称其硬件团队用 GPT-6 Astra 设计了一款可与 Codex 编码智能体对话的设备,作为副项目在不到一周内完成。Astra 承担了外壳设计、含元件选型与走线的 PCB 布局、固件和用户界面等全部环节,代工厂在不到一个月内产出小批量原型,但因 Astra 未总能考虑制造约束、公差和装配细节,经历了几轮修改。
推荐理由: OpenAI 公布了 GPT-6 Astra 端到端完成硬件设计的流程,也指出了它在制造约束上的短板。
 MarkTechPost精选7171
Microsoft Research 与 UC Berkeley 的研究团队发布开源成本控制器 TokenEconomizer,可在不改动模型权重和智能体代码的前提下降低编码智能体开销。
推荐理由: 原文给出插件在 277 个 SWE-Bench 任务上的成本降幅与 Pass@1 变化,可据此判断它对编码智能体工作流的影响。
 Factory News精选7878
Factory 发布 Droid 1.0,这是其智能体 harness 的大版本更新,默认启用程序化工具调用(Script 模式),模型可写 JavaScript 在沙箱中一次请求内执行数百次工具调用。
推荐理由: 原文给出 Droid 1.0 在 Terminal-Bench 4 上对比 Codex、Claude Code 等 harness 的成本与耗时数据,可用于判断 agent harness 的选型。
 Meta Engineering精选6666
Meta公布Catching JiTTests已在内部投入生产,用LLM为待合入的diff自动生成可执行测试,在代码落地前暴露行为差异
推荐理由: Meta 公开了 JiTTests 的生产部署细节与量化结果,可供评估 LLM 生成测试在超大规模代码库中的落地方式。
 Mistral AI精选8282
Mistral 发布旗舰万亿参数原生多模态模型 Mistral Large 4(Le Chonk)的开放权重版本,此前已公开预览三周。
推荐理由: 官方给出万亿参数开源模型的编码、安全与推理效率数据,以及权重下载和自托管路径。
 Artificial Analysis Articles精选7272
Artificial Analysis 在 Coding Agent Index v2.0 中实测 GitHub Copilot CLI 的 Copilot Fusion 最高档设置,其单任务成本为 5.59 美元,而 Claude Code 配合 Opus 5.5(max)为 11.42 美元,综合得分仅低 2 分。
推荐理由: Artificial Analysis 使用 Coding Agent Index 实测 Copilot Fusion,给出与 Claude Code 同等性能下的成本与 token 对比。
The Decoder精选8585月之暗面发布 Kimi K3.1 Pro,这是 Kimi K3 的后训练版本,在 Artificial Analysis 智能指数上得分 55,比 K3 提升 11 分,排名第四,仅次于 Claude Opus 5.5(58)、Claude Sonnet 5.5(56)和 Muse Wonder Full(56)。
推荐理由: 文章用第三方指数和多项基准对比,呈现开源权重模型与闭源前沿模型之间差距缩小的具体幅度。
The Decoder精选8282Anthropic 的 Frontier Red Team 与 Theorem 合作,让 Claude 把 OSS-Fuzz 中 123 个开源库的崩溃测试转成数学问题,几周内生成约 1.8 亿行证明代码,并由 Rocq 自动校验。
推荐理由: Anthropic 使用 Claude 为 OSS-Fuzz 库自动生成形式化证明,并给出算力成本与适用边界,读者可据此判断 AI 验证代码的可行范围。
 Anthropic Research精选8282
Anthropic 与 Theorem 合作,用 Claude 对 123 个 OSS-Fuzz 开源库的 239 个入口点完成 RISC-V 汇编层的形式化证明,证明这些程序在小于 64 MB 的任意输入下都不会崩溃,证明代码约 1.8 亿行 Rocq。
推荐理由: Anthropic 使用 Claude 在 123 个开源库的 RISC-V 汇编层完成形式化证明,并给出成本与复用数据,可据此判断该方法能否进入日常开发流程。
The Decoder精选7474AI 初创公司 Recursive 发布首个语言模型 Flint,开发过程中名为 Eureka Machine 的 AI 系统参与提出想法、搭建、测试并规划后续实验。
推荐理由: Recursive 首次公开由自动化研究系统参与开发的模型,读者可据此观察 AI 辅助研发能走到哪一步。
Anthropic Research精选6767Anthropic 基于 2025 年 10 月至 2026 年 4 月约 40 万条 Claude Code 会话,提出分析交互式智能体编码的框架。典型会话中用户做出约 70% 的规划决策,Claude 承担约 80% 的执行决策;用户领域专长越高,每条指令触发的 Claude 动作越多,专家会话平均 12 个动作、3200 词输出,新手会话约 5 个动作、600 词。
推荐理由: 基于约40万条Claude Code会话,量化了规划与执行的分工,以及领域专长如何影响任务成功率。
Anthropic Research精选7878哈佛物理教授 Matthew Schwartz 引导 Claude Opus 4.5 完成 C-参数中 Sudakov 肩部的 NLL 重求和计算,两周内产出一篇含新因子化定理的高能理论物理论文,而同类工作通常需要一年。
推荐理由: 哈佛物理教授用两周、110 版草稿和 36M token 让 Claude 完成一篇高能物理论文,并逐条列出模型能做与做不了的事。
Anthropic Research精选6767Anthropic 研究团队开发了一个基于 Claude Code 自定义命令的智能体,通过阅读类型注解、docstring 和注释推断代码应满足的属性,再用 Hypothesis 编写属性测试,在 NumPy、SciPy、Pandas 等 100 多个热门 Python 包中发现数百个潜在 bug。
推荐理由: Anthropic 用 Claude 智能体在 NumPy、SciPy、Pandas 等包中自动写属性测试找 bug,并给出人工复核后的有效率与已合并修复