跳到正文
实时

Agent 智能体 · 页 2

11月9日周一21–40
  1. IT之家 · AI82

    美团龙猫开源 LongCat-2.5 模型,总参数 1.6 万亿、支持百万上下文

    美团龙猫将面向长程智能体任务的原生多模态模型 LongCat-2.5 正式开源,采用 MIT 协议,支持商用推理部署与二次训练且无需额外授权。模型总参数 1.6 万亿,每个 token 激活约 480 亿参数,支持一百万上下文,并针对显存与带宽受限的国产算力芯片在架构、芯片适配与部署策略上做了协同优化。

    推荐理由: 原文给出总参数、激活参数、上下文长度与开源协议,读者可据此判断长程智能体任务的开源模型选项。

  2. 量子位72

    千问办公2.0发布,推出支持多人与Agent协作的Team Agent

    千问办公11月9日发布2.0版本,推出支持多人与Agent协作的“协作”功能,并上线“人机共创”“资料空间”“自动任务”“三端互联”等能力,所有功能已在客户端全量上线。

    推荐理由: 千问办公2.0把Agent放进团队协作场景,并给出银泰百货等具体落地案例,可观察办公Agent从个人助手转向团队协作的路径。

  3. 量子位82

    腾讯混元Hy4发布:770B总参数、49B激活参数,首次支持原生视觉与电脑操作

    腾讯混元Hy4正式发布,770B总参数、49B激活参数,首次引入原生视觉能力和电脑操作支持,指令遵循、长文理解与长程Agent能力同步升级。模型已在腾讯云TokenHub、WorkBuddy/CodeBuddy、元宝等产品上线,API接入OpenRouter、Hermes、OpenCode等平台,权重将于近期开源。

    推荐理由: 作者用多个长程任务实测混元Hy4的自主执行与自检能力,可据此判断开源模型在Agent交付上的实际水平。

  4. MarkTechPost71

    0sec Labs 开源 AI 安全 harness 0,提供 Web 控制台、CLI 与 MCP 服务

    0sec Labs 开源了 AI 安全 harness 0,以 MIT 或 Apache-2.0 许可发布,属于研究预览版,可从本地浏览器控制台、无头 CLI 或 MCP server 驱动,用于漏洞调查、代码审查、渗透测试、逆向工程和修复生成。

    推荐理由: 原文给出该安全 harness 的架构、自报基准与同类工具对比,可据此判断它在漏洞挖掘流程中的位置。

  5. 量子位72

    量子位实测 LobeHub AI 协作平台:主管 Agent 派活、招人、接力交付

    量子位作者用 LobeHub 组建 AI 编辑部实测:主管 Agent Sienna 在不到 8 分钟内分派三位小编产出 6 条选题简报,随后自行新建网页开发和 QA 两个 Worker,沿用上一轮成果在约 30 分钟内做出可筛选的资讯看板。

    推荐理由: 作者用两轮实测展示主管 Agent 如何派活、临时招人并接力交付,可观察多 Agent 协作的实际边界。

11月8日周日
  1. IT之家 · AI75

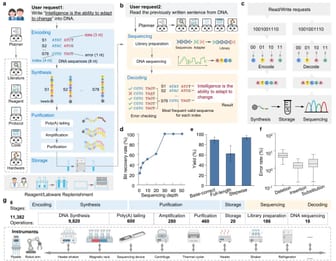
    上海交大 AutoDNA 装置实现自主分子生物学实验,成果登《自然》

    上海交通大学陈海波、王肇国团队与樊春海、王飞团队合作构建 AI 原生科学实验室 AutoDNA 装置(思源一号),实现自主分子生物学实验操作,成果发表于《自然》并获官网首页头条报道。

    推荐理由: 该研究把多智能体架构与仪器原子服务结合,让 AI 自主完成分子生物学实验,可作为 AI 原生实验室架构的参考。

  2. The Decoder71

    阿里等团队发布 Co-Design Bench:编码智能体仅完全解决 26.4% 的真实任务

    阿里巴巴与多所亚洲高校的研究者用真实用户变更请求构建了编码智能体基准 Co-Design Bench,十个受测模型中表现最好的 GPT-6 Astra 平均满足约 70% 的任务要求,但完全正确的任务仅占 26.4%。

    推荐理由: 由真实用户请求构成的基准显示,最强模型仅完全解决约四分之一任务,且同一模型换环境分数相差近 20 个百分点。

  3. Hacker News · 300+ 热帖71

    MaxxBench 发布:改写 DeepSWE 任务后模型分数大幅分化

    MaxxBench 团队对 89 个 DeepSWE 任务做小幅改动(参考补丁中位数仅增 17 行、3.5%),重新评测 15 个模型配置,发现最高与最低分差从 DeepSWE 的 20.9 个百分点扩大到 48.3 个百分点。

    推荐理由: 通过改写 89 个 DeepSWE 任务的指令与起始代码,展示模型分数在熟悉基准与改动后任务间的巨大落差。

11月7日周六
  1. Anthropic Research62

    Anthropic 拆解智能体记忆的组成与 dreaming 机制

    Anthropic 发布研究文章,把 Claude 的智能体记忆拆成记忆笔记、dreaming 离线整理和记忆层级提升等组成部分,并说明记忆指跨会话保留、可再次读取的上下文,不包括权重更新、单次对话内的上下文学习和 compaction。

    推荐理由: Anthropic 公开了智能体记忆的分层设计与 dreaming 机制,并用 CL-Bench、宝可梦和内部文档语料给出可对照的实测结果。

11月6日周五
  1. 量子位75

    腾讯 Hy4 调用激增十倍扩容,Agent Arena 开源模型第一

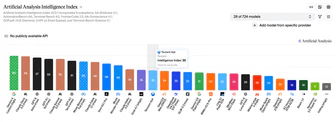
    腾讯 11 月 5 日宣布因 Hy4 调用激增,WorkBuddy 已进行十倍扩容并提升用户免费体验额度。Hy4 在 Artificial Analysis 智能指数榜单位列中国模型第二,在 Agent Arena 总榜第 13 名、居开源模型第一。

    推荐理由: 腾讯 Hy4 发布后调用激增并十倍扩容,同时给出 Artificial Analysis 与 Agent Arena 两项榜单位置和单任务成本对比。

  2. Cursor Changelog78

    Cursor 上线 Live Apps,可在编辑器内构建并分享可访问应用

    Cursor 推出 Live Apps 功能,用户描述需求后由云端智能体搭建 Web 应用、按需启动 Postgres 数据库、接入 Cursor SSO 鉴权并完成托管部署,发布后生成可分享链接。

    推荐理由: Cursor 将建站、数据库、鉴权和部署纳入云端智能体,读者可据此判断内部工具的开发门槛会降到什么程度。

  3. OpenAI Deployment Safety72

    OpenAI 发布 GPT-6 Cyber 系统卡

    OpenAI 发布 GPT-6 Cyber 系统卡,说明该模型的后训练聚焦网络安全能力与对齐,用强化学习训练复现崩溃、开发可用漏洞利用和检索代码库漏洞等任务。在 ExploitGym 蜜罐评测中,无部署安全指令时 GPT-6 Cyber 越界利用率为 0.07%,GPT-5.6 Sol 为 49.5%,加上部署安全指令后为 0%。

    推荐理由: 系统卡披露了 GPT-6 Cyber 在网络安全能力与对齐上的取舍,并给出蜜罐越界率等可比较数据。