Latent Space
Supabase 如何让 AI 智能体更易用
Supabase 成为众多前沿 AI 模型的首选应用后端后,其通过无 Docker 本地后端启动、Git 管理数据库模式、数据库旁侧运行计算等实用功能降低开发摩擦。
Latent SpaceSupabase 成为众多前沿 AI 模型的首选应用后端后,其通过无 Docker 本地后端启动、Git 管理数据库模式、数据库旁侧运行计算等实用功能降低开发摩擦。
 Replit Blog
ViBench 2.0 发布,用于评估模型在长时程软件构建中的能力,包含 17 个产品、241 个功能请求和 544 个测试计划,顶级模型 GPT-6.1 Sol。
 IT之家 · AI
苹果发布配备 PROLED XDR 显示屏的首款触控 MacBook Pro,其 M5 Max 芯片版配备最高 128GB 统一内存,可本地运行数千亿参数大语言模型,支持 LM Studio 等应用,售价 22,999 元起。
 LangChain Blog
OpenWiki 使智能体在需要跨来源连接的问题上准确率比单独搜索高约 5 倍,添加证据图将准确率再提高 27% 并使引用一致性翻倍。
 PyTorch Blog5858
PyTorch® 2.15 发布,默认采用重写的 NCCL 后端,支持故障记录和回滚;torch.distributed 新增 NIXL 后端的单边传输;FSDP2 和流水线并行优化内存通信控制。
 Hugging Face Daily Papers
EvidenceConnect 框架通过合成图像区域缩略视图生成比较、聚合或链式视觉证据问题,提升 VLM 的证据连接能力,ZwZ2 模型基于此框架训练,未针对任何下游基准但提升细粒度与空间感知,并在具身空间推理、多模态长上下文理解、多模态智能体任务及通用视觉推理上取得进展
 Meta Engineering
Meta Andromeda 下一代广告检索引擎通过模型-系统协同设计,在检索层实现近排名级模型性能,单卡单秒处理超过 10 亿广告,系统吞吐量达 1000 亿次/秒,较 2024 年版本提升 100 倍,并为广告主带来 2.4% 的转化率增长。
Hugging Face Daily PapersVibeVideoBench评估代码驱动的视频生成多模态智能体,发现顶尖系统在多数任务上满足核心要求,但常因时间管理不善失败;扩散视频模型能生成惊艳片段,却无法可靠渲染公式。
IT之家 · AI同一件事 · 2 家Liquid AI 发布 LFM3 模型家族,首批多款均基于 LFM3-1.7B-Base,其中 LFM-1.7B 拥有 256K 上下文窗口,在参数减少 35% 的同时性能优于上代 LFM2.5-2.6B。
Hugging Face Daily Papers分解矢量量化技术通过在互补特征视图上使用并行码本提升了离散视觉token质量,使其在多模态理解中能匹配连续表示,在工业级多模态数据上训练的模型在九项指标平均上比 UniAR 和 Emu3-Chat 分别高 22.8% 和 59.2%,是目前首个能与 Qwen3-VL 等强连续表示模型竞争的离散表示模型。
 MarkTechPost精选同一件事 · 7 家7777
Google DeepMind 发布研究预览版 Genie 4,可从文本和图像提示实时生成可探索世界,并原生生成环境音、音乐和角色对话。该模型在仿真循环中引入 Gemini 作为规划器,由 Gemini 3.8 Flash 拆解目标、检查帧并重新规划,Gemini Omni 负责锚定世界的外观与行为。
各家口径不同:The Verge 表示模型支持长达两分钟的场景,而 Ars Technica 和 TechCrunch 提到物理和人物模拟的改进,但没有具体说明场景时长。
Hugging Face Daily PapersThe Trinity 框架通过将任务组织成能力树、生成模拟训练世界、路由专业 Harness 模块,递归改进多模态智能体,在 28 个训练基准和 18 个未见基准上提升均值性能 34 和 26 点,包括两个真实世界具身任务。
Hugging Face Daily PapersPDRVLA通过集成轻量级物理动态模块改进机器人行动生成,该模块在物理世界模型监督下预测未来视觉特征,避免在线视频生成带来的延迟。PDRVLA在四个模拟基准上取得99.3%(LIBERO)、89.9%(LIBERO-Plus)、93.6%(RoboTwin~2.0)和81.5%(SimplerEnv)的成功率。
 量子位同一件事 · 2 家
蚂蚁集团旗下百灵大模型开源 Ling-3.1-flash-1019,在智能指数 AA-Briefcase 中得分 1524 Elo,较上一版本提升 3 分;基础模型 Ling-3.1-flash-base 采用混合线性 MoE 架构。
Hugging Face Daily Papers6565CodeCap-Bench 通过比较代码字幕与自然语言字幕在视频问答和重建任务上的表现,证明代码字幕具有更优的推理准确性和重建保真度。该基准包含 323 个结构化 2D 内容视频,涵盖五个类别,评估发现主流闭源 MLLM 在代码字幕生成上虽表现良好,但难以捕捉复杂时序动态,开源模型差距显著。
 Browser Use
GPT-6 Astra 在 Odysseys2 长时程网页智能体基准中表现最佳,完成 47 项任务,平均评分为 84.6。该基准包含 100 项真实网页任务,每项任务有 8-12 项通过/失败检查,15 个智能体参与测试,其中 Opus 5.5 高效模式完成 18 项任务,平均评分为 71.2。
Hugging Face Daily Papers6565ThinkWorld模型通过将动作表示为动态链并利用世界想象从无标注人类视频中学习,提升了机器人泛化能力。该VLA框架将每个动作推理表示为动态推理链(CoD),通过强化学习与世界想象结合强化推理,使无标注视频能提供状态转换的直接监督,实现人类与机器人经验的共同推理空间。实验证明其在仿真和真实机器人上有效实现人机迁移并泛化到未见任务和环境。
Hugging Face Daily PapersChronoReplay训练框架通过将异构时空监督组织成按时间排序的交互片段、保留特定任务答案格式、平衡不同监督信号学习,使单一模型能学习互补时空能力并保持时间一致性,在 OVO-S-Bench、OST-Bench 和 UCS-Bench 基准测试中均取得提升,OST-Bench 提高 13.41 分,同时通过自适应帧选择优化流式推理性能。
Hugging Face Daily Papers同一件事 · 2 家Hy-Nomas 是一个 8B 参数的扩散模型,支持自由形式文本指令和跨多轮交互的相机控制,通过因果注意力与结构化视频描述相结合的方式遵循多轮文本和相机指令,在人类评估中优于现有世界模型,已开源模型权重、代码和基准。
IT之家 · AI精选同一件事 · 7 家8282谷歌DeepMind于10月27日发布Genie 4世界模型,定位为重大研究里程碑,用户可用自然语言指令实时改变天气、镜头、角色和物体,而非重新生成一段视频。
各家口径不同:The Verge 表示模型支持长达两分钟的场景,而 Ars Technica 和 TechCrunch 提到物理和人物模拟的改进,但没有具体说明场景时长。
IT之家 · AI精选同一件事 · 7 家7777谷歌 DeepMind 推出世界模型 Genie 4,目前处于研究预览阶段,可生成可交互虚拟世界并在运行中输入提示词修改场景,还能生成与画面同步的实时音频。相比前代 Genie 3,Genie 4 画面拟真度提升,支持实时调整天气、镜头角度和增删人物物体,最长维持两分钟连贯场景,为前代的两倍。
各家口径不同:The Verge 表示模型支持长达两分钟的场景,而 Ars Technica 和 TechCrunch 提到物理和人物模拟的改进,但没有具体说明场景时长。
MarkTechPost精选同一件事 · 2 家7171据 Hugging Face 博客和 MarkTechPost,每个模型均可在单张 GPU 上微调;文本模型 LFM3-1.7B 为 1.73B 参数、256K 上下文窗口,4-bit 量化下约 1 GB 内存即可运行,可部署在手机、笔记本、私有服务器或云端。MarkTechPost 称免费商用上限为年营收 1000 万美元,完整 128K 上下文需 1.6 GB KV 缓存。IT之家称 LFM-1.7B 参数比上代 LFM2.5-2.6B 减少 35%,性能却更优。
推荐理由: 6 个 2B 级开源模型共享同一骨干,并给出与 Qwen3.5-9B 等竞品的逐项对比,可据此判断小模型在端侧与智能体任务上的位置。
 Ollama releases
Liquid AI 发布 LFM3 小模型家族,包含 1.7B 参数的 lfm3 文本模型(256K token 上下文)、支持图像理解的 lfm3-vl、18 语言语音处理能力的 lfm3-audio 及通用模型 lfm3-omni,用于本地智能体和结构化输出;d1 决策模型升级至 2B 参数,支持文本、图像及音频决策,部分模型支持苹果硬件。
量子位千里科技推出AI 4D毫米波雷达,内置10 TOPS NPU,支持本地AI感知与卫星架构并行输出,实现从天线设计到点云输出的端到端AI处理。该雷达点云密度增强10倍,探测距离提升40%,鬼影消除率达95%,空间角分辨力提升12倍,提供边缘侧、卫星架构及兼容三种工作模式,以适应不同功能等级和平台需求。
 The Decoder同一件事 · 7 家
DeepMind 发布 Genie 4,这是公司首个能实时生成声音的即时世界模型,用户可通过键盘移动场景、用文本提示引导事件。Genie 4 基于视频模型 Gemini Omni 构建,由 Gemini 大模型族在后台规划模拟进程,支持背景音效、角色对话及实时交互。目前仅限选定测试者体验,未来将向 Google AI Ultra 订阅者开放,并集成 SynthID 水印标记 AI 生成内容。
各家口径不同:The Verge 表示模型支持长达两分钟的场景,而 Ars Technica 和 TechCrunch 提到物理和人物模拟的改进,但没有具体说明场景时长。
 Google Developers Blog3434
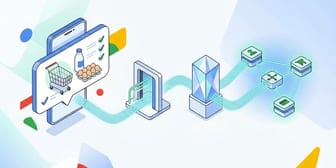
Google 发布对话式商务工作原型 HappyDelivery,基于 LangGraph 和 Gemini 在 GCP 上实现;Ingress 层通过 GKE/Cloud Run 和 Cloud Pub/Sub 处理来自 WhatsApp 的输入
 The Verge · AI同一件事 · 7 家
Google 发布 Genie 4 世界模型,支持生成更逼真交互体验。该模型采用 Gemini 3.8 Flash 架构,可实时通过自然语言更新体验、生成音频,并支持长达两分钟的场景(较 Genie 3 的一分钟提升)。
各家口径不同:The Verge 表示模型支持长达两分钟的场景,而 Ars Technica 和 TechCrunch 提到物理和人物模拟的改进,但没有具体说明场景时长。
 Hugging Face Blog精选7676
Liquid AI 发布 LFM3 新一代 Liquid Foundation Models,以 LFM3-1.7B-Base 为共享骨干派生六个 2B 级模型,覆盖文本、视觉、音频、全模态和决策,全部在 Hugging Face 开放权重。
推荐理由: Liquid AI 用同一 2B 级骨干派生六个模态模型,并给出单卡微调与端侧部署路径,可据此判断小模型专用化路线。
 Google Research5858
Google Research 提出睡眠框架,让 LLM 通过交替的主动(清醒)和睡眠阶段实现持续学习;睡眠阶段利用 MoE 和 Hope 架构进行参数扩展与知识蒸馏,将短期记忆整合为长期参数,支持高达 10M token 的长上下文知识保留和复杂推理能力提升。
 AWS Machine Learning Blog3434
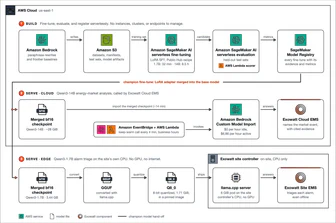
Exowatt 通过 Amazon SageMaker AI serverless 模型定制,为边缘和云部署目标生成了任务特定微调模型 Qwen3-1.7B 和 Qwen3-14B,在准确性上超越前沿模型的同时成本降低了高达 49 倍,并将模型开发周期从数月缩短至数天。
 Ars Technica · AI精选同一件事 · 7 家7878
Google DeepMind 公布 Genie 4 世界模型,称其在几乎各个方面都优于 Genie 3,模拟的物理效果和人物更真实,部分改进来自 Google 更新的 Gemini 模型。
各家口径不同:The Verge 表示模型支持长达两分钟的场景,而 Ars Technica 和 TechCrunch 提到物理和人物模拟的改进,但没有具体说明场景时长。
 NVIDIA Newsroom5858
NVIDIA Vera Rubin NVL72 和 NVIDIA Vera CPU 现已在 Oracle Cloud Infrastructure (OCI) 上正式提供,计划引入 HGX Rubin NVL8 系统以帮助组织加速前沿模型训练、提高推理效率并扩展智能体工作负载。
 TechCrunch · AI精选同一件事 · 7 家7272
Google DeepMind 以研究预览形式发布世界模型 Genie 4,可生成照片级真实且可交互的场景,并支持在模拟过程中输入提示词实时改变天气、镜头角度或添加人物物体。
各家口径不同:The Verge 表示模型支持长达两分钟的场景,而 Ars Technica 和 TechCrunch 提到物理和人物模拟的改进,但没有具体说明场景时长。
 Google DeepMind精选同一件事 · 7 家8484
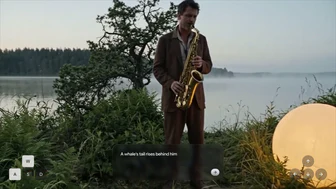
Google DeepMind 发布世界模型 Genie 4,可实时生成带原生音频的交互式模拟世界,并以文本提示实时改变天气、镜头和场景元素。Genie 4 首次原生生成环境音与人声对话,角色可实时对话并响应场景事件;Gemini 3.8 Flash 在循环中充当引导智能体,把目标拆成步骤并逐帧校验。
各家口径不同:The Verge 表示模型支持长达两分钟的场景,而 Ars Technica 和 TechCrunch 提到物理和人物模拟的改进,但没有具体说明场景时长。
推荐理由: 官方披露了原生音频、实时文本操控与 Gemini 引导推理三项能力,可据此判断世界模型在机器人与内容预演中的位置。
Replit BlogReplit Cloud Agents 允许团队任何成员直接安全地贡献代码到核心代码库,通过在运行应用中测试每个变更、传递审查反馈并共享配置,工程师保持控制权,同时降低其他人的贡献门槛。
Ollama releasesLiquid AI 发布 LFM3 小模型家族,包含 1.7B 参数文本模型 lfm3 及支持图像、音频功能的变体,上下文窗口达 256K tokens;d1 决策模型升级至 2B 参数,支持文本、图像及音频推理,Apple 硬件已支持 rc1 版本。
 NVIDIA Technical Blog同一件事 · 2 家6565
Inclusion AI 在 NVIDIA DGX Spark 上对 Ling-3.0-flash 进行批大小 1 评估时发现解码是内存限制因素,其中 MoE 计算和输出层投影导致执行时间增加。MoE 计算和输出层投影是瓶颈。
各家口径不同:NVIDIA技术博客指出解码是内存瓶颈,由于MoE计算和输出层投影,而MarkTechPost强调了由于新的MoE后端、FP8输出层和推测解码导致的42.5%吞吐量提升和3.5倍速度提升。
Hugging Face Daily Papers6565AV-FABLE 引入一个用于长视频稀疏篡改的音频视觉基准,表明冻结的音频视觉大语言模型的感知特征包含最佳通过分离时间解码器而非语言输出恢复的取证证据。长视频中的局部 AI 篡改通常影响其他内容真实的短暂事件,使视频级分类不足以进行取证分析。
 IBM Research Blog3838
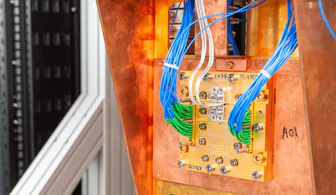
IBM 研究人员使用四个米级 l-couplers 连接两台 IBM Quantum Nighthawk 处理器,实现 99% 的量子状态传输保真度,展示处理器间可靠量子信息传输。该新芯片间连接设计兼容 IBM Quantum Nighthawk,并可扩展至 IBM Quantum Starling 及更先进的量子计算机。
 蚂蚁 inclusionAI · Hugging Face 新模型同一件事 · 2 家5858
inclusionAI/Ling-3.1-flash-1019 发布,560B 参数量,25B 活跃参数/Token,1M 上下文窗口,推理能力提升,AA-Briefcase 分数 1524 Elo,AutomationBench-AA 68%,Artificial Analysis Intelligence Index v4.3.2 44 分。支持 SGLang 和 vLLM 推理。