Nace AI 开源 Drex Max v1:一个可在 Apple Silicon 上本地运行的 27B 决策模型
Nace AI 开源了其最强大的决策模型 Drex Max v1,可在 Apple Silicon 硬件上本地运行。该模型包含 bf16 权重、Q8_0 GGUF 格式、仿射 Q4 检查点和 llama.cpp/Ollama 分支,在公共决策指数 0.4 上得分 67.52,优于 Drex v2.0(61.25),并在 InfographicVQA 上达到 97.3 的技能分。


Exin Therapeutics 成功让 AI 智能体操控机械臂为小鼠注射药物治疗癫痫,手术过程由 Anthropic Sonnet 模型自主完成药物选择、脑区定位和注射,兽医全程监督并需批准每步操作。AI 智能体在手术中通过摄像头观察注射部位,最终注入 250 纳升药物,小鼠恢复良好。Anthropic Opus 5.5 模型因检测到生物相关内容而拒绝执行手术。
商汤科技开源 SenseNova Loop-9B-Preview 模型,采用 Looped Transformer 架构,在仅 9B 参数规模下媲美 27B 模型,并在代码生成、办公场景和智能体任务中优于其他模型,包括超过 Qwen3.5-27B
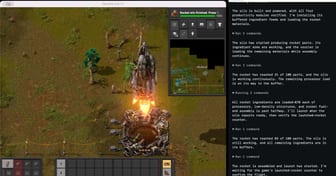
GPT-5.6 Sol 在 Codex 中以低思考级别,耗时 13.5 小时游戏时间完成了和平模式(无比特人)的 Factorio 运行。该运行使用了游戏管理器,允许 Sol/Codex 通过小型库(此次为 Python 而非 Bash)与游戏交互,模型按 GUI 规则编程控制游戏。观察运行结果显示 Sol 在某些方面超出预期,但也暴露出明显弱点。
OpenAI 将于 11 月 29 日开始使用此前未用于训练的 Daybreak Blue 会话数据训练模型,引发研究者对类似 Buckmaster-Alpöge 事件的担忧。OpenAI 向 Trusted Access 会员确认了这一政策变更,并承诺提供单独的退出选项,但安全审核中标记的交互仍可用于安全目的。
OpenRouter上开源权重模型在9月底已占顶尖50%模型token的72%,较2025年10月提升455%;闭源模型虽使用量也增长近10倍,但开源模型每百万token输入成本仅闭源的约四分之一;因竞争激烈,开源模型如DeepSeek V4.1 Flash、GLM-5.3 Flash等价格更低,但顶尖闭源模型Claude Opus 5.5在AI分析智能指数上仍领先11分。
Drew Breunig 将 NES 6502 CPU 模拟器嵌入 Qwen3.5-4B 模型权重中,用户可运行 NES ROM 如 Super Mario Bros,但速度极慢。该项目使用 Opus 5.5 提示词构建,并基于 15 年前 Christopher Pow 发布的 NES CPU 验证测试集。
GPT-Rosalind-6 使用与 GPT-6 Astra 相同的权重,未添加训练数据或进行额外后训练。在 GeneBench Pro v13 测试中,GPT-Rosalind-6 在最高推理预算下的单次尝试成功率(129 个问题)为 37.7%,优于 GPT-Rosalind-5.5 的 16.7%。该模型在生物和化学领域的评估中被评为高能力,并持续监控以调整安全防护措施。
Anthropic 的 Claude Security 在 Claude Code 会话内运行,无需额外 API 密钥,输出 Markdown 报告和 SARIF 文件。
小米开源轻量级文档理解模型 Xiaomi-OCR-0,参数规模 0.8B,权重与推理代码已上线 Hugging Face 和 GitHub,单一模型覆盖文档解析、关键信息抽取与 OCR 视觉问答三类任务。
推荐理由: 0.8B 参数在 OmniDocBench v1.6 上位列总榜第二,且权重、MCP 服务与 Skill 工具包一并开放,可据此判断小模型做文档解析的边界。
法国 Mistral AI 发布 Large 4 模型(ML4),具备编程和网络防御能力,企业可部署在自有计算机和服务器上运行。该模型在欧洲数据中心训练,使用 3800 颗英伟达 Grace Blackwell GPU,总参数量 1.05 万亿,每次执行任务实际激活约 520 亿参数。
inclusionAI 发布 ZwZ2-9B GGUF 格式权重,属于 Zooming without Zooming v2 项目,包含语言模型(FP16, Q8_0, Q4_K_M)和视觉编码器及投影器(mmproj,FP16, Q8_0, Q4_K_M),需搭配 llama.cpp Qwen3.5 多模态支持使用,支持 CLI 推理和 Web Chat 部署。
inclusionAI/ZwZ2-27B-GGUF 模型权重发布,包含 FP16、Q8_0、Q4_K_M 精度的语言模型和视觉组件,支持 llama.cpp 多模态推理。
Samaya AI 发布 Sterling 模型,基于 30B 混合专家模型 Nemotron 3.5 Lightning 微调而成,拥有 3B 活跃参数。在 FrontierFinance 基准测试中,Sterling 得分 58.9%,高于 Claude Fable 5.1 的 55.9%,且每问题成本仅为 $0.61(Fable 5.1 为 $6.89)。
inclusionAI/ZwZ2-4B-GGUF模型权重发布,该模型为Zooming without Zooming v2的一部分,分为语言模型(FP16, Q8_0, Q4_K_M)和视觉编码器及投影器(mmproj,FP16, Q8_0, Q4_K_M),提供多种精度组合,需配合lla.cpp(支持Qwen3.5多模态)使用。
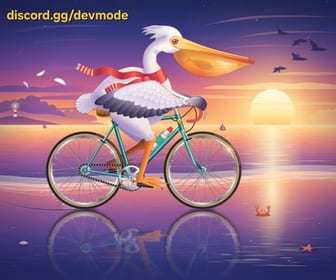
Anthropic 曝光两款新 Claude 模型 Fable 5.5 和下一代 Opus,已进入早期测试阶段。Fable 5.5 在实测中展现惊人画面质感与光影细节,鹈鹕自行车效果图细节丰富。Anthropic 正在为 IPO 做准备,新模型最快下周发布,市场估值或超 1.5 万亿美元。
SoMark 团队开源 1.3B 文档解析模型 OXR,在 OmniDocBench(97.18)、olmOCR-Bench(87.84)和 DocParsingBench(87.76)三项榜单排名第一。
推荐理由: 1.3B 模型靠 RSI 后训练在三个文档解析榜单登顶,并给出可插拔架构与免费 API 的工程取舍。
开发者 Divyansh Agrawal 于 10 月 22 日发布实验性模型 Qwenputer,基于阿里 Qwen3.5-4B 构建,在神经网络内部实现 32 位 RISC-V CPU 与内存功能,无需调用 Python 等外部工具即可执行程序和精确计算。
推荐理由: 开发者将 RISC-V 指令集编译进 Qwen3.5-4B 权重,用具体基准数字展示了模型内计算的精度提升与体积、速度代价。
Edge0 发布开源文本转语音模型 Audio8-TTS-Realistic,0.6B 参数量支持 23 种语言零样本语音克隆,在 CV3 基准测试中平均误差率 4.86% 优于 Qwen3-TTS-1.7B 和 VoxCPM2,但低于 4B 级别的 Higgs TTS 3。模型采用双自回归架构,包含 24 层宽度 896 的慢分支和 4 层并行预测快分支,并使用学习型真实感评论家进行训练。
Mistral AI 于当地时间 10 月 29 日正式开放 Mistral Large 4(代号 le Chonk)模型权重,这是一款 1 万亿总参数、490 亿激活参数的原生多模态模型,在欧洲自有数据中心用 3,800 块 NVIDIA Grace Blackwell GPU 从零训练。
Claude Sonnet 5.5 是默认选择,Claude Haiku 5.5 适用于高容量和子智能体工作,Claude Opus 5.5 用于任务长、模糊或错误代价高的场景。
智元于 10 月 29 日推出具身模型 GO-3 Preview,采用具身原生的 WRAM 架构,把任务推理、未来预测与动作生成连接起来,并已登顶 RoboDojo、RoboTwin、RoboColiseum 三大评测榜单,计划 2026 年底全面开源。
推荐理由: 原文给出便利店真机任务成功率从 28.6% 到 85.7% 的部署后数据,可观察具身模型在线自我改进的路径。
Baseten 发布了 joey-1,一款 2B 参数决策模型,返回标签和校准概率而非生成文本,用于高容量路由、分类和护栏检查,每百万输入 token 价格为 0.01 美元,权重在 Hugging Face 上以 MIT 许可证开源。
各家口径不同:Baseten Blog 表示模型在参数量≤3B时表现最佳,而 MarkTechPost 提到的是 2B 参数模型。
GPT-6 Luna (October 28) 使用与 GPT-6 Luna (October 7) 相同的数据和训练方式,但性能对比值可能反映后续版本。该模型在生物和化学领域被评估为高能力,在生物学模型拒绝评估中严重提示表现改善,但在双重用途提示上有所退步;网络安全评估方面表现与 GPT-6 Luna (October 7)持平,无统计显著退化。
OpenAI 更新模型规范,以五大核心价值引导更强大的 AI;新规范旨在确保 AI 具备健全判断力、尊重人类自主权并忠实于人类意图。
Base Labs 发布 joey-1 决策模型,参数量≤3B时表现最强,单请求P50延迟20ms,成本仅0.01美元/百万token,支持文本和图像输入。该模型适合高决策量、低延迟敏感场景,可通过Baseten Model APIs使用或部署,权重已开源至Hugging Face。
各家口径不同:Baseten Blog 表示模型在参数量≤3B时表现最佳,而 MarkTechPost 提到的是 2B 参数模型。
Mistral 发布了其万亿参数开源模型 Mistral Large 4(ML4,昵称 Le Chonk)的权重,企业与政府可在 Hugging Face 和 API 上获取并自行部署。
OpenAI 采用分层监控检测前沿模型对齐问题及未授权智能体行为,以便在事件升级前介入。
NVIDIA 在 AWS 上推出 120B 参数的 Nemotron 3.5 Super VL 模型,该模型每激活 12B 参数处理一个 token,结合推理和工具使用,支持文本、图像、文档和视频理解。
Mistral 发布其最大模型 Mistral Large 4,在编码任务上领先开源对手,但在整体排名中仍落后于中国模型。该模型拥有约 1 万亿参数,每步 520 亿参数,运行需 8 个 Nvidia B300 GPU。
扩散智能 DiffuSpace 发布开源扩散语言模型 Clover-35B-A3B-Preview,采用 MoE 架构,在多项基准测试中性能超过同规模自回归模型 Qwen3.6-35B-A3B,尤其擅长智能体编程与工具使用任务。
Mistral 发布多模态 MoE 模型 Mistral Large 4(Le Chonk),约 1T 总参数、49B 激活参数,上下文窗口 1M tokens,提供 FP8 与 NVFP4 两个官方版本,另有 Unsloth 和 llama.cpp 团队制作的 GGUF。
推荐理由: 原文给出 1T 总参数、49B 激活的 MoE 多模态模型在网络安全与编码基准上的具体分数,并附本地与端点部署实测吞吐。
Mistral 发布旗舰万亿参数原生多模态模型 Mistral Large 4(Le Chonk)的开放权重版本,此前已公开预览三周。
推荐理由: 官方给出万亿参数开源模型的编码、安全与推理效率数据,以及权重下载和自托管路径。
豆包工作向企业客户开放第三方模型服务,首批接入 Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等系列模型,支持团队订阅版和企业订阅版客户按用量扣除 AI 点数使用,可灵活划定可用范围并批量启用。
XHEART 新芯航途发布大模型芯片 X7 Ultra,算力达 700 TOPS,量产模型实测 99.99% 对齐,内存带宽消耗下降 80%、能效提升 100%。芯片内置高精度算子加速引擎,原生支持 FP16/FP32 计算,中国首发量产 Armv9 车规级 CPU,性能提升 20%、能效提升 10%。
Prox模型通过top-k通道选择和基于权重的读取器加速专家混合推理,同时保持准确率,无需校准数据。在13%和18%的预算下,Prox的top-k版本在43次比较中的40次得分不低于或优于阈值版本,包括所有23次生成任务,且避免了校准阈值在Gemma 4上引起的重复循环崩溃。
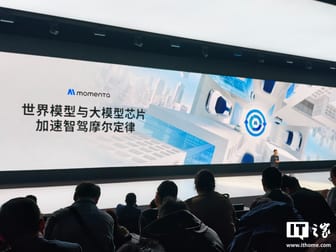
Momenta CEO 曹旭东首次公开了大模型定义芯片,该芯片性能比通用芯片提升 10 倍,可支持千亿参数模型实现规模化 L4,推动机器人等物理 AI 应用的突破。XHEART 新芯航途发布了全新 X7 Ultra 大模型芯片,专为大模型设计,拥有超大核 NPU 架构和 Armv9 车规级 CPU。
Block 宣布仅基于人类对话语音训练的全双工语音模型 Dessa,该模型无需文本或预训练模型,在 1 个包含 72 个 Blackwell GPU 的 NVIDIA GB200 NVL72 机架上进行训练,可在 MacBook Pro M4 Max 上本地运行且速度超实时,目前仅提供研究预览和等待名单。
各家口径不同:The Verge 提及模型对话偶有'生硬和诡异'表现;The Decoder 和 TechCrunch 没有提到这一点。
新芯航途发布 X7 Ultra 大模型芯片,内置高精度算子加速引擎,支持 10 倍参数量模型部署,NPU 计算利用率达 98.7%,内存带宽消耗下降 80%、能效提升 100%。该芯片中国首发量产 Armv9 车规级 CPU,性能提升 20%、能效提升 10%。
英伟达于 10 月 28 日推出开放权重语音转录模型 Nemotron 3.5 Transcribe,整合转录、说话人归属、翻译和音频问答,采用 MoE 架构,总参数约 340 亿、激活参数约 43 亿,可处理最长 1 小时录音,支持 40 种语言转录、最多区分 8 名说话人。
推荐理由: 英伟达开源语音转录模型,公开了参数规模、多语言与说话人分离能力及榜单成绩,可对照现有开源 ASR 方案。