Nvidia 发布开源语音模型 Nemotron 3.5 Transcribe,整合转写、翻译与说话人识别
Nvidia's open Nemotron 3.5 Transcribe combines transcription, translation, and speaker recognition
Nvidia 发布开源语音识别模型 Nemotron 3.5 Transcribe,支持 40 种语言转写、31 种语言与英语互译、13 种语言的说话人识别,可处理最长 1 小时、最多 8 人的录音。
同一新闻,精选展示《英伟达开源语音转录模型 Nemotron 3.5 Transcribe,支持 40 种语言与 8 人说话人分离》
同一件事另外 3 家也报道了
- TechCrunch · AI··首发
- The Decoder··+50 分钟·当前阅读
Nvidia 发布开源语音模型 Nemotron 3.5 Transcribe,整合转写、翻译与说话人识别
- MarkTechPost··+13 小时 41 分
NVIDIA 发布 Nemotron 3.5 Transcribe 开源语音模型,支持 40 种语言转写
新增信息:活跃参数约4B;离线运行
- IT之家 · AI··+16 小时 31 分
按发布时间排列 · 事件后续出现时自动追加 · 由模型根据各家标题与摘要比对
Nvidia 发布了一个开放语音识别模型,该模型接收文本指令,公司表示它在多个基准测试中领先。发布还包括一个大型训练数据集和用于将模型适配到专业领域的工具。
一份简单的文字记录无法告诉你谁说了什么。它也不会翻译任何内容或正确拼写技术术语。Nemotron 3.5 Transcribe 旨在在一个模型中处理所有这些,它还可以回答关于录音内容的问题。Nvidia 表示该模型可转录 40 种语言,将其中 31 种翻译成或从英语翻译,并在 13 种语言中识别说话人。它可以处理长达一小时的录音。录音中可以包含多达八位说话人。
用户通过简单的指令控制该模型。根据提示,相同的会议录音可以变成带有说话人标签的文本记录、英语翻译或决策摘要。用户还可以传递技术术语,如药物名称作为提示。该模型仅在它们实际出现在录音中时使用它们。
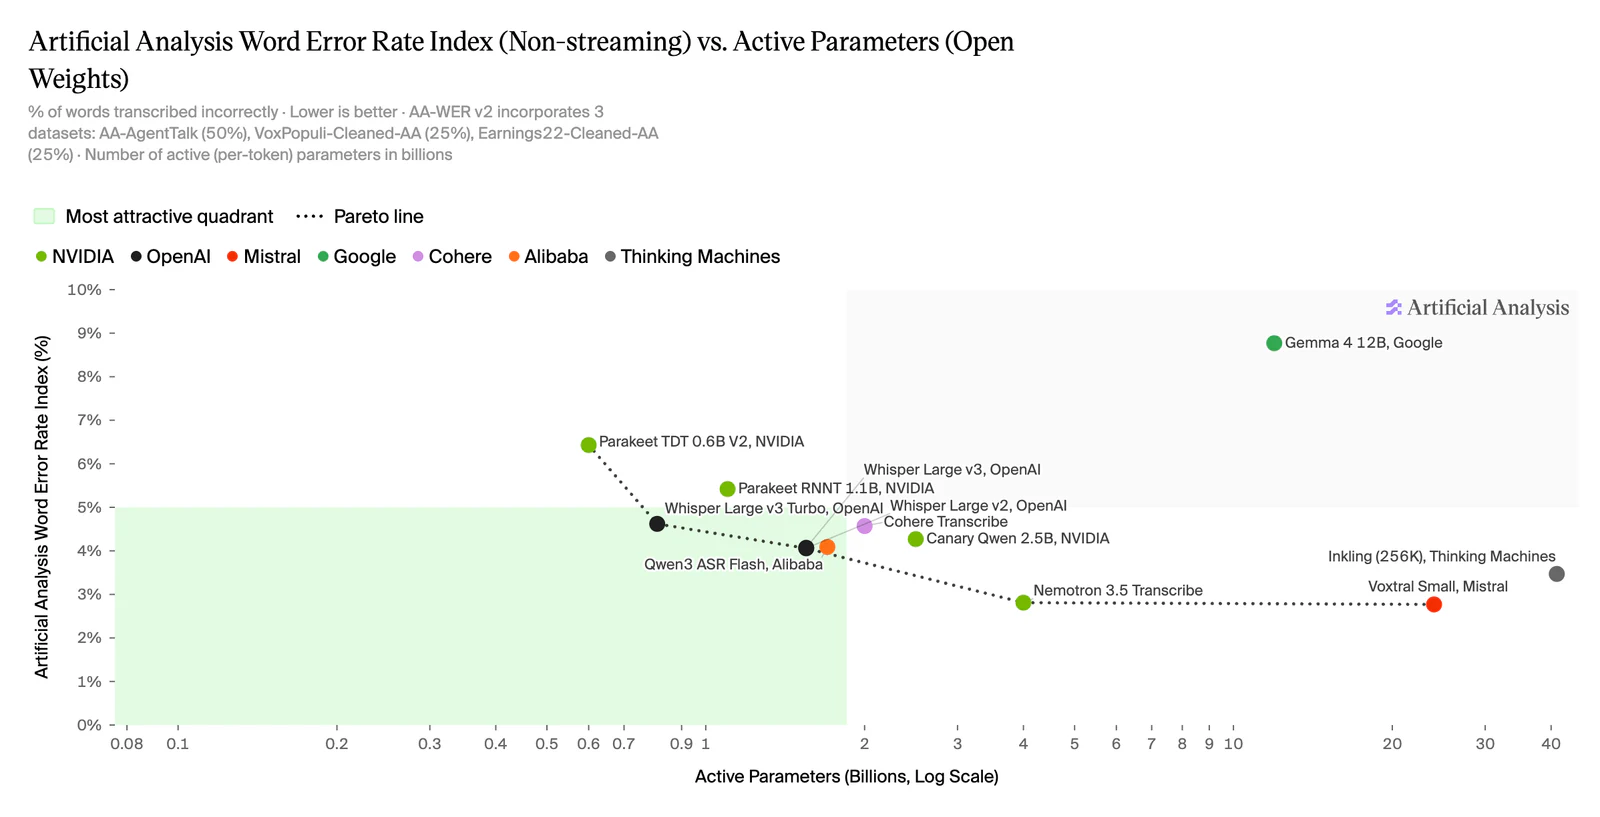
在单个 GPU 上的接近顶尖的准确率
该模型有 300 亿个参数,但在每个处理步骤中只有大约 40 亿个是活跃的。因此,它可以在单个 Nvidia GPU 上运行。这涵盖了从紧凑型 DGX Spark 到数据中心硬件的一切。Nvidia 表示,该模型在 RTX PRO 6000 Blackwell Server Edition 上以 NVFP4 精度在不到三分钟内处理 100 小时的音频。
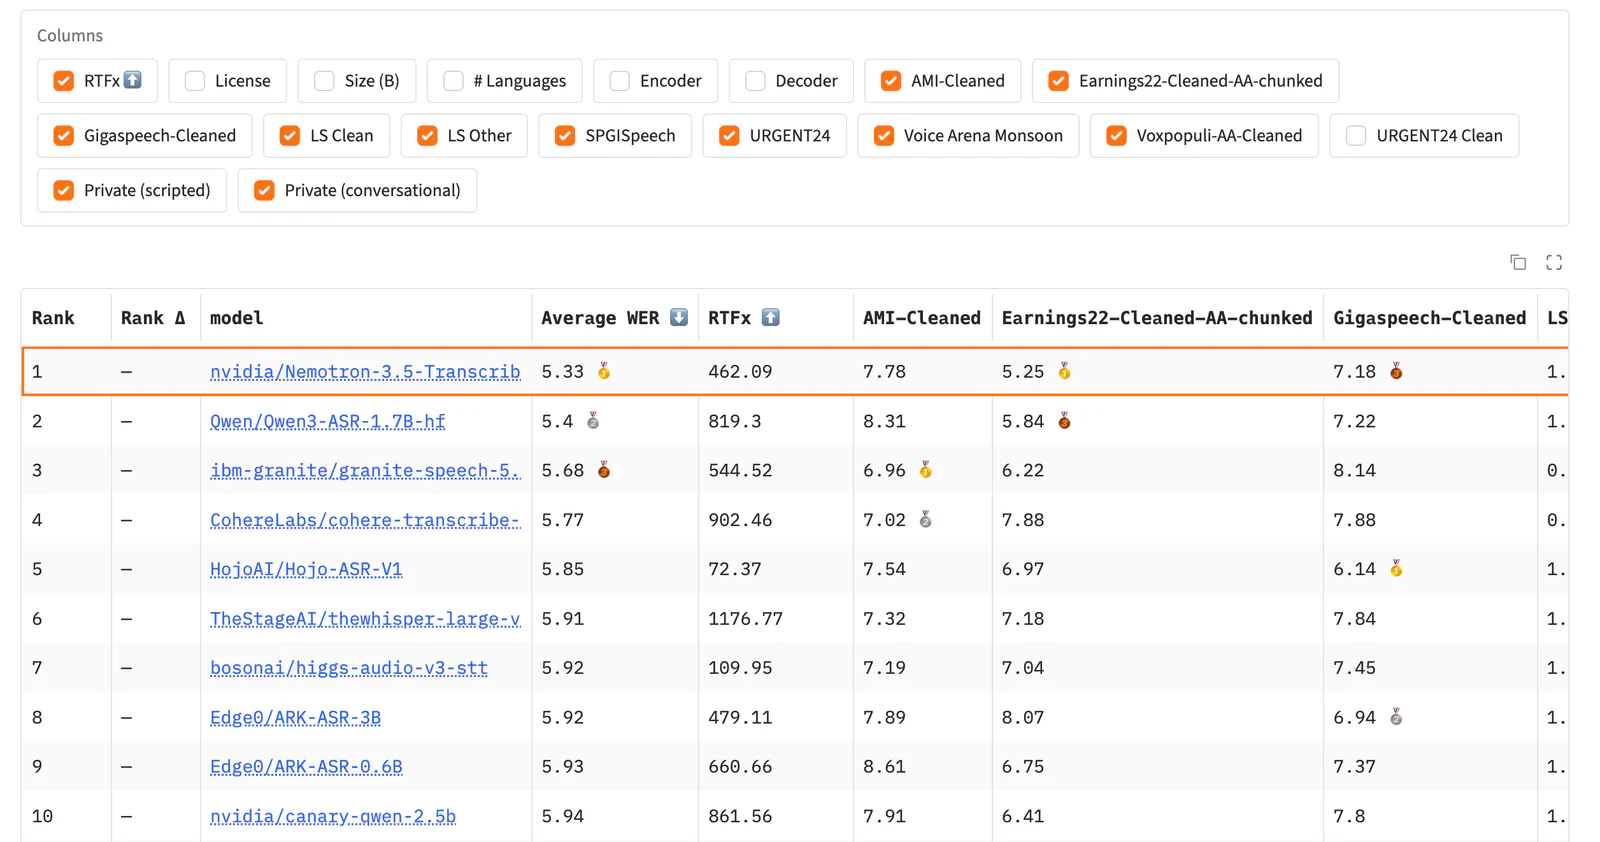
在 Hugging Face 的英语开放 ASR 排行榜上,Transcribe 在开放权重模型中排名第一,平均单词错误率为 5.33%。在 Artificial Analysis 的比较中,它的得分为 2.81%。这接近最佳开放模型 Voxtral Small 的 2.77%,但 Transcribe 只使用了大约六分之一的活动参数。根据 Nvidia 的说法,几种广泛使用的商业语音服务落后于其后。
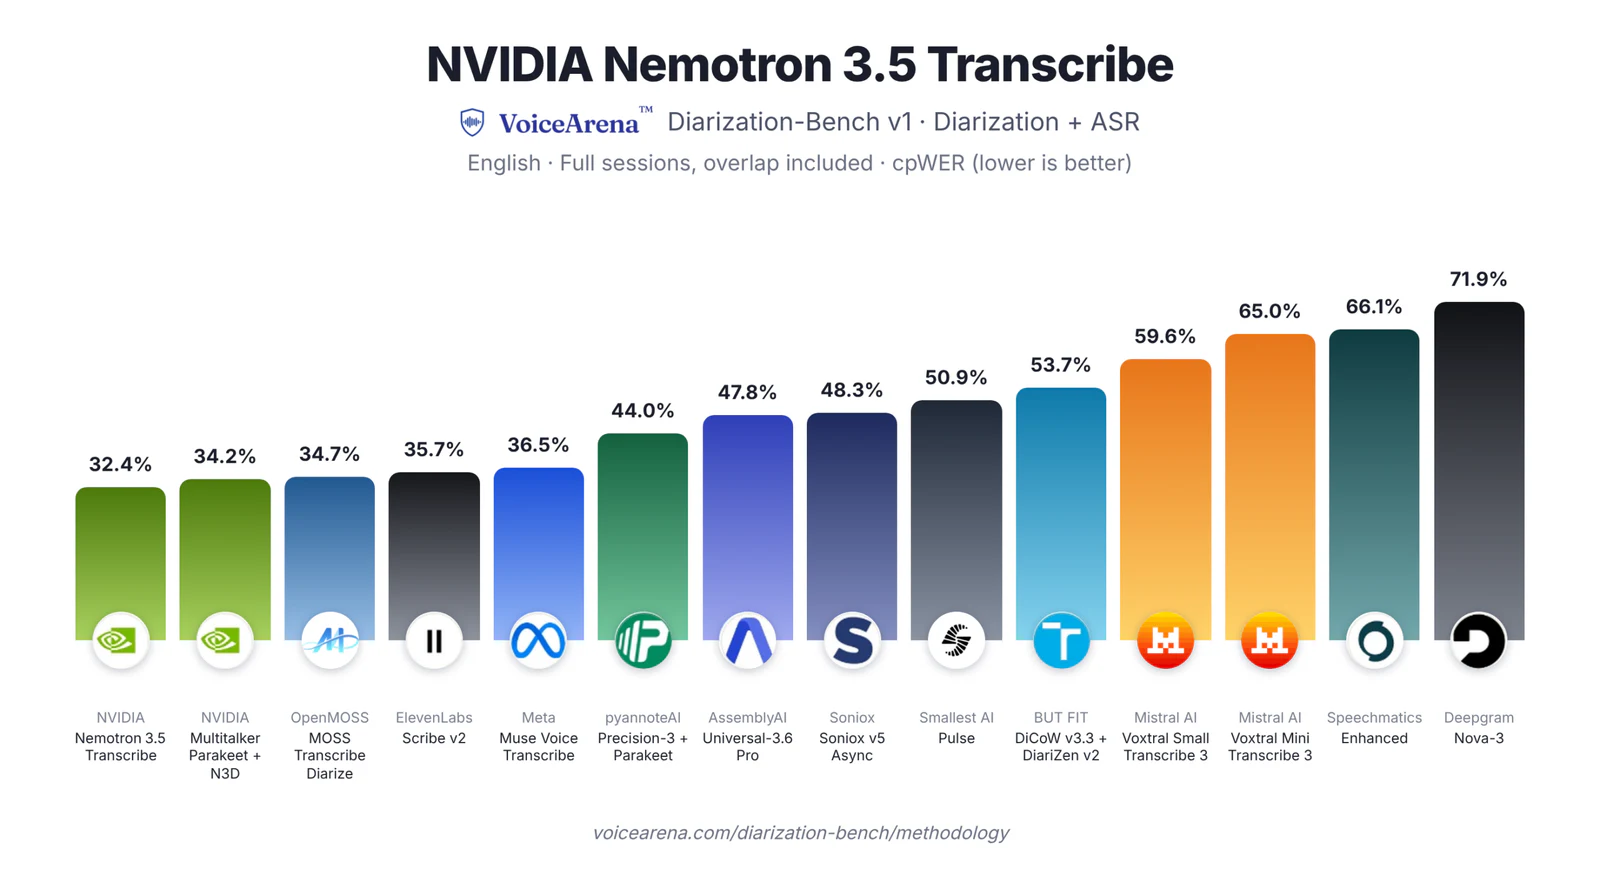
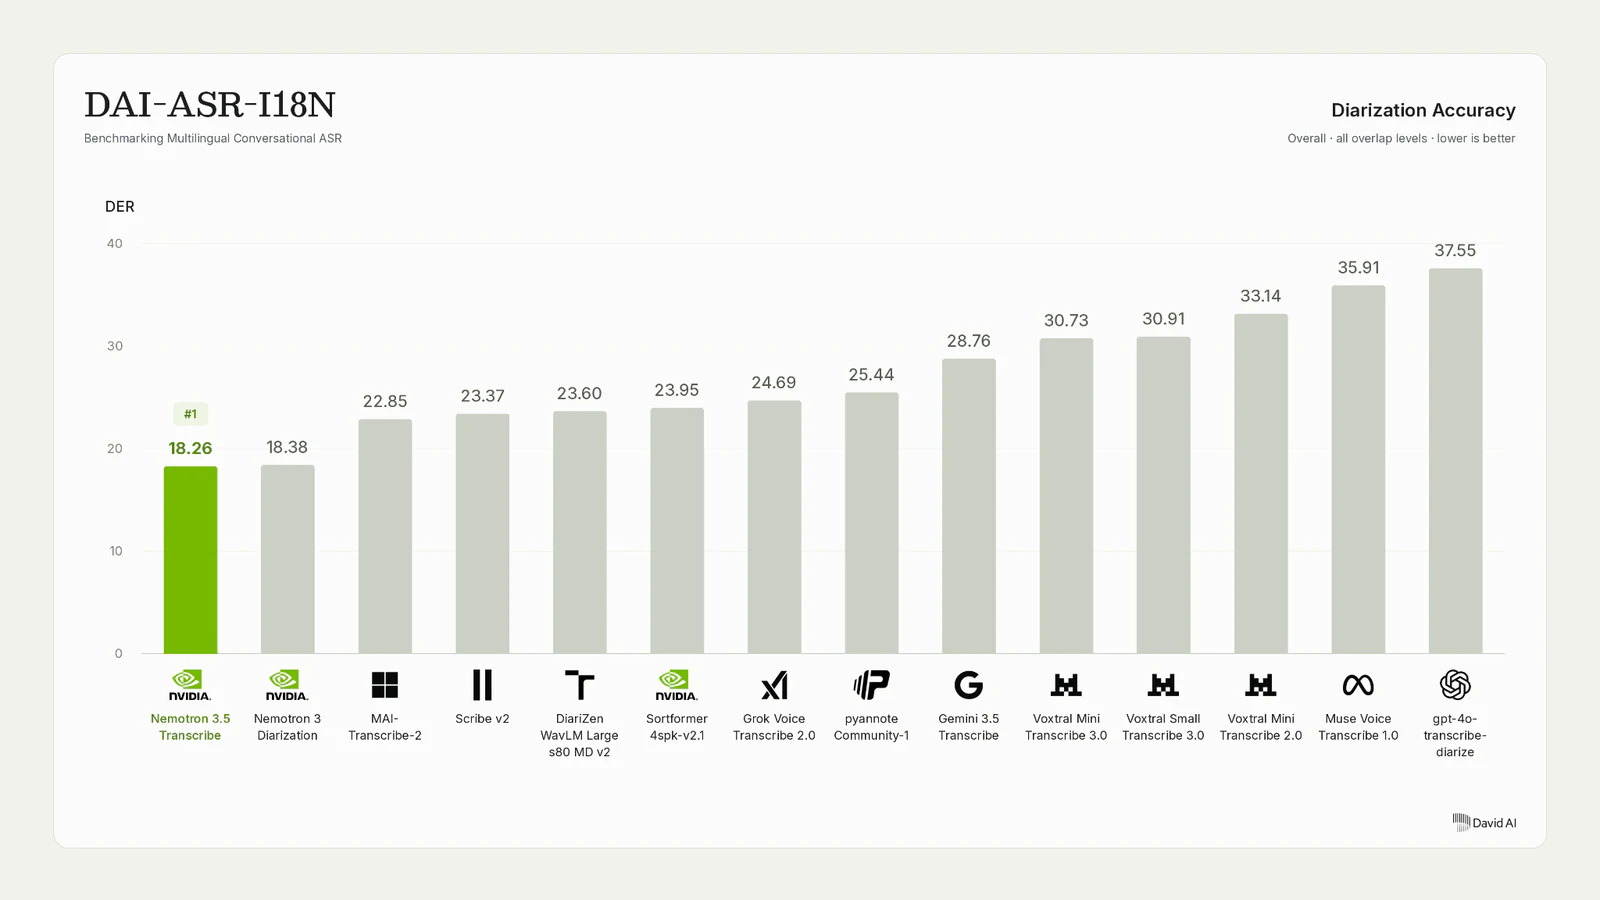
在说话人识别方面,领先优势最大。VoiceArena 在有时说话人互相打断的对话中测试了 14 个系统,Transcribe 获得第一名。它也是最少的单词丢失,与中值的约 31% 相比,丢失了 8.32%。在 David AI 的基准测试中,该测试测量了 21 种语言中的说话人归属,它获得了最低的错误率。它在 Nvidia 自己为该任务专门设计的模型之前完成。
开放数据集让开发者可以训练他们自己的领域
除了该模型之外,英伟达还发布了 Granary v2 数据集。该数据集包含约 844,000 小时的 48 种语言的语音,比上一版本中包含的约 643,000 小时的 25 种语言有所增加。每段录音都有多种转录风格。一种版本是逐字转录,包含 "uh" 等填充词和拼写的数字。另一种是清理过的版本,没有填充词,使用数字代替文字。英伟达还分享了构建数据集时使用的工具,以便开发者可以在自己的录音上运行它们。该公司表示,该数据集并不完全匹配模型的训练数据。
英伟达在印度医生和医学生的录音上测试了定向微调。在完整基准测试中,更精确的提示将错误率从 30.8% 降低到 23.8%。微调后,错误率降至 11.8%。训练数据大多是合成语音。对于模型之前未听过的说话者,英伟达单独报告错误率从 22.44% 降至 12.17%,相对改进了 45.8%。这使得改进后的模型领先于一个公开的医疗语音模型,该模型得分为 13.79%。英伟达表示,整个过程在一个 单个 Nvidia GB300 上大约花费了 14 个 GPU 小时。
这种专业化是有代价的。在一般英语语音上,错误率略有上升,而医疗模型在品牌名药物上保持更高的准确性。英伟达建议在构建自定义版本时,至少留出 100 段真实、经过验证的录音进行测试。
基础模型也有其局限性。功能因语言而异,英伟达表示音频问答功能是在英语中训练的。该模型也仅适用于录制的音频。英伟达表示用户应检查人名、说话者变化和答案。
该 模型 和 数据集 在 Hugging Face 上。还有一个 演示 可以尝试。对于微调,英伟达提供了指南和一个扩展,允许 AI 编程助手运行训练工作流。
英伟达最近在 9 月份才推出了 Nemotron 3 Diarization,一个专用的说话人识别模型,它可以区分最多八个说话人,即使在实时对话中也是如此,但它需要一个像英伟达的 Parakeet 这样的单独模型来进行实际转录。Nemotron 3.5 Transcribe 结合了这两项工作,并增加了翻译和音频理解功能。但它不支持实时处理。英伟达已经使用 Granary 数据集用于其 多模态 Nemotron 3 Nano Omni。
竞争对手设定了不同的优先级。Mistral 的 Voxtral 系列 也结合了转录和音频理解。随着 最近发布的 Voxtral 3,该公司专注于实时语音代理。
AI 新闻无炒作——由人类编辑
订阅 THE DECODER 以获得无广告阅读、每周 AI 新闻、我们独有的 "AI 雷达" 前沿报告(每年六次)、完整档案访问以及访问我们的评论部分。
来源: The Decoder · the-decoder.com