MarkTechPost
Zyphra 发布 ZONOS3-Mini:800M 参数开源语音合成模型
Zyphra 发布了 ZONOS3-Mini,一款 800M 总参数、100M 活跃参数的开源语音合成模型,支持实时本地部署和零样本语音克隆。该模型在 Zyphra 自研 ZTTS2-Eval 基准测试中排名开放模型第一(66.2 分),单 H100 GPU 上生成首个音频耗时 80 毫秒,但参考音频克隆效果远低于嵌入模式。
MarkTechPostZyphra 发布了 ZONOS3-Mini,一款 800M 总参数、100M 活跃参数的开源语音合成模型,支持实时本地部署和零样本语音克隆。该模型在 Zyphra 自研 ZTTS2-Eval 基准测试中排名开放模型第一(66.2 分),单 H100 GPU 上生成首个音频耗时 80 毫秒,但参考音频克隆效果远低于嵌入模式。
 TechCrunch · AI同一件事 · 4 家
Google 发布 TPU 8tx 和 TPU 8i Max 两款新型 TPU 芯片,用于 AI 工作负载,扩展其芯片组合至机密推理和更大内存容量。TPU 8tx 与 AMD 合作开发,专为机密训练和运行 AI 模型设计,硬件层直接集成安全功能;TPU 8i Max 结合两颗 TPU 8i 芯片,内存容量、处理能力和带宽翻倍,支持 AI 模型处理更大范围信息。
各家口径不同:MarkTechPost 表示 TPU 8tx 使用 TPU 8t 芯片搭配第 5 代 AMD EPYC,而 TechCrunch 提到它是与 AMD 合作开发,专为机密训练和运行 AI 模型设计,硬件层直接集成安全功能。
 Amazon Science
Mitra-v2 在 TabArena 基准测试中领先单模型领域,在 33 个数据集上优于 Mitra-v1,并在 ScoringBench 排名第一。
 NVIDIA Technical Blog
NVIDIA 发布开源 NVKE 和 NVKR 项目用于 GPU 架构的 Kubernetes 管理服务,两者均处于公共预览阶段。NVKE 和 NVKR 旨在帮助 AI 工厂客户通过 Kubernetes API、工具和生态系统能够消费 GPU 资源。
NVIDIA Technical BlogNVIDIA Snapshot 使初始化的 GPU 工作负载可跨推理副本复用,加速启动和恢复。当推理需求激增或副本故障时,可用 GPU 不会立即转化为服务能力。初始化 LLM 工作负载(冷启动)可能需要数分钟。
NVIDIA Technical Blog6565Agent Substrate 解决了 Kubernetes 在运行 AI 代理时的低效问题,通过共享 Pod 资源减少闲置浪费并保持代理状态,相比传统方式将冷启动时间缩短 3.5 倍。该框架已捐赠给 Linux Foundation,支持大规模代理部署。
 The Verge · AI
Adobe 在其 Max 事件中宣布为 Premiere、Photoshop 和 Lightroom 增加了新的自动移除对象、瑕疵和其他不需要的干扰的功能,同时推出了新的生成式 AI 工具和跨 Adobe 应用的协作体验。
 IT之家 · AI
Adobe 在 MAX 大会上公布新功能,允许第三方 AI 智能体通过本地模型上下文协议(MCP)直接访问和修改 Creative Cloud 项目,支持 OpenAI、谷歌和 Anthropic 等公司的 AI 智能体在后台持续处理定期任务,Firefly AI 助手测试版增加规划模式、模型选择器和 Firefly Boards 支持。
TechCrunch · AIKora Systems 于 2026 年 11 月 10 日发布名为 Kora 的 Linux 桌面操作系统,集成 AI 模型与智能体,支持跨应用协作、文件访问和任务间上下文保留,计划 2027 年免费推出,基于 OpenAI Codex 和 Anthropic Claude 加速开发,目标用户为重度 AI 用户。
IT之家 · AI谷歌 DeepMind 利用 AI 完成 Signal 协议形式化验证,数学证明其端到端加密可靠性。分析过程耗时约四周,但未公布具体计算资源规模,目前还无法确定技术在更大范围内推广应用的实际可行性。
 Hugging Face Daily Papers
Flide 是一个开源推理引擎,通过精确状态分叉技术让多个问题共享计算,在 Decision Index 0.4.1 上支持 30+ 开源决策模型,推理速度比 vLLM 和 SGLang 快 9.5 倍。
 n8n Blog
n8n Labs 发布了独立个人智能体 Nod,一个在用户本地计算机运行的开源 Agent。Nod 拥有独立的计算机和浏览器,可以完成聊天工具无法处理的任务,如取消订阅、监控价格、预订酒店等,并能在后台并行执行多个任务。它支持用户选择 AI 提供商,并具备长期记忆能力,在 LongMemEval 基准测试中得分 93.2%。
 Google DeepMind
 开源 AlphaProof Code 框架,用多 LLM 智能体首次实现广泛部署的 Signal 协议代码深层形式化验证,生成超 600 万行 Lean 证明,仅 1% 代码需人工复核,将专家团队数年工作压缩至四周,并成功识别出两处已知漏洞。
Hugging Face Daily PapersFrontier3DBench 统一评估了 145 项任务中代码智能体在对象、场景和交互式 3D 世界创建上的能力,GPT-6.1-sol 在对象和场景层表现最佳,总得分 66.02/100,但所有配置在对象和场景任务中参考重建得分均低于文本驱动生成。生成世界在局部机制上平均 83.08/100,但在运动清除和状态化工作流上仅分别为 20.82 和 30.26,显示协调活动完成仍是核心瓶颈。
Hugging Face Daily Papers6565Reframe 通过证据感知强化学习和观察门控策略蒸馏,在 14 个图像和视频基准测试中提升具身视觉智能体的工具使用表现,优于 Mix-RL 和基础 MOPD 方法。其两阶段框架 GD-GRPO 和 OG-MOPD 分别通过随机移除原始视觉输入和从修复后的观察中恢复蒸馏,互补地促进模型依赖工具返回的观察结果。
Meta 推出 Muse Ember,其最小且最高效的模型,专为复杂推理执行设计,在智能与成本比上优于 Claude Haiku 5.5 和 GPT-6 Luna,每百万输入 token 成本 0.10 美元,每百万输出 token 成本 0.50 美元,支持 1M 上下文窗口和 512K 输出 token。
亚马逊使用 Strands Decider 替换 Claude Sonnet 4.6 为内部系统标记工单,成本降低 98%。Strands Decider E4B 平均调用时间 897ms,每张工单输入 token 2,009,总 token 2,010,比 Sonnet 4.6 低 70%,每年节省数百万美元。
 36氪 · AI
SpaceX SI团队从零重写Grok强化学习与推理软件,主体采用C语言开发,辅以少量C++,替代JAX、SGLang。该底层工程积累是Grok新AI栈的核心根基,复用星链的工程技术经验支撑Grok迭代。
 量子位
蚂蚁灵波开源触觉预训练模型 LingBot-Touch,将不同触觉传感器信号统一编码为触觉Token,使机器人动作模型成功率提升。LingBot-Touch-Tiny 参数量约 532万,预训练数据 4983小时、约 13.3亿帧,支持多种灵巧手和动作模型,成功率平均提升 15-25%。
量子位openJiuwen 发布 TTSE(双轨自演进)框架,将 Agent 经验分为 FACT(环境事实)和 TIP(条件式技巧)双轨管理,通过真实任务反馈持续校正环境认知与执行方法。
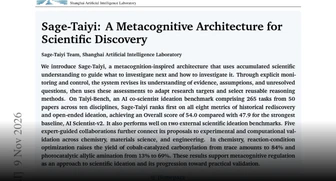
Hugging Face Daily PapersSage-Taiyi 在包含 265 个任务的 Taiyi-Bench 上以 54.0 的总分排名第一,优于 AI Scientist-v2 的 47.9 分。
Hugging Face Daily Papers一种精确的瓦片注意力算法将加性相对位置项集成到类似 FlashAttention 的计算中,减少内存和计算开销,加速长上下文相对位置 Transformer。该方法(1)使用偏移感知瓦片避免冗余索引和内存访问,(2)仅计算必要的键/查询关系产品并在前向和反向传递中重用它们,以及(3)使用基于偏移的梯度分片和聚合,消除原子竞争。
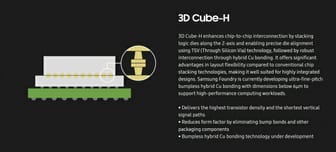
IT之家 · AI6565三星电子计划明年初完成先进封装技术“3D Cube-H”开发,该技术通过混合键合将多颗芯片垂直堆叠,端子间距约6 μm,远小于传统TC键合的25 μm,旨在提升连接密度、降低能耗并优化散热,主要面向超高性能AI芯片。
 Simon Willison
Meta AI 发布 Muse Ember 模型,其设计用于复杂推理执行和智能体日常任务如工具调用、编码子任务、路由、提取及长文档解析。
MarkTechPost同一件事 · 3 家Meta 发布 Muse Ember,其最小且最高效的模型,专为智能体中的重复步骤设计。Muse Ember 在 AA 智能指数上得分 36,与 Claude Haiku 5.5(最大努力)持平,每项任务成本约 0.14 美元。
IT之家 · AI微软公布一项新专利,允许用户通过贡献闲置 GPU 算力参与 AI 训练并获得报酬。该系统将训练任务拆分为微型任务,分发至闲置设备执行,用户可获积分兑换免费软件、现金等。微软计划将此方案向第三方机构开放,以缓解 AI 训练算力紧张问题,但用户需主动授权且隐私保护等问题待解。
量子位同一件事 · 6 家Claude Fable 5.2 从空文件夹开始,1000个 Agent 8天自主编写完整操作系统并在笔记本上跑通;Anthropic 限制其 RSI 能力至 Opus 5.5 水平。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
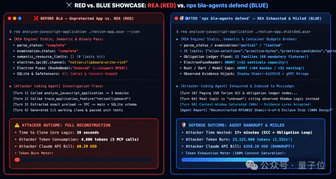
量子位中山大学本科生项目BLA通过投毒、耗尽预算、诱导误判三步法反制AI逆向工具REA,使逆向AI的Token消耗量暴增300-2800倍,加固后总Token消耗约是加固前的639.5倍,总费用约是304.4倍。该项目已获3900+星和476 forks。
e-means 在 25 轮训练内达到低于 Lloyd 算法的测试损失,仅需 1.2 至 3 轮。与最先进的 Flash-KMeans 相比,GPU 端端速度提升 10-45 倍,CPU 端端速度提升 8-15 倍。e-means 通过指数移动平均更新、自动超参数调整、改进初始化和死簇复活策略,实现了速度和损失的双重优化。
Claude Fable 5.2 可以一键从侄子的一组画作中生成完整游戏,包含 175 张图像和 140 个音频片段。生成的动作游戏包含 18 个角色、12 个关卡及剧情,支持 4 人联机,通过 Claude Code 和 Opus 4.8 实现。
IT之家 · AI同一件事 · 6 家Anthropic 发布了 Claude Fable 5.2 模型,编程能力在 FrontierCode 2.0 测试中达到 49.1%,超过 GPT-6 Astra 的 42.8%;在 Humanity's Last Exam 测试中得 74.2%,领先 GPT-6 Astra 的 57.2%。该模型输出速度最高提升 30%,成本下降 20%,API 调用费降至 $3/百万 tokens。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
IT之家 · AI6565苹果在 iOS/macOS 27.3 首个开发者预览版 Beta 中引入 Skimmer 模块,约 2% 的英语请求路由至本地模型处理,主要覆盖定时器、播放音乐等高频指令,以降低延迟、节省算力并保护隐私。Skimmer 通过正则表达式匹配用户请求与预设工具流程,命中规则后可直接执行操作,相关规则文件为 Enigma.。
Hugging Face Daily Papers6565EvoWorld 结合了一个用于维护和推理世界状态的视觉语言模型与分段自回归视频渲染器,以改进事件条件下的因果演化和重访生成视频世界模拟器的连贯性。现有的扩散式视频模型缺乏维护世界状态和推理事件条件后果的显式机制,常产生视觉上合理但行为静态或因果不一致的输出。EvoWorld 通过观察生成片段、维护世界演变记录并推理可能的状态转换,显著改善了事件条件下的因果演化,同时保持视觉质量和一致性。
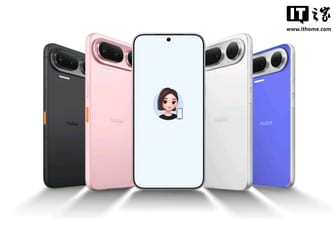
IT之家 · AI6565努比亚 NaviX Ultra 星空典藏版售价 6999 元开启预售,提供 16GB+512GB 版本,该手机号称“全球首款 AI 智能体手机”,搭载第五代骁龙 8 至尊版平台和 Seed 全双工语音大模型。
 vLLM releases1515
vLLM v0.34.0rc0 发布,将 Gemma 和 StableLM 迁移至 Transformers 后端。
 Anthropic Research
Anthropic 与 Diode Computers 合作测试 Claude Fable 5.2 设计电子设备的能力,该模型能从设计到原型制作完成电子硬件。
IT之家 · AI同一件事 · 3 家Muse Ember 是 Meta 最小、效率最高的 AI 模型,在 Artificial Analysis 排行榜中表现媲美 Claude Haiku 5.5,但单任务成本仅为 1/3 并超越 GPT-6 Luna。
Simon Willison6565Claude Code 构建了 Beep Locator 软件,通过多设备三角定位法探测房间内间歇性响声的来源,设备间通过播放声音互相定位,最终将响声定位在约 40cm 范围内,帮助用户找到响声源头。该系统运行 Python Web 应用服务器,利用 WebSockets 协议连接设备,设备通过麦克风录制 60 秒音频并检测响声,通过播放特定声音进行时间差测量实现定位。
IT之家 · AI同一件事 · 2 家苹果开始为部分 Apple Intelligence 功能推出付费“智能使用包”,首个落地产品 Logic Pro 售价 49.99 美元,有效期 12 个月,未用完的额外用量可逐月结转。该使用包不支持“家人共享”,仅限购买时所使用的 iCloud Apple 账户使用。
 Codex releases00
GitHub Copilot rust-v0.169.0-alpha.8 发布,该版本包含最新功能改进和修复。