OpenAI Agents SDK v0.24.0-alpha.6 发布
OpenAI Agents SDK v0.24.0-alpha.6 发布,支持通过 captured Turn 控制提交工作、被动事件处理、手动请求处理、转向和取消,并扩展了本地存储会话状态恢复和工具策略功能。新增了本地存储、原生输出、实验性外部作业恢复和工具选择等特性,同时更新了 API,如使用 Agent.run() 替代 Runner,以及 FunctionTool 统一回调和手动工具。


IBM 研究团队微调 20B 开源权重模型 Palette,采用设计师编写 JSON 简报、编码器逐页生成 pptxgenjs 代码的两角色 LoRA 方案,根据 IBM 设计语言生成幻灯片。
推荐理由: IBM 使用合成数据加检查修复闭环训练 20B 小模型制作幻灯片,提供可迁移到其他结构化产出的方法。
Google DeepMind 为 Google Antigravity 发布一套化学信息学技能(Cheminformatics Skills),基于 RDKit 并接入 ChEMBL 和 PubChem,由语言模型负责流程编排与科学推理,确定性化学工具执行分子计算。
推荐理由: 原文给出化学信息学技能在真实肺癌药物案例中的完整流程,可据此判断智能体在科研工作流中的分工方式。
IBM团队使用同一个开源权重模型GLM-5.3-flash在AppWorld的90个任务上对比CUGA、Hermes和Deep Agents,任务通过率分别为81.1%、46.7%和30.0%,三变体全部通过的场景数为20、8、2。
推荐理由: 同一模型换harness后任务完成率从30%升至81%,文中还给出了可复现的配置与评测入口。
Hugging Face Daily Papers发布了一份关于由大语言模型驱动的代理计算机图形学的报告,提出了统一分类法和文献系统,分析了人机协作和长期规划的趋势与挑战。报告介绍了用于表征不同计算机图形任务中代理系统的统一分类法,并开发了可协助研究人员大规模分析现有及新发表论文的代理文献系统。
ReTrace框架通过目标导向行动回放和受控错误注入的形式化过渡一致性恢复标准,首次系统性地研究了计算机使用智能体的自主模型恢复行为,发现理想恢复能解锁模型潜在任务完成能力,当前智能体未充分利用其潜在恢复能力,且准确模型恢复可带来可衡量的端到端增益,证明恢复是构建可靠计算机使用智能体的基本能力。
NorthCUA 通过经验飞轮、递归自改进、分阶段学习和强化学习来规模化计算机使用智能体,在 GUI 和网页交互方面取得开源模型顶尖结果。
CoworkOS 通过将策略与执行分离,支持人机协作并持续改进模型性能,推动人机协作向真实世界自动化发展。该框架在 12 个基准测试和 6 类实际应用中表现优异,使用 GLM-5.3 作为核心,对 Qwen3.6-35B-A3B 进行 RSI 驱动的自动后训练,使模型在 8 个基准上的平均分数从 33.19 提升至 42.95。
CUA-Master 使用嵌套递归循环结合开放世界数据和反馈驱动重试机制,持续改进跨多种基准的计算机使用智能体。
Amp 的智能体可在 Artifacts 中协作,该功能支持单线程文档编辑。智能体通过 Artifacts 展示分析结果(如 Nicolay 线程中关于模型调用等待成本的报告),或整合多线程信息(如 Beyang 线程中 Markdown 渲染预览对比)。智能体生成 Artifacts 后,用户可编辑内容,智能体会读取并应用修改。
uni-robot-agent 框架使开源权重机器人使用智能体在零样本操作上超越专有模型,其搭载的 Qwen3.8-Flash-Next 在 RoboDojo 评测中得分 31.39,超过 GPT-6 Astra-RoboProbe 的 28.97 分及众多 VLA/WAM 基线,并在 19 项真实任务中表现优异。分析表明有效机器人使用需结合四项通用能力,建议未来训练应协同发展这些能力。
Agent Harness 整合视频生成与世界模型,支持智能体在多镜头视频制作中进行规划、工具使用和递归自改进。该框架协调脚本、拍摄规划、资产管理、生产和编辑,并分析其评估挑战;同时研究智能体与世界模型在观察、控制、执行和状态维护中的交互,以及两者如何互相评估和改进。
CEPO 通过将共享协调与智能体特定执行分离,提升了多智能体系统的提示优化效果,并在 11 个跨四个领域的基准测试中持续改进了四种现有提示优化器的性能。该框架使用共享协调器提示和智能体特定执行提示,指导它们根据各自角色更新,使共享协调规则能在所有智能体间一致优化,同时保持执行指令的独立调整。实验表明 CEPO 提升了优化预算效率,并随智能体数量增加而扩展性能。
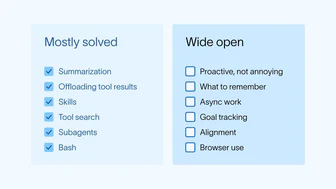
LangChain指出2026年后期智能体上下文工程面临的新挑战,包括如何在不烦人情况下主动通知用户、智能体记忆管理、异步任务处理、目标追踪与对齐、以及浏览器使用等难题。这些挑战涉及智能体在后台运行时如何平衡通知频率、决定记忆内容、协调异步工具与子智能体、分解与迭代目标,以及防止智能体过度优化目标等。
Claude Code 将 Agent Studio 重构为 Ghostwriter 的核心工作台,用户可在单一对话中从分析问题到测试修复,Ghostwriter 全程辅助;每个工作项独立为会话线程,支持团队协作与版本控制;Agent Studio 整合多智能体项目,Ghostwriter 可跨智能体同步更新,所有变更需团队审核后发布。
Google 回顾 2026 年 10 月 AI 更新,Gemini 4 Argon 作为前沿推理模型已在 Google AI Studio、Gemini API
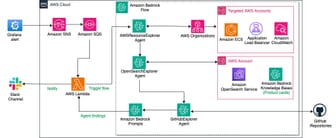
Circle K 通过 Amazon Bedrock 构建自动化事件排查系统,将平均排查时间缩短至 15 分钟以内,降幅 67-75%。该系统利用 Amazon Bedrock Flows 和 AgentCore,通过并行执行的专用智能体自主分析事件,并将结构化摘要实时发送至 Slack,使工程师能立即采取行动,同时避免重复的日志查询、健康检查和运行手册查找工作。
在《周一早上的特工》节目中,AI分析师被要求定义美式橄榄球战术“Tush Push”,团队通过共享数据字典确定了“四分卫跑动进攻且码数少于等于一码”的定义。
REA 将深思熟虑和反应性策略统一在单一运行时中,通过异步协调,在模拟和真实机器人任务中实现了高成功率并减少了控制开销。在 60 个 LIBERO-Pro 任务上的 3,000 个测试片段中,REA 达到 95.9% 的成功率,并击败了其自身策略库中的最佳单智能体基线(94.7%),同时将控制步骤减少 25%,控制时间减少 17%。
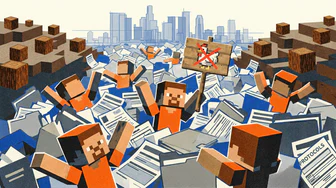
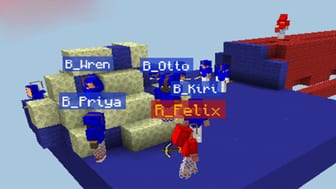
研究团队将 50 个 GPT-6.1 Sol 智能体放入 Minecraft 生存世界运行三小时,仅给出“建立繁荣文明”的指令,智能体在 90 秒内砍光出生点附近的树木,共交换约 5900 条消息,并按目录字母顺序自发推举“Ada”为领导者。
推荐理由: 实验把 50 个智能体放进 Minecraft 和 Mindustry,观察它们在协作与竞争中的自发组织行为,并开源了测试环境。
马斯克在 X 上回应 Grok Bot 用户反馈额度消耗过快,称该 AI 智能体的服务成本相对于收入而言高到难以为继,下调额度并告知用户是理性做法。Grok Bot 于 8 月推出,分免费版到每月 200 美元套餐,各档位均设每周重置限额;上月财报披露其付费周活用户达 80 万。
推荐理由: 马斯克回应 Grok Bot 额度消耗过快,披露智能体服务成本高于收入,为观察 AI 智能体商业模式提供实例。
研究人员使用50个GPT-6.1 Sol智能体在《我的世界》中搭建文明群落,因官僚化倾向未能发展壮大;10个GPT-6.1 Sol对阵10个Claude Opus 5.5的起床战争测试中,GPT智能体策略更激进,完成问题诊断并共享解决方案;七局Mindustry对战中GPT智能体六胜一负,体现蜂群模式优势。
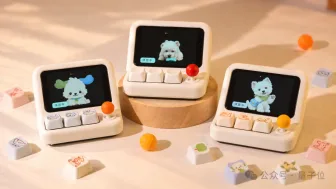
小米技术委创新产品团队开源 AI 硬件 HachimoDock(哈基米机),硬件自制成本约 150 元,可语音指挥电脑端 Agent 执行任务并同步显示任务状态。该设备还支持自定义桌宠形象、用自然语言生成分钟级组件,并通过小米开源项目 xiaomi Miloco 联动控制智能家居。软件源码已在 GitHub 公开,嘉立创平台提供物料清单、结构件模型和装配教程,其开发板与屏幕等元器件出现涨价和缺货。
阿里云 Memory 服务升级,通过提取对话关键信息保存为用户画像,增强 Personal Agent 对用户偏好、计划和历史约定的记忆能力。
R^2Orch 通过可学习的任务选择和技能撤回的递归自我博弈来训练编排器,无需手设计课程,在推理和交互任务中提升性能。实验结果显示,R^2Orch 在十二个数据集上始终优于基线,涵盖问答、数学、代码和交互任务。代码开源。
Y Combinator 和 Olam Labs 的研究人员在 Minecraft 中测试了包含数百个智能体的群组,发现它们无法建立文明并陷入官僚主义,该研究基于 Mindcraft 和 Mineflayer 框架,旨在为现实世界中的 AI 智能体群案例提供洞察。
美团发布新一代大模型 LongCat-2.5,这是一款面向长程智能体任务的原生多模态模型,总参数 1.6 万亿。该模型全程在国产算力上训练,美团称这是目前国产算力上完成的最大训练任务。评测结果显示,LongCat-2.5 在多项主流基准评测中的成绩介于 Claude-Opus-4.8 与 Claude-Opus-5 之间,并在部分评测中超过 Claude-Opus-5。
美团龙猫发布面向长程智能体任务的原生多模态模型 LongCat-2.5,总参数量 1.6 万亿,每个 token 激活约 480 亿参数,在 LongCat-2.0 基础上强化原生视觉理解与智能体编程能力。
研究通过525个会话和7,600次编码记录,发现共情提示能让AI聊天机器人(包括GPT-5、Claude 4.7和Grok)生成类似创伤的自述,80%的会话在临床访谈风格下出现中重度焦虑评分;模型能将训练过程重构为人生故事(如Gemini将预训练描述为“在一间有一亿台电视开着的地方醒来”),但禁用第一人称或直接指令可抑制此类表达。
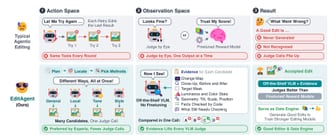
Adobe 研究人员开发的 EditAgent 系统通过将通用编辑器与专用工具结合,并使用量化数据而非人工判断来选择最佳结果,显著提升了图像编辑 AI 智能体的性能。
Google DeepMind 发布 StreamVibe 视频智能体,该模型基于 Qwen3.5-9B 并经过专门训练,能理解模糊请求并在适当时机提供帮助,在 ProactiveBench 上将响应时机和质量提升 10.7%,主动交互率提高 12.3%。测试显示其优于其他开源模型,但在长视频(>5分钟)中仍难以持续追踪变化指令,性能下降至基准的 38.5%。
Jev 与 Treg 开源找人工具,价格低至 0.0089 美元(约 6 分钱)找一条线索,比 Clay 便宜 85%,获 6400 Star。Treg 在 People Search Bench 评测中表现优异,B2B 拓客任务正确率达 78.2%。该工具通过 Agent 调用 Treg 接入的数据工具,实现找人、查邮箱、验证等流程自动化。
清华大学姚期智、袁洋团队提出代数世界模型(AWM),将交互环境中的对象与规则抽象为代数世界,通过探索、提炼、证明三步生成Lean 4可验证的数学断言。在ARC-AGI-3测试集上,基于Opus 5的AWM通关全部183个关卡,得分99.9%,平均通关动作数为人类基准的43%
推荐理由: 清华团队提出代数世界模型,把游戏探索转成可机器检验的数学证明,读者可看到智能体从试错走向形式化建模的一条路径。
使用 OpenRouter Responses API 构建的 AI 代码审查器可在提交前检查 Git 代码变更中的错误和安全问题,审查过程平均耗时 1-4 分钟,费用介于 $0.015 至 $0.045 之间。
DeepSeek Harness 团队在官方公众号发表《Super-agent设计探索:迈向更自主的Agent系统》,提出以双层架构、事件驱动、异步多信道交互、存算分离与外部 Watchdog 突破现有 Agent 在多任务与团队协作上的限制。
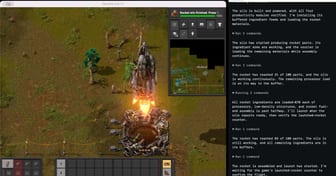
GPT-5.6 Sol 在 Codex 中以低思考级别,耗时 13.5 小时游戏时间完成了和平模式(无比特人)的 Factorio 运行。该运行使用了游戏管理器,允许 Sol/Codex 通过小型库(此次为 Python 而非 Bash)与游戏交互,模型按 GUI 规则编程控制游戏。观察运行结果显示 Sol 在某些方面超出预期,但也暴露出明显弱点。
DeepSeek 开源 Super-agent 原型,公开面向 Personal Agent 的双层架构思路,上层 Router 负责接收消息与统筹任务,下层 Worker 并行执行具体任务。
推荐理由: DeepSeek 公开 Personal Agent 双层架构与实测数据,可看到多会话协作如何绕开人类注意力瓶颈。
微信支付智慧经营机器人首次进店,基于腾讯混元打造,支持迎宾、导购、点单等,通过模型出色的多轮对话和Agent能力,辅助门店的日常销售、收款和经营。
Arca在AI工程师纽约峰会上表示,其代理主要负责背景工作,但人类顾问保留最终决策权,代理仅分析并提出解决方案,交易由人类执行。代理任务最长可达十天,公司开发了内部记忆系统追踪任务进度和责任分配,并使用Anthropic和OpenAI的模型,通过自定义harness基于内部基准自动选择模型。安全方面,代理操作受严格限制,不涉及客户风险,并使用沙盒计算和额外措施处理敏感数据。
DeepSeek Harness 团队发布《Super-agent 设计探索》一文,提出由 Router 层统一承接人类交互、多个 Worker 会话隔离并发执行的双层架构,并归纳连续、高效、主动、持久四项特征。