Hugging Face Daily Papers6565
对MLLM检索头的更广泛研究
在18个语言、视觉语言和全模态模型中,检索头在新增模态(如视听)中保持稀疏,且跨模态共享程度高,全模态模型主要保留其骨干模型的检索头;移除这些检索头会消除几乎所有视听检索能力。
Hugging Face Daily Papers6565在18个语言、视觉语言和全模态模型中,检索头在新增模态(如视听)中保持稀疏,且跨模态共享程度高,全模态模型主要保留其骨干模型的检索头;移除这些检索头会消除几乎所有视听检索能力。
 量子位精选7575
SoMark 团队开源 1.3B 文档解析模型 OXR,在 OmniDocBench(97.18)、olmOCR-Bench(87.84)和 DocParsingBench(87.76)三项榜单排名第一。
推荐理由: 1.3B 模型靠 RSI 后训练在三个文档解析榜单登顶,并给出可插拔架构与免费 API 的工程取舍。
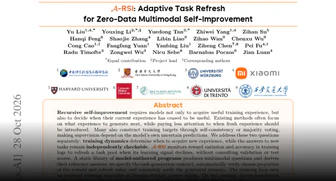
Hugging Face Daily Papers6565A-RSI 通过基于学习信号下降刷新训练任务,并使用可独立验证的程序生成答案,在无需外部标签的情况下提升基准测试性能。该模型监控训练日志中的奖励变化和准确率来刷新任务池,并利用静态模型自编程库生成多模态问题及其参考答案,同时自动验证奖励和刷新规则的属性并审计生成答案。在十一项基准测试中,A-RSI 通过 800 个新任务将平均性能从 57.77 提升至 61.05。
 IT之家 · AI5858
百度开源发布文心 Unlimited OCR 2 模型,支持一次性解析累计超过 3,600 页文档,原生支持版面要素切分识别及跨页文案合并、表格识别合并,在 MPDocBench 基准测试得 84.6 分、MarathonDocBench 基准测试得 77.1 分。
 MarkTechPost5858
Edge0 发布开源文本转语音模型 Audio8-TTS-Realistic,0.6B 参数量支持 23 种语言零样本语音克隆,在 CV3 基准测试中平均误差率 4.86% 优于 Qwen3-TTS-1.7B 和 VoxCPM2,但低于 4B 级别的 Higgs TTS 3。模型采用双自回归架构,包含 24 层宽度 896 的慢分支和 4 层并行预测快分支,并使用学习型真实感评论家进行训练。
Hugging Face Daily Papers6565研究通过难度度量形式化基准评估,识别测量不匹配和覆盖缺口,提出诊断指标和重写算法改善基准覆盖;分析25个跨7领域的流行基准,发现多数基准隐式高估特定难度区域或未覆盖难度轴大部分区域,限制模型改进监控能力;引入BenchFill算法有效减少局部覆盖缺口。
IT之家 · AIAI模型处理不同语言时Token消耗量最高可相差17倍,英语及其他主流语言用户成本更低。隐性“分词器税”导致网络内容较少的语言用户需支付更高费用,影响响应速度和上下文容量。AI实验室需公布各语言评估结果并改进分词器设计以缩小差距。
 Databricks Blog4747
Databricks 宣布 Spark Declarative Pipelines Real-Time Mode 正式可用,该模式通过持续流式处理、并行查询阶段和即时数据传递实现毫秒级端到端延迟。
 Cohere Blog3434
使用 Cohere Embed、Rerank 和 Parse 与 Amazon SageMaker AI、OpenSearch Serverless 和 Amazon Bedrock 结合,搜索金融报表并生成带页面级引用的答案。
MarkTechPost4747Prime Intellect发布Prime Mega MoE,在DeepSeek融合Mega MoE内核基础上增加快速重叠反向传递,使其可用于训练。
 Epoch AI6565
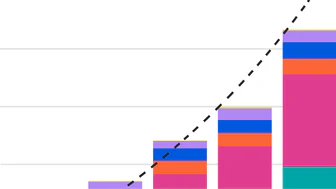
Epoch AI分析全球AI芯片销售数据,以H100等价单位衡量计算能力,每季度增长呈指数趋势,表明计算能力每9个月翻倍。
 NVIDIA Technical Blog3535
NVIDIA 通过优化 Tensor Core 性能,显著加速机器学习原子势能计算。其技术可提升量子力学方法如密度泛函理论(DFT)的计算效率,平衡成本与精度。该方案适用于大系统或长时间模拟,但具体参数规模、benchmark 分数及可用性(开源/闭源/API)原文未提供。
 Hugging Face Blog
Project ProtoStar 项目发布,旨在通过使数据集、模型和代码更易获取和复用,解锁公共资助科学研究的潜力。该项目汇集了大学、研究机构、产业和开放科学社区,支持以 AI 兼容、机器可操作的格式发布科学成果,并通过一系列公开挑战展示其价值。首个挑战由卡内基梅隆大学主办,将于 11 月 2 日启动。
Hugging Face BlogHugging Face 发布 Granite Switch 4.1.1,在 4.1 基础上增量更新,保留完全向后兼容性。新增多语言语音转写模型(支持 10 种语言带原生标点)和 Jev 决策指数测试集性能提升的决策适配器。团队通过仅更新适配器未重新计算基础模型,实现快速部署,未来将支持第三方自定义适配器。
IT之家 · AI6565今日宜休在 ISHO 今日宜休 AI 睡眠科技生态产品发布会上公布战略,聚焦精准监测、科学干预与精力恢复,计划一年内采集超 1000 例金标准临床 PSG 数据,并将科研范畴从夜间睡眠质量延伸至日间精力状态。
 Hacker News · AI 热帖
DAYJOB: Tax 评估 AI 代理在 8 个税务领域的 50 项专业任务中的表现,要求代理完成税务申报、合规和咨询工作。Claude Sonnet 5.5 在排行榜上以 10.8% 的通过率领先,Claude Opus 5.5 通过率为 9.2%。该基准包含 1,789 个工作空间文件,涵盖各种税务场景和复杂材料,由税务专家创建和审查。
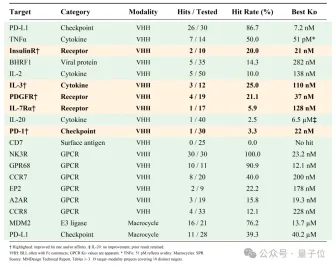
量子位分子之心AI蛋白质从头设计平台MMDesign完成18个设计项目,成功率94.7%,其中六个GPCR靶点全部命中,最优亲和力达纳摩尔级;平台通过“生成-筛选-验证”工作流,在计算空间生成数万个候选分子后,仅测试9-50个即获成功,整体候选命中率30.7%,展现出高效精准的分子设计能力。
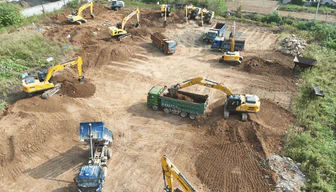
量子位威卡移动控制发布具身智能赋能工程机械高质量数据集,包含3600万帧、12类典型作业场景,已上线Hugging Face。该数据集通过“视觉、激光、位姿、力馈、手柄输入”五大维度同步对齐采集,覆盖多品牌挖掘机机型,旨在解决具身智能行业数据稀缺痛点,推动工程机械智能化与少人化。
Hugging Face Daily PapersRSI Arena 证明自主 AI 智能体能独立用人类反馈训练和迭代改进语言模型,多数智能体在第二阶段实现偏好增益,尽管基准测试提升有限。十款前沿模型作为训练智能体,从 NVIDIA Nemotron 3.5 Lightning 30B-A3B Base 开始,在第一阶段六天内独立选择数据、实施训练、选择检查点,使用 64-GPU 集群和 300 美元 API 信用。
 OpenRouter Blog
Anthropic/claude-haiku-5.5 模型配合严格 JSON schema 可从 PDF 中提取表格并返回类型化行,测试五份 PDF(含扫描件)成功提取所有 644 个单元格,失败案例源于 PDF 处理路径而非模型能力,需注意空结果和输出长度限制。
Databricks BlogProcore 通过 OpenSharing 将连接后的建筑数据以程序化方式共享至客户现有环境,支持 Power BI、Tableau、Snowflake、BigQuery、Databricks 工作空间或本地 SQL Server,用于报告和下游分析。
 Anthropic Newsroom
Anthropic 扩展 AI for Science 项目,向全球 20 家科研机构、基金会和研究中心提供免费 Claude 信用额度,支持高影响力科学项目研究。
 LangChain Blog
OpenWiki 使智能体在需要跨来源连接的问题上准确率比单独搜索高约 5 倍,添加证据图将准确率再提高 27% 并使引用一致性翻倍。
 TechCrunch · AI
英伟达发布开源语音转写模型 Nemotron 3.5 Transcribe,支持 40 种语言转写,含 30 亿参数,可在 Jetson AGX Thor 和 DGX Spark 芯片上运行。该模型能翻译 31 种语言、区分 8 个说话人,并在 Hugging Face Open ASR Leaderboard 基准测试中超越竞品,但仅支持录制音频。
IT之家 · AI摩尔线程开源 Megatron-MUSA-Titan 项目,支持万卡级集群的万亿参数 MoE 模型训练,覆盖预训练与强化学习场景,实现高 MFU 与长稳训练。项目支持 blockwise FP8 训练,结合 DeepEP 与 ACE 异步通信引擎加速 Token 分发与结果合并,提升端到端训练效率。
Hacker News · AI 热帖Survival LLM 是一款完全在个人电脑上运行的免费 AI 助手和应急知识库,无需互联网即可提供基于可信来源的答案,并显示答案来源。
MarkTechPost6060FlashMap通过连续流图绘制器将离散扩散绘制器替换为连续流图,在Qwen3-8B上对GSM8K实现高达6.14倍的无损速度提升,其绘制器权重(Qwen3-8B和Qwen3-4B)已开源至Hugging Face,支持vLLM和SGLang插件。
IT之家 · AI6565开发者在 DeepSeek Harness GitHub 代码库中发现 deepseek-v5、deepseek-v5-open 和 deepseek-v5-next 三个模型标识符,目前仅作为框架占位符。
Hugging Face Daily Papers6565大规模评估显示,专用记忆系统常弱于简单检索增强生成,引入记忆收益与记忆税框架评估净价值。记忆在长时程智能体中日益普遍,但构建记忆相较于直接从原始历史检索的净价值仍不明确。
Hugging Face Daily Papers6565HABIT-Bench 评估智能体从数百次会话的合成用户历史中习得习惯的能力,要求智能体整合零散证据并选择新请求的适当行动。使用 Qwen3-235B-A22B 和 GLM-5.3-Flash 评估八种记忆方法,最佳配置在四选任务中达到 33.61% 宏平均准确率,优于随机猜测的 25%。即使提供标注证据,仍存在大量错误,表明理解应如何指导决策比单纯回忆历史更重要。
IT之家 · AI6565前英特尔 CEO 基辛格通过风投机构 Playground Global 支持内存初创公司 Nagare Labs 开发 Z2RAM 内存技术,完成 500 万美元种子轮融资。Z2RAM 采用氧化物半导体材料,计划通过标准后端工艺(BEOL)实现多层存储结构,无需 EUV 光刻,目标比特密度达 SRAM 的 5 倍以上,计划四年内推出样品。
Hugging Face Daily PapersHarness Self-Evolution通过元技能指导技能适应来改进LLM代理,无需参数更新即可提升弱模型性能。研究发现,技能对强模型有益但对弱模型可能有害,在七种模型和三种基准测试中,有103个任务-技能对使GPT-5.6-luna提升了31.1分,但使Gemma-4-E4B降低了8.8分。
Hugging Face Daily PapersOvisOCR3是一个0.8B视觉语言模型,通过多导师蒸馏和强化学习统一多种OCR任务,在文档解析、通用OCR、关键信息提取、图文描述和跨页表格重建等任务上达到SOTA结果,在OmniDocBench v1.6上获得96.74分,在OCRBench v2英语和中文拆分中排名第一,并在多个基准测试中超越基线模型。
Hugging Face Daily Papers6565Redistribution sensitivity score (RSS) 识别在 27 个预训练 SAE 模型(覆盖 8 个语言模型)上产生可重复特征重新分配模式的特征响应,结合 clean margin 可量化其对下游读出的贡献。
MarkTechPostUC Berkeley 的 Sky Computing Lab 开发了开源向量索引 LEANN,通过查询时重新计算嵌入而非保存到磁盘,将 6000 万片段维基百科索引从 201GB 压缩至 6GB。该索引在 NQ 基准上达到 25.5% 的准确率,使用 4GB 存储空间,但检索耗时 2.48 秒(HNSW 为 0.05 秒)。代码采用 MIT 许可,支持在笔记本电脑和工作站上运行。
 Ars Technica · AI6565
Pinal 可通过自然语言提示生成蛋白质,成功率达特定功能要求;Hugging Face 同步推出 DNA 级别类似工具。Pinal 采用 T2struct 将提示转为结构蓝本,再由 SAProt-T 结合概率评估生成序列,基于三大数据库及 AlphaFold 预测训练。
Databricks BlogDatabricks Lakehouse Federation允许用户通过标准SQL直接查询外部数据库(如SQL Server、PostgreSQL等)中的数据,无需迁移。
Databricks Blog4545Databricks Vital Skills 通过开源 Agent Skills 标准为 Genie Code 增强医疗健康与生命科学领域知识,使其在 BiomniBench 基准测试中得分提升。
 AWS Machine Learning Blog3434
Property Finder 在迁移视觉 AI 工作负载至 Amazon Bedrock 时发现其评估数据集 96.8% 的标签来自单一模型的预测而非人工验证,导致新模型客观比较受阻。该公司通过人工专家独立标注 356 张图像构建可信基准数据集,并采用进化式提示优化迭代 27 次后,在保持 86% 准确率的同时将成本降低 86%。
Hugging Face BlogHugging Face 发布 Old Ideas, Novel Problems 研究,评估六款 LLM(GPT-5.1至5.4、Claude Sonnet 4.5至4.6)判断科研创新性的可靠性。