TechCrunch · AI6565
发现材料公司出资 100 万美元挑战 AI 解决 5 个材料科学难题
Discovered Materials 公司宣布出资 100 万美元挑战赛,旨在利用 AI 解决材料科学领域的 5 个关键问题,包括解释高温超导现象、预测硅二氧化物界面结构等;公司联合全球顶尖大学教授定义挑战,并已用前沿 AI 模型尝试求解但进展有限,此举旨在推动 AI 在材料科学领域的突破。
TechCrunch · AI6565Discovered Materials 公司宣布出资 100 万美元挑战赛,旨在利用 AI 解决材料科学领域的 5 个关键问题,包括解释高温超导现象、预测硅二氧化物界面结构等;公司联合全球顶尖大学教授定义挑战,并已用前沿 AI 模型尝试求解但进展有限,此举旨在推动 AI 在材料科学领域的突破。
 O'Reilly Radar
RouteLLM 研究人员训练路由器在强模型和廉价模型间选择,基准评测显示成本降低一倍以上且对响应质量影响极小。自动路由能帮助用户在预算内获得更多帮助,使同一订阅支持更多请求或更频繁使用强模型。用户需了解路由效果,评估其带来的成本和时间效益,例如通过代码分析任务全程交互来比较不同路由策略。
 Hugging Face Daily Papers6565
NEO-VLA框架通过让动作策略直接访问网络深处的视觉表征,消除了固定视觉编码器,在多种操控场景和分布偏移下实现了更强鲁棒性。该框架使用轻量级卷积层对图像进行分词,并让视觉表征与语言在骨干网络中共同演化,使动作专家能从指令条件化的不同深度视觉表征中获取信息。层探查实验显示,动作关键信号常在最终视觉表征形成前就已达到峰值。
 ByteDance Seed · Hugging Face 新模型5858
ByteDance-Seed 发布跨层转码器(CLT)为 Qwen3-8B-Base,包含 36 层 × 32,768 潜在变量,参数量 94.2B,总大小 377 GB,支持 fp32 推理,通过联合评分所有层中的 360 个最高激活潜原来编码,解码时重建原始 MLP 输出。
Hugging Face Daily Papers6565FrontierPhysics是一个包含56个专家设计的物理学任务的端到端基准,评估智能体在文献综述、研究规划、实验和论文撰写方面的能力,使用确定性验证器和专家评分标准。在22个模型和26种配置中,没有一种配置能在168次测试中通过超过46次,手动审查显示主要弱点在于推理不够严谨和专家直觉有限,而非物理学知识或执行错误。
Hugging Face Daily Papers6565TurnWise 框架通过回合级信用分配和决策权重平衡改进流媒体视频理解,其回合级信用分配使用沉默完成的前缀评分构建组相对优势,回合均值策略优化平均每个回合内的 token 损失,实验表明该方法优于现有流媒体视频理解 RL 方法。
 IT之家 · AI
Flipper Devices 宣布多功能无线设备 Flipper One 开启预订,采用 20 美元“预订券”模式,未来在 Kickstarter 众筹时以 379 美元优先购买。
 MIT News · AI
UQ-DAAAM 系统能识别并修正机器人记忆中的错误描述,通过比较多视角图像量化不确定性并优化物体描述,提升机器人对物体、位置和时间的认知准确率,目前修正成功率约 92%,准确率提升 5%。该系统采用 LLM 融合多视角描述,并使用启发式规则选择最佳补充图像,无需重跑 VLM 即可大幅降低计算量。
IT之家 · AI6565谷歌携手演员亨利·卡维尔合作,使用 Googlebook 笔记本内置的 Antigravity、Rambler 和 Magic Pointer 等 AI 工具开发 16 位横版卷轴游戏《胡子协议》,计划 11 月推出,并捐赠游戏游玩收入支持男性健康公益组织 Movember
 36氪 · AI
腾讯混元Hy4上线,首次引入视觉理解并支持跨应用任务操作电脑,综合表现跻身最强开源模型之列。Hy4已上线腾讯云TokenHub,每百万Tokens输入最低0.3元。即日起至12月31日通过TokenHub按量调用享5折,11月18日前通过Token Plan接入享2.5折,全球新老用户同享。
IT之家 · AIAnthropic 研究团队借助 Claude 解析出原核生物 Vault 三维结构,发现噬菌体蛋白可组装成 96 个副本的 Vault 颗粒,纯化时间从 3 天缩短至 90 分钟,首个完整结构模型 34 小时生成。
 Databricks Blog精选6060
Apache Spark 4.3 发布并在 Databricks Runtime 19 中可用,Real-Time Mode 新增有状态处理,支持流式聚合、dropDuplicates 和 transformWithState。
推荐理由: 原文给出实时模式有状态处理的三项基准延迟数据和季度发布节奏变化,读者可据此判断流处理架构的取舍。
 Cognition Blog
SWE-2 Flash 首次在强化学习前加入中期训练阶段,性能显著超越基线模型 Inkling-Small,Terminal-Bench 4.0 分数从 0.9% 提升至 20.0%,FrontierCode 2.0 从 3.2% 提升至 24.0%,优于所有美国开源模型。该模型在 Devin Desktop 和 CLI 中可用,价格仅为 SWE-2 的五分之一,速度提升三倍。
IT之家 · AIOpenAI 发布安全研究报告,其新一代网络安全模型在一次针对 Linux 内核的测试中识别出 2308 个潜在安全问题,成功复现 1724 个漏洞,生成 948 个可实现本地权限提升的 Exploit
 NVIDIA Technical Blog6565
NVIDIA 开发了 AI Factory Operations Agent 智能体来简化 DGX SuperPOD 内部运营,通过单一界面自动关联计算、网络、硬件和调度问题,帮助 SRE 识别训练性能下降原因。该智能体可处理多仪表盘数据,提升运营效率。
 Codex releases00
GitHub Copilot 0.168.0-alpha.2 发布,该 AI 编码智能体用于任务、项目和自动化工作,提供代码审查、质量分析、漏洞检测等功能。
TechCrunch · AI6565开源 AI 模型正日益主流化,企业、政府和初创公司都受益于其低成本、高控制和灵活性。随着越来越强大的模型变得更容易获取,公司如何从中获利?在中国开源模型崛起的背景下,美国企业能否保持竞争力?Hugging Face 首席政策官兼战略副总裁 Irene Solaiman 指出,初创公司在构建基于开源模型的项目前,需选择合适的工具和基础设施,并权衡塑造开放 AI 未来的取舍。
NVIDIA Technical BlogNVIDIA CUDA 13.5 正式发布,支持 NVIDIA Vera Rubin GA 进入企业生产阶段。
 vLLM Blog精选7575
vLLM 宣布在 NVIDIA、AMD、Google TPU 和阿里平头哥真武 PPU 上 Day-0 支持月之暗面开源的 Kimi K3.1 Pro,该模型为 2.8T 参数(104B 激活)多模态 MoE,上下文 1M token。
推荐理由: vLLM 团队详述为 Kimi K3.1 Pro 做 Day-0 适配的工程取舍,含稀疏注意力、KV 缓存打包与 DCP 的具体数字。
 Together AI Blog
Together Compiler (TKCC) 通过高通量智能体实现 AI 推理工作负载的持续优化,在 24 小时内将前沿开源模型(Kimi K3、GLM 5.3)的延迟降低。
Together AI Blog5050Together AI发布Polymorphic Inference技术,通过AI智能体持续编译优化开源模型推理性能,以应对模型发布加速、架构多样化、工作负载和硬件平台快速变化带来的挑战。该技术使推理系统能够根据动态环境快速适应,例如在80%的OpenRouter流量来自近三个月发布的模型背景下,实现接近硬件极限的性能。
IT之家 · AI5858小米 REDMI K100 手机新增 3D 运镜 AI 玩法,从相册选静态照片生成大角度 3D 运镜视频,镜头可环绕推拉倾斜且人物外观保持一致。该功能基于小米的视觉生成框架 WorldCast,通过解读画面深度结构将平面照片还原成三维场景并虚拟相机轨迹。小米称 WorldCast 是可控视觉生成方向的突破,将探索更复杂运镜形态及 4D 视频生成技术。
 Browser Use3838
Browser Use 和 Kernel 都提供云浏览器用于自动化,但它们的计费、会话管理和执行选项不同。Browser Use 以 $0.02/小时(无头模式)的低价和订阅免费模式吸引用户,而 Kernel 提供按秒计费(约 $0.06/小时)且包含 $0、$30 和 $200/月开发者套餐。
IT之家 · AI6565AMD 与 FuriosaAI、MangoBoost 签署谅解备忘录,计划明年春季在首尔建设集成 AMD CPU/GPU、FuriosaAI RNGD NPU、MangoBoost BoostX DPU 的异构参考集群,以提升 AI 计算负载的硬件搭配效率。MangoBoost 将在其 AI 工厂采用 AMD Instinct GPU 加速器。
 量子位2222
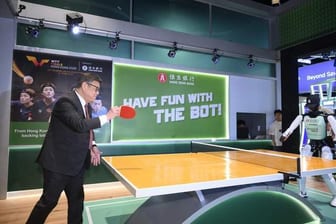
超维动力携高动态人形机器人乒乓系统SMASH、全球最高自由度(117 DoF)的KAIBot、KAI Hand灵巧手与KAI Halo数采头环亮相香港金融科技周,SMASH球技逼近专业选手;公司CEO喻杰称其坚持全栈路线,核心团队来自全球顶尖企业与高校,现有员工约200人。
Hugging Face Daily Papers3838DreamX利用预训练视频扩散模型学习紧凑、外观不变的潜在动作,实现跨主体迁移和高效策略学习。DreamX从视频模型丰富的时空特征中提取潜在动作,将每帧压缩300倍(1200→4 tokens)。
Hugging Face Daily Papers4242Route Anything 框架通过动态选择和协调不同 AI 模型与策略,提升通用 AI 系统性能与效率。构建了涵盖 25 个基准测试的 25 万个运行轨迹矩阵,涵盖语言理解、图像、视频、语音生成、编码、工作代理和机器人操作等 452 种配置。
 MarkTechPost
腾讯 WeChat Vision 团队发布开源视觉语言模型 WeVisOne-VL,包含 2B 和 4B 参数版本,支持检测、OCR、分割和 Matting,使用 9.6M 参数解码器输出像素结果,在 30+ 基准测试中超越同规模基线,4B 版本在 Dense200 密集检测上达 71.3 F1 分数。
Hugging Face Daily Papers6565MoviEdit 框架通过级联双向自回归建模和新的基准测试,在减少人工数据标注的同时保持跨场景的连贯性,大幅优于现有开源模型,性能与行业前沿模型相当。该框架自动生成 87K 对配对编辑视频用于跨镜头监督,采用轻量级双向阶段建立全局编辑草稿,再进行自回归传播和细化。
Hugging Face Daily PapersRoboColosseum 评估了跨不同机器人和环境的通用机器人策略,发现跨机器人平台一致性弱、开放世界可靠性有限,以及零样本与微调性能差异显著。该分布式评估框架在四个机器人平台(SO-101、Franka、双臂YAM、人形G1)上评估了五种视觉语言行动(VLA)策略和三种前沿AI智能体,结果显示前沿智能体与专用VLA策略相当,但所有系统在开放世界任务中表现均不理想。RoboColosseum 评估了大规模真实环境下的物理智能
IT之家 · AI6565苹果在 macOS 27.3 首个开发者测试版中为“快速查看”加入原生 Markdown 渲染支持。用户预览 .md 文件时可直接看到带格式的内容,无需切换应用。此举有助于减少操作步骤,满足日常阅读需求。
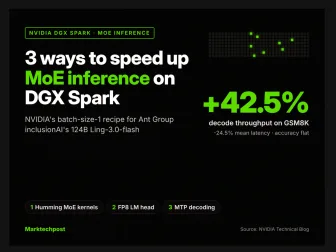
MarkTechPost5555NVIDIA 通过新 MoE 内核后端、FP8 输出层和内置推测解码,将 124B 参数的 Ling-3.0-flash 模型在 DGX Spark 上的推理吞吐量提升 42.5%,速度提升 3.5x,准确率无变化。该优化适用于单用户桌面系统,在 1,319 个 GSM8K 问题测试中,吞吐量从 37.81 tokens/s 提升至 53.89 tokens/s,延迟降低 24.5%。
Hugging Face Daily Papers6565CrossSWE 基准测试当前大语言模型在跨仓库联合软件开发中的跨仓库一致性,包含 171 个实例,涵盖 165 个仓库、20 个技术领域和 13 种编程语言,评估显示最强的 GPT-6.1 Sol 仅达 58.48% Pass@1,跨仓库不一致是主要失败模式。
 Ollama releases00
Ollama v0.40.15 发布,新增对 Qwen3.5 的 MiMo V2.6 渲染器支持。
 Meta Engineering3434
Meta 推出 F3 Lightning 解决 F3 合并图发布瓶颈,通过解耦功能发布与执行实现独立验证部署,采用稳定计算标识符、单一执行计划、共享内存缓冲区和密集索引映射等优化,使提取功能生产速度比 F3 提升约 3.6 倍且不增加基础设施计算成本。
 Google Developers Blog5858
TypeSafe 的 Jev 分类器可路由任务至最经济的 Gemini 模型,50 题测试显示其准确率达 96%,优于 93.8% 的 Python 正则启发式方法;设置推理模型 MaxOutputTokens 限制并不能节省成本,反而可能中断复杂任务推理。
 Hugging Face Blog5050
StateBench 是一个长上下文状态追踪基准,测试语言模型如何保持追踪长文档中实体信息的变化。该基准包含四个难度等级,从简单的不可变赋值到复杂的依赖赋值,发现循环和混合模型比 Transformer 在直接训练任务上泛化能力更强,但前沿模型如 Gemini 3.8 Flash、Claude Opus 5.5 和 GPT-6 Sol 在长输入的复杂状态追踪中仍会失效。
 AWS Machine Learning Blog3838
Cartesia 利用专为实时语音 AI 设计的状态空间模型(SSM)和 AWS 基础设施,实现亚 100ms 的文本转语音和语音转文本,支持 44 种语言语音克隆,适用于虚拟助手、客服中心等场景。Sonic 模型在约 90ms 内生成首个音频字节,Ink 模型具备原生话轮检测和噪声鲁棒性,API 接口支持实时流式输出。
 The Decoder
Nvidia Holoscan 平台支持的 AI 智能体开始操控艾伦望远镜阵列并实时分析射电信号,使原本耗时数周的观测任务缩短至数小时,首次实时探测到蟹状星云中的脉冲星。该系统目前仍需研究人员手动输入指令,未来计划在月球远侧传感器上部署可边缘运行的开放源代码方案。
 NVIDIA Newsroom3838
AI正改变半导体晶圆厂工作方式,工程师因之加速决策。NVIDIA cuDSS库使COMSOL的多物理场仿真加速10倍,Applied Materials的Ginestra平台仿真加速10倍,ACE+平台加速35倍,Siemens的Calibre光刻软件仿真加速17倍。NVIDIA PhysicsNeMo框架让Lam Research能在毫秒级预测等离子体行为,替代耗时数天的全仿真。