Ollama releases6565
Ollama 支持小米 MiMo V2.6 模型及 AutoTrust 决策模型
Ollama 现在支持小米 MiMo V2.6(9B 参数代码与智能体工作流模型),以及 AutoTrust 决策模型(包括 9B、35B 和 27B-VL 版本,35B 和 27B-VL 可处理图像)
Ollama releases6565Ollama 现在支持小米 MiMo V2.6(9B 参数代码与智能体工作流模型),以及 AutoTrust 决策模型(包括 9B、35B 和 27B-VL 版本,35B 和 27B-VL 可处理图像)
 MarkTechPost同一件事 · 2 家6262
百度发布 ERNIE 5.5 Flash Base,一个 280B 参数稀疏 MoE 基础模型,每 token 激活 14B 参数,支持 128K 训练上下文和 1M 推理上下文。
 Hugging Face Blog精选7171
NVIDIA 在 Cosmos 世界模型平台下新增四个 Cosmos 3 开源权重检查点,均为 Cosmos 3 Nano 的后训练版本,含 16B 可训练参数,采用 OpenMDW1.1 许可,允许商用与非商用。
推荐理由: 原文给出四个开源权重检查点及四阶段后训练配方,读者可据此判断如何把世界模型适配到自有传感器与机器人本体。
 SemiAnalysis
Google TPUv7 Ironwood 在 Qwen 3.5 397B FP8 上单次推理性能每美元优于 B200 和 B300 50%,并在多模型 AgentX 基准中展现竞争力或最佳结果,支持 vLLM、SGLang 等生态,但 NVIDIA 对此反应激烈并加速研发。
 The Decoder同一件事 · 2 家
百度发布 ERNIE-5.5-Flash-Base 开源基础模型,含 2800 亿参数,采用混合专家架构,单次输入激活 140 亿参数,预训练覆盖 3350 万亿 tokens,支持高达 128 万 tokens 的训练上下文,推理时上下文最长可达 100 万 tokens。
 Databricks Blog5858
Databricks 与 Linux Foundation 于 2026 年 6 月宣布 Delta Sharing 升级为 OpenSharing,将共享范围从 Delta Lake 表扩展至包含 Agent 技能。
 OpenClaw Blog
OpenClaw Multiplayer 允许多人共享同一智能体和上下文协作,无需重构对话或传递指令,已支持 50+ 人在同一环境中协作。
 Google AI Blog精选同一件事 · 3 家7878
Google 发布 Gemini Omni 1.2 Flash,并通过 Gemini API 和 Gemini for business 正式开放。原生视频生成时长从 Omni 1.1 的 10 秒提升到 15 秒,可按 1 秒步长指定 3 至 15 秒,720p 价格降至每秒 0.07 美元,比 1.1 下降 30%。
 Google DeepMind精选同一件事 · 3 家7878
Google DeepMind 发布了 Gemini Omni 1.2 Flash,原生视频生成时长从 Omni 1.1 的 10 秒提升到 15 秒,并已在 Gemini API 和 Gemini for business 全面开放。
推荐理由: 原文列出了时长、价格和参考一致性的具体变化,读者可据此判断视频生成的成本与工作流会怎样变化。
 Microsoft Research
PDD Kit 将用户意图转化为形式化规范,并验证智能体为每个输入编写的代码是否符合该规范,同时辅以测试。团队在 GitHub Next 的 Chopin 环境中使用 PDD Kit 正式验证了 Rust 编写的 Pet Store 登录逻辑,Verus 工具发现并修复了现有 Bug,证明规范下无登录 Bug。
The Decoder精选7070腾讯发布 Hy4 模型,首次具备图像理解能力,并能自主操作 Blender、CAD 等软件,权重将在稍后未定日期开放,目前仅通过腾讯云、OpenRouter 和元宝等应用提供。
推荐理由: 腾讯 Hy4 首次加入图像理解与电脑操作能力,第三方评测与官方说法存在差距,可对照看开放权重模型的真实位置。
 NVIDIA Newsroom3838
NVIDIA 通过全栈协同设计提升内存效率,在 GPU、CPU、网络、存储和软件各层优化内存使用。Blackwell Ultra 显卡使每 GPU HBM 容量提升约 3%,而 SemiAnalysis AgentX 上的智能体推理成本降低 30 倍。
 LangChain Blog
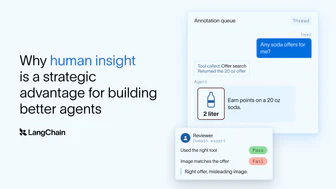
LangChain 探索人类反馈三原则提升智能体开发:专家判断定义质量标准,完整上下文评估,将反馈转化为可复用数据;通过 agent trace 记录用户交互与模型行为,人工标注评分并附理由,用于校准自动化评估器、改进评估标准与构建黄金数据集,形成专家知识可复用资产。
LangChain Blog5252LangSmith Bring Your Own Cloud (BYOC) 现在支持 AWS (GA)、Azure (Beta) 和 Google Cloud (Beta),用户可将追踪、评估、数据集、提示词和智能体部署保留在自选云账户中,LangChain 负责数据层管理。
 ByteDance Seed · Hugging Face 新模型
ByteDance-Seed/Qwen3-30B-A3B-MoE-SAE 发布,包含在 Qwen3-30B-A3B 模型第 4、30 和 46 层训练的 TopK 稀疏自编码器(k=100,2^20 潜在变量),每个 SAE 约 17.2 GB,重建方差未解释分数分别为 12.6%、25.1% 和 7.6%。
 IT之家 · AI4242
大疆发布 Matrice 5T 无人机,首次在轻型行业无人机上标配激光雷达、毫米波雷达与全彩全向视觉感知系统,售价 57,488 元。配备原生 1K 热成像相机、多焦段可见光相机,支持 IP55 防水等级,最长飞行时间 59 分钟,内置机载算法可辨别超 20 种目标类型,开放算力可导入第三方 AI 模型。
 O'Reilly Radar
RouteLLM 研究人员训练路由器在强模型和廉价模型间选择,基准评测显示成本降低一倍以上且对响应质量影响极小。自动路由能帮助用户在预算内获得更多帮助,使同一订阅支持更多请求或更频繁使用强模型。用户需了解路由效果,评估其带来的成本和时间效益,例如通过代码分析任务全程交互来比较不同路由策略。
 Hugging Face Daily Papers6565
NEO-VLA框架通过让动作策略直接访问网络深处的视觉表征,消除了固定视觉编码器,在多种操控场景和分布偏移下实现了更强鲁棒性。该框架使用轻量级卷积层对图像进行分词,并让视觉表征与语言在骨干网络中共同演化,使动作专家能从指令条件化的不同深度视觉表征中获取信息。层探查实验显示,动作关键信号常在最终视觉表征形成前就已达到峰值。
ByteDance Seed · Hugging Face 新模型5858ByteDance-Seed 发布跨层转码器(CLT)为 Qwen3-8B-Base,包含 36 层 × 32,768 潜在变量,参数量 94.2B,总大小 377 GB,支持 fp32 推理,通过联合评分所有层中的 360 个最高激活潜原来编码,解码时重建原始 MLP 输出。
Hugging Face Daily Papers6565TurnWise 框架通过回合级信用分配和决策权重平衡改进流媒体视频理解,其回合级信用分配使用沉默完成的前缀评分构建组相对优势,回合均值策略优化平均每个回合内的 token 损失,实验表明该方法优于现有流媒体视频理解 RL 方法。
MarkTechPost同一件事 · 2 家Google AI Research 发布 Agile Deliberation 框架,通过人类参与循环将模糊概念转化为结构化定义,用于灰色区域图像分类。该框架基于 Gemini 2.5 Pro 和 Gemini 2.5 Flash API,无需微调,平均 F1 分数比零样本 Gemini 2.5 Flash 高 10.5 分,付费场景下 F1 达 0.59。
各家口径不同:谷歌研究提到用户实验减少疲劳和焦虑;MarkTechPost 关注 F1 分数提升。
IT之家 · AI英伟达发布 CUDA Toolkit 13.5,正式支持下一代 AI 计算平台 Vera Rubin 并面向企业生产环境部署。更新升级了 GPU 资源调度、多 GPU 通信、数学计算库及性能分析工具,优化了 cuBLAS 对 NVFP4、MXFP8 低精度矩阵运算,提升训练和推理吞吐量。
IT之家 · AI6565TVPort 开源项目基于 nxnative 工具包和 Claude Opus 5.5,让 Apple TV 4K 原生运行 Switch 游戏《超级马力欧:奥德赛》,实现 60FPS 运行,偶有轻微卡顿。项目需用户自行提取游戏数据,使用改装 Switch,并非面向普通用户方案。
 36氪 · AI
腾讯混元Hy4上线,首次引入视觉理解并支持跨应用任务操作电脑,综合表现跻身最强开源模型之列。Hy4已上线腾讯云TokenHub,每百万Tokens输入最低0.3元。即日起至12月31日通过TokenHub按量调用享5折,11月18日前通过Token Plan接入享2.5折,全球新老用户同享。
IT之家 · AI6262昇腾基于 vLLM Ascend、SGLang 同步实现 0 Day 推理适配 Kimi K3.1 Pro,支持 2.8 万亿参数模型在 Atlas 800 A3、900 A3 SuperPod 及 950 超节点系列上部署,模型原生支持视觉理解并具备百万 token 上下文窗口。
 Epoch AI6565
Epoch Capabilities Index (ECI) 更新采用贝叶斯模型方法论,提供更可靠的模型能力不确定性估计及模型间能力比较概率。新方法基于四参数逻辑斯蒂(4PL)项目反应理论(IRT),使用 Claude 3.5 Sonnet(ECI 130)和 GPT-5(ECI 150)作为锚点模型,通过线性变换固定参数位置和尺度,实现跨时间一致性。
 The Verge · AI6565
AT&T连接生活智能安防系统成为首个接入Google Home Premium的产品,通过Gemini for Home实现事件摘要、视频搜索等AI功能,支持自然语言查询活动记录。该集成仅限每月29.99美元的AT&T专业监控计划用户使用,并新增基于用户位置自动布防/撤防功能。
 Google Research同一件事 · 2 家
Agile Deliberation 框架通过迭代对话协助人类定义主观概念边界,将模糊想法转化为精确的 AI 指令蓝图。该框架分为概念界定和概念迭代两阶段,通过直接反馈处理模糊图像,在 18 次 1.5 小时用户实验中显著降低用户疲劳和焦虑,使 AI 模型性能优于标准基线。
各家口径不同:谷歌研究提到用户实验减少疲劳和焦虑;MarkTechPost 关注 F1 分数提升。
 AWS Machine Learning Blog4141
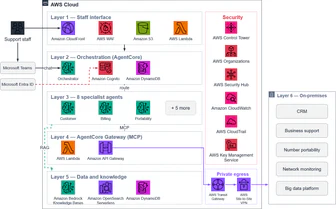
U Mobile 与 AWS 合作,基于 Amazon Bedrock AgentCore 开发了 AiDaH 智能客服中心,通过跨系统实时协调、链式推理和多租户安全框架,处理 150 项运营场景,关键业务工单量下降 84.5%。AiDaH 在 2025 年底启动试点,2026 年 Q3 正式上线,采用 Microsoft Teams 作为交互界面
 Mastra Blog
Mastra 推出 Knowledge 功能,允许智能体使用公司级文档、政策或决策作为页面组织的共享知识库。该功能通过信号与 Mastra 的上下文工程原语直接交互,支持智能体在运行时获取并更新知识。智能体可通过工具在授权范围内搜索、读取和写入 Knowledge,当前处于 alpha 版本且 API 可能变更。
36氪 · AI精选7272TypeSafeAI 9月中旬发布决策模型 Jev,只输出是/否、评分或概率,上线数周用户破百万,财富500强约三分之一企业开始使用,24天内估值从约 2 亿美元升至 75 亿美元。
推荐理由: 从决策模型爆红到物理世界端侧判断,呈现AI能力分工从生成转向可度量决策的产业变化。
IT之家 · AI3535奇瑞全新捷途自由者 7 燃油 SUV 正式上市,售价区间 11.39-13.49 万元,限时焕新价 8.99-11.09 万元。新车搭载 1.5T+7DCT 动力组合,配备 15.6 英寸 2.5K 中控屏幕及 DeepSeek + 讯飞星火智能 AI 大模型。
Hugging Face Daily Papers6565FactEmbed通过将查询理解与嵌入构建解耦,利用分解的潜在向量模拟检索前的视觉修改,显著提升了组合图像检索性能。该方法在CIR基准测试中优于现有技术,通过中间目标想象优化分解表示,并利用全局级嵌入和均值池化潜在向量实现高效推理。
Hugging Face Daily Papers6565EvoTeam 通过执行经验联合演化团队组织、交互规则和智能体技能,同时保持可重用的团队库,在四个基准测试中展示了有效性。它维护一个可重用团队库,通过特定团队交互规则指导协作,并在兼容的团队上下文中积累协作经验,而个体技能可在不同团队间复用。
Hugging Face Daily Papers6565VidUEU-Agent框架通过从原始视频自动构建指令数据,解决多模态模型开发中高质量多模态指令数据的稀缺和高标注成本问题。该框架采用四阶段数据构建流程,结合视觉语言模型和视觉工具进行证据支持的数据合成,并利用下游训练反馈进行自主迭代。
 Ai2 Blog
Ai2 获得谷歌组织千万美元三年资助,与谷歌研究合作开发开源气候模型 NeuralGCM+,旨在提升气候预测速度与可靠性;该模型扩展自谷歌研究开发的 NeuralGCM,结合物理方程与 AI 模拟大气和海洋共同作用,模拟周期扩展至数十年,支持区域降雨和水资源变化预测,计划通过开源代码和文档促进科研社区协作。
Hugging Face Daily Papers4242Route Anything 框架通过动态选择和协调不同 AI 模型与策略,提升通用 AI 系统性能与效率。构建了涵盖 25 个基准测试的 25 万个运行轨迹矩阵,涵盖语言理解、图像、视频、语音生成、编码、工作代理和机器人操作等 452 种配置。
Hugging Face Daily Papers4747ToolSpace 通过挖掘真实 MCP 服务和开放智能体语料库中的执行轨迹,以确定性规则而非 LLM 判断,聚类加权工具组合图形成环境,应用于 AutomationBench 和 tau3-Bench Banking 产生更难的 Pro 版本。
Hugging Face Daily Papers3838YANAMI 引入了一个大规模多模态对话数据集和基准,要求模型跨轮次跟踪和实现演变的对话状态,揭示当前统一多模态模型仍难以完成此任务。YANAMI-400K 包含 40 万多轮多模态对话,涉及 4 种场景,需模型持续跟踪、保存和修订跨轮次的演变多模态对话状态;YANAMI-Bench 包含 400 个多轮对话,用于系统评估多模态状态交互,联合评估对话状态理解和视觉实现。
Hugging Face Daily PapersRoboColosseum 评估了跨不同机器人和环境的通用机器人策略,发现跨机器人平台一致性弱、开放世界可靠性有限,以及零样本与微调性能差异显著。该分布式评估框架在四个机器人平台(SO-101、Franka、双臂YAM、人形G1)上评估了五种视觉语言行动(VLA)策略和三种前沿AI智能体,结果显示前沿智能体与专用VLA策略相当,但所有系统在开放世界任务中表现均不理想。RoboColosseum 评估了大规模真实环境下的物理智能