Hugging Face Blog5858
Hugging Face 发布 ToyBlocks:用于机器人学习与评估的受控世界框架
Hugging Face 发布 ToyBlocks 框架,为机器人学习与评估提供受控的模拟环境。该框架支持自动生成任务与训练演示,并包含衡量机器人行为随时间变化的指标,旨在研究模型如何随更多训练数据改进,以及如何结合高级推理与精确物理控制。
Hugging Face Blog5858Hugging Face 发布 ToyBlocks 框架,为机器人学习与评估提供受控的模拟环境。该框架支持自动生成任务与训练演示,并包含衡量机器人行为随时间变化的指标,旨在研究模型如何随更多训练数据改进,以及如何结合高级推理与精确物理控制。
 TechCrunch · AI6565
Physicl 融资 1000 万美元,用数字世界让机器人更实用。其平台通过高保真 3D 环境模拟,帮助机器人开发者解决训练难题。推出的 Studio 产品包含 1 万个 3D 场景和 10 万个资产,用于生成合成数据训练机器人处理复杂任务。
 Exponential View6565
美国中期选举后,民主党明确将对人工智能进行严格审查,引发市场对 AI 安全、劳动力市场影响、权力集中及数据中心问题的担忧。选民通过 44 项地方法案中的 43 项减缓数据中心建设,但数据中心建设仍将持续,关键在于与社区达成协议。苏格兰兰ark郡与数据中心开发商 DataVita 达成协议,承诺每兆瓦每年支付 10 万美元用于社区发展,为数据中心建设提供新思路。
Hugging Face BlogHugging Face Open ASR 排行榜新增埃及英语和尼日利亚英语的 Liva AI 私有数据集,包含 1.34 小时和 1.55 小时的对话语音,用于提升 ASR 评估的代表性及可信度。排行榜现支持基于 Kachru 三圈模型的更细致口音分类,涵盖 US 与非 US、内圈与外圈/扩展圈等分组。
 Hugging Face Daily Papers6565
MUON-RT 优化器通过复用教师轨迹并移除动量权重,将教师模型信息以在线方式蒸馏至学生模型,节省 25% 内存参数(标准 Muon 需 4x 参数,MUON-RT 仅需 3x),提升模型性能。
Hugging Face Daily Papers6565解耦预测决策架构(DPDM)通过结合冻结的语言模型表示与一个共享的预训练条件预测器,提升了智能体决策的准确性。
 IT之家 · AI
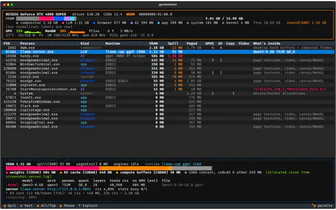
微软 GitHub 副总裁斯科特·汉塞尔曼开源 GPU 监控工具 gputaskman,按进程展示 GPU 使用率、显存占用、温度等数据,并识别 LLM 进程显示模型细节,支持 Windows、Linux、WSL 和 Apple Silicon Mac。
IT之家 · AI淘宝 MNN 团队开源 0.3B 手机模型 MNN-Pocket-0.3B,在 iPhone 18 Pro 真机离线跑出 350 token/s。模型峰值内存低于 300MB,解码吞吐超 200 token/s,INT4 部署文件 173MB,英文 IFEval 得分 73.20,中文指令遵循 IFEval-zh 得分 74.59。
 vLLM Blog
VeRL-Omni v0.3.0 发布,将异步执行扩展到更多多模态强化学习工作负载,并将 V1 训练器设为默认选项,同时扩展了图像、视频、音频和多模态理解的后训练支持。
Hugging Face Daily Papers5252Open-HumanScale 是首个支持具身基础模型 egocentric pretraining 扩展至 50,000 小时的开源方案,其核心数据集 Open-HumanScale-50K 包含 50,000 小时密集标注的人手动作和自然语言 egocentric 视频数据。
IT之家 · AI英伟达提出“全栈协同设计”破解 AI 内存瓶颈,NVFP4 压缩模型权重和 KV 缓存,NVL72 系统分散权重至 72 颗 GPU,Vera CPU 提供缓冲,Dynamo 软件迁移上下文,RAG 索引保留在 CPU 与存储侧。
 The Decoder同一件事 · 3 家
百度发布 ERNIE-5.5-Flash-Base 开源基础模型,含 2800 亿参数,采用混合专家架构,单次输入激活 140 亿参数,预训练覆盖 3350 万亿 tokens,支持高达 128 万 tokens 的训练上下文,推理时上下文最长可达 100 万 tokens。
 Claude · YouTube
Claude 推出个人财务管理功能,连接用户账户并解释支出、账单和余额,访问权限为只读,用户可随时解除连接,目前在美国逐步向 Pro、Max 和 Ultra 计划开放测试。
 Databricks Blog
Databricks 提供三种数据协作工具:OpenSharing 允许用户直接共享数据资产(包括表、视图、笔记本、模型等)给外部组织或内部部门,提供即时只读访问且无需建立管道。
 Mastra Blog
Mastra 平台和 Studio 现支持追踪每个智能体和模型调用的延迟指标,可通过 TTFC(首次数据块时间)和 TTFT(首次 token 时间)过滤排序追踪、跨度及线程,识别慢速环节。
 NVIDIA Newsroom3838
NVIDIA 通过全栈协同设计提升内存效率,在 GPU、CPU、网络、存储和软件各层优化内存使用。Blackwell Ultra 显卡使每 GPU HBM 容量提升约 3%,而 SemiAnalysis AgentX 上的智能体推理成本降低 30 倍。
 Google Research精选同一件事 · 2 家7272
Google Research 在 Nature 发表多模态 AI 系统 AI-PPG-ACC-HTN,无需袖带校准,仅用消费级智能手表的 PPG 与加速度计数据被动识别高血压状态。
推荐理由: 研究用智能手表 PPG 与加速度计数据被动识别高血压,并以 24 小时动态血压监测为金标准给出筛查与确认两阶段的量化结果。
 NVIDIA Technical Blog6565
NVIDIA协同设计通过优化内存使用,减少冗余权重复制、闲置KV缓存和重复计算前缀,提升HBM效率,将更多内存用于生成token。该方案使每个字节能产生更多有用工作,而非单纯关注GPU内存容量。
Databricks BlogNVIDIA 与 Databricks 联合为 Debezium 项目贡献的 Zerobus Ingest 消息接收器,通过直接将记录写入 Unity Catalog Delta 表。
 IBM Research Blog3636
ORNL、IBM 和 AMD 在 IBM 纽约波基普西园区部署量子纠错(QEC)协同设计平台,将 IBM Quantum Nighthawk r2 处理器与 ORNL Umbra HPC 系统整合,后者包含 AMD Instinct MI355X GPU 和 5th Gen AMD EPYC™ CPU,为混合 HPC-量子计算环境中的算法开发与验证提供低延迟量子-经典执行能力。
TechCrunch · AI6565Discovered Materials 公司宣布出资 100 万美元挑战赛,旨在利用 AI 解决材料科学领域的 5 个关键问题,包括解释高温超导现象、预测硅二氧化物界面结构等;公司联合全球顶尖大学教授定义挑战,并已用前沿 AI 模型尝试求解但进展有限,此举旨在推动 AI 在材料科学领域的突破。
Hugging Face Daily PapersPyRUA-DataFarm 通过模拟任务、渲染照片级视频生成可部署的机器人训练数据,以低于远程操作的成本自动化机器人演示生成。在五个真实机器人任务上,仅使用农场数据训练的策略与使用同等数量远程操作演示训练的策略表现相当(100 次试验中成功率 93% vs 84%),在未见过的新场景下也表现更优(成功率 87% vs 46%)。
IT之家 · AI精选同一件事 · 3 家7474百度文心发布 ERNIE-5.5-Flash-Base 并开放 ERNIE 5.5 Flash 预训练终点权重,这是一个总参数 280B、每 token 激活 14B 的稀疏 MoE 语言模型,在 33.5T tokens 上从零预训练,微调与推理支持 1M tokens 上下文。
推荐理由: 原文给出 280B 稀疏 MoE 基座的参数、训练数据量与开源权重,读者可据此判断其作为微调起点的适配空间。
 量子位精选同一件事 · 3 家7272
百度于11月5日正式开源基座模型文心5.5 Flash Base(ERNIE 5.5 Flash Base),采用 MoE 架构,总参数量2800亿,每个 Token 激活140亿参数,预训练使用33.5万亿 Token,预训练上下文最高128K,微调与推理阶段支持最长100万 Token 上下文。
Hugging Face Daily Papers6565FrontierPhysics是一个包含56个专家设计的物理学任务的端到端基准,评估智能体在文献综述、研究规划、实验和论文撰写方面的能力,使用确定性验证器和专家评分标准。在22个模型和26种配置中,没有一种配置能在168次测试中通过超过46次,手动审查显示主要弱点在于推理不够严谨和专家直觉有限,而非物理学知识或执行错误。
Hugging Face Daily Papers6565GameVerse 包含 69.7K 个涵盖 1,655 小时、349.6 百万帧的分钟级游戏片段,远超现有数据集,通过统一的场景一致性分割、质量过滤、相机姿态估计和事件驱动标注,显著提升长时程交互世界模型的推理时长。
IT之家 · AI英伟达发布 CUDA Toolkit 13.5,正式支持下一代 AI 计算平台 Vera Rubin 并面向企业生产环境部署。更新升级了 GPU 资源调度、多 GPU 通信、数学计算库及性能分析工具,优化了 cuBLAS 对 NVFP4、MXFP8 低精度矩阵运算,提升训练和推理吞吐量。
Hugging Face Daily PapersWebHarbor 提供 153 个可执行的、容器化的网站环境,用于稳定评估和强化学习训练 GUI 智能体,支持跨多步和认证后任务实现强泛化。该套件包含 3,518 个任务,覆盖多步和认证后工作流,超越现有工作。Qwen 4B 级 GUI 智能体在 WebHarbor 中通过强化学习训练,在四个基准测试中表现与领先的开源 GUI 智能体具有竞争力,代码和数据公开可用。
 O'Reilly Radar
Common Fabric 的 CEO Alex Komoroske 在与 Tim O’Reilly 的对话中阐述了其共鸣计算宣言的核心理念,该宣言提出五项原则:私有、专注、多元、适应和利他,旨在创造能滋养而非消耗用户的科技体验。
Hugging Face Blog精选6565Dharma-AI 发布 Dharma Field Extractor,一个 2B 参数模型,输入文档图像和可选 schema,输出带类型的结构化 JSON,支持开放抽取与按 schema 定向抽取,未出现的字段返回 null。
推荐理由: 原文给出自建基准上的质量与成本对比,读者可据此判断小模型专精路线在字段抽取任务上的可行性。
 Cohere Blog
Cohere的Embed 5和Rerank 5已在OpenRouter上线,可通过单一API在几十行Python代码中构建工作流。Embed 5 Pro和Fast共享嵌入空间,Pro用于索引质量、Fast用于查询延迟,Rerank 5分数跨查询和领域校准。
IT之家 · AI6565开源项目 npu-driver 通过 NPU 渲染 Win11 桌面,刷新率仅 2-3Hz,目标 30Hz。该项目采用 Apache 2.0 协议,已在搭载英特尔 Panther Lake 处理器的设备上测试,能基本运行桌面及应用窗口,并能在必要时切换回 GPU 渲染。
Hugging Face Daily Papers3434LoCo 通过本地偏好学习来教导推理模型何时停止推理,在数学和代码任务中大幅减少输出长度,同时保持或提高准确性。该方法在数学任务上减少完成长度 41.7%--45.4%,在代码任务上减少 23.4%--36.3%,并保持或提高准确性,同时在所有代码基准中实现最佳 AUC。LoCo 的代码和模型将公开发布。
IT之家 · AI2222英飞凌推出首款采用 RISC-V 架构的全新汽车微控制器平台 AURIX RC1,该平台最多可集成 12 个 32 位处理器内核、1 个面向边缘 AI 的高级并行处理单元及最高 40MB 嵌入式存储,计划于 2027 年上半年提供样品。
Hugging Face Daily Papers6565VidUEU-Agent框架通过从原始视频自动构建指令数据,解决多模态模型开发中高质量多模态指令数据的稀缺和高标注成本问题。该框架采用四阶段数据构建流程,结合视觉语言模型和视觉工具进行证据支持的数据合成,并利用下游训练反馈进行自主迭代。
Hugging Face Daily Papers3838YANAMI 引入了一个大规模多模态对话数据集和基准,要求模型跨轮次跟踪和实现演变的对话状态,揭示当前统一多模态模型仍难以完成此任务。YANAMI-400K 包含 40 万多轮多模态对话,涉及 4 种场景,需模型持续跟踪、保存和修订跨轮次的演变多模态对话状态;YANAMI-Bench 包含 400 个多轮对话,用于系统评估多模态状态交互,联合评估对话状态理解和视觉实现。
Hugging Face Daily Papers6262Axion 1.0 通过三阶段(两轻量级监督微调+强化学习)训练,在完全开源数据和训练流程下实现有竞争力的智能体性能。该模型采用模型感知数据构建和可验证任务生成,无专用中训练、直接偏好优化或策略内蒸馏,在多项智能体基准测试中表现优异,与领先商业模型在部分测试中可比肩,并公开完整开发流程以促进开放智能体研究。
IT之家 · AI6565苹果在 macOS 27.3 首个开发者测试版中为“快速查看”加入原生 Markdown 渲染支持。用户预览 .md 文件时可直接看到带格式的内容,无需切换应用。此举有助于减少操作步骤,满足日常阅读需求。
Hugging Face Daily Papers3838IdeaTaste 评测基准显示,AI 智能体在引用文献和研究方向上与人类研究社区相似,但在具体方法和预期成功上差距显著,引用匹配度达人类水平的 26%,想法匹配度仅 18%。
 OpenHands Blog精选7171
OpenHands与Snowflake AI Research合作,让开发者用现有的OpenHands Agent harness直接进行强化学习后训练,无需在训练框架中重建harness。
推荐理由: 原文给出了用现有 Agent harness 直接做 RL 后训练的具体配置方式和代码定位实验,读者可据此判断训练与部署能否共用一套 harness。