Hugging Face Daily Papers6565
LongBanana:首个专家验证的长上下文多参考图像合成基准
LongBanana是首个专家设计和验证的长上下文多参考图像合成基准,包含90个精心设计的任务,每个任务约含32张参考图像、20个约束和50个评估项,共4,670个专家指定的原子评估项。
Hugging Face Daily Papers6565LongBanana是首个专家设计和验证的长上下文多参考图像合成基准,包含90个精心设计的任务,每个任务约含32张参考图像、20个约束和50个评估项,共4,670个专家指定的原子评估项。
 MiniMax · Hugging Face 新模型
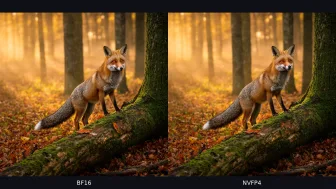
MiniMax-H3-Image-PE 通过提示扩展(PE)将简短请求转换为详细图像描述并推荐宽高比。它支持文本到图像(T2I)和图像编辑两种工作流程,使用微调自 Qwen3.8-27B 的 FP4 权重。在线 API 可通过 platform.minimax.io 或 platform.minimax.cn 访问,文档提供中英文支持。
 量子位4242
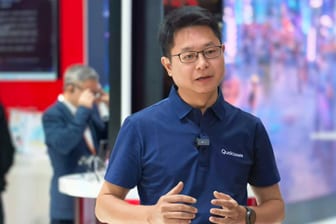
高通在第九届进博会展出端侧MoE智能体,推动终端侧AI从单点应用走向智能体体验。MoE技术通过混合专家模块提升端侧模型智能水平,在20亿至30亿参数规模下实现更高复杂度任务完成度。高通与Infris AI、江波龙、阶跃星辰合作优化模型、推理、存储和芯片平台,展示终端侧AI生态协同的系统性方案。
 MarkTechPost3838
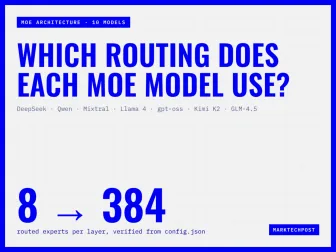
DeepSeek-V4-Pro、Qwen3.6-35B-A3B 等十款开源 MoE 模型在专家计数(8B-384B)、top-k(1-8)、共享专家(7/10 模型保留)、评分函数(Sigmoid/sqrtsoftplus)和负载均衡(Aux loss/bias)等五个方面存在差异。
 IT之家 · AI6565
得物 App 接入国行苹果 Apple 智能,用户通过 iPhone 相机拍摄商品即可 AI 快速查信息。拍摄后可在得物搜索相关商品,查看详情、历史价格、AI 解读及用户评价。
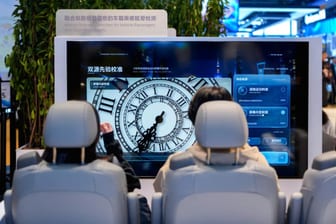
IT之家 · AI6565索尼在进博会上全球首发“融合双路视觉信息的车载乘客眩晕检测”技术,通过分析车前道路画面与后排屏幕内容预测乘客眩晕程度,评估结果可用于提示驾驶员减少急刹急转或为内容平台推荐视觉变化缓和的内容。该方案复用 ADAS 前视摄像头,无需新增后排摄像头。
Hugging Face Daily Papers6565VisSearch-Bench 评估了 16 个多模态模型在 204 项人类编写的视觉搜索任务上的表现,这些任务要求整合视觉上下文与外部信息,结果显示最佳系统仅完全解决了 26.47% 的任务。该基准涵盖集合式视觉搜索、序列式视觉搜索等 7 个主要领域,通过准确率与过程分评估任务完成度与推理步骤的正确性。
IT之家 · AI5858苹果为 iOS/iPadOS/macOS 27.2 系统的部分 Apple Intelligence 图像工具(图乐园、图像魔法棒及“照片”中的清理、扩展、空间重构)引入 SynthID 隐形水印,人眼不可见但可被 SynthID 检测器读取。用户可通过 synthid.com 检查图像是否含水印;该技术支持像素级标注真实图像数据,用于证明照片原真性。
 Baseten Labs6565
研究表明,策略内自我蒸馏(OPSD)在特定场景下可能仍有价值,但不应投入更多研究资源。OPSD 通过学生模型自身生成的带上下文提示的输出进行训练,但研究表明这种密集的监督可能引入偏差,尤其对训练好的模型效果更差。
 NVIDIA Technical Blog6565
FLUX 3 Image Klein 在 NVIDIA Blackwell GPU 上实现 3.5 倍速度提升。模型参数规模为 175B,在 MMLU 评测中得分 95.3,支持 8k 上下文长度,通过 API 提供闭源服务。
 AWS Machine Learning Blog5858
Amazon SageMaker Inference 现支持 GPU 分区,通过 NVIDIA 多实例 GPU (MIG) 将物理 GPU 划分为独立分区,每个分区获得固定份额的 GPU 计算单元和专用内存块,实现隔离。部署更多模型且相互隔离,并按需选择合适大小的 GPU 单元以降低成本,最大支持每 GPU 7 个分区,无需自建 Kubernetes。
 Claude Code releases2222
Claude Code v2.1.319 发布,关闭遥测或功能标志时自动模式被更改,服务器端检查被禁用;在 LLM 网关后启用服务器端检查需设置 CLAUDE_CODE_AUTO_MODE_SERVER=1。
 NVIDIA Newsroom3838
NVIDIA的开源Aerial和Sionna软件使全球开发者采用量增长10倍、下载量超100万次,被8000多个研究机构使用,支持目标语义通信使机器人任务完成时间缩短52.6%、AI接收器在干扰环境下提升60%上行吞吐量、需求预测系统降低45.6% RAN功耗、GPU加速模拟将仿真时间从3小时压缩至10-20分钟。
IT之家 · AI5050摩尔线程基于 MTT S5000 智算卡及 MUSA 软件栈完成 Kimi-K3.1 Pro 模型 Day-0 适配,支持 100 万上下文,在 Terminal-Bench 4.0 得分 65.7%。该模型是迄今能力最强的 3 万亿级参数模型,在代码与 Agent 基准测试中表现达顶尖闭源模型水平。
 Hugging Face Blog5858
Hugging Face 发布 ToyBlocks 框架,为机器人学习与评估提供受控的模拟环境。该框架支持自动生成任务与训练演示,并包含衡量机器人行为随时间变化的指标,旨在研究模型如何随更多训练数据改进,以及如何结合高级推理与精确物理控制。
 Artificial Analysis Articles6565
VIALS-AA 对 19 模型进行测试,发现 38.3% 的工具调用用于查看图像,47.3% 用于图像准备或测量,而 GPT-6 Astra 和 GPT-6.1 Sol 的图像测量调用率仅为 5-6%,Claude Opus 5.5 和 Claude Sonnet 5.5 则为 25-27%。
Hugging Face Daily Papers6565SLA 模型通过持续预训练和后训练,将预训练的 VLA 策略与冻结的 3D 感知模型进行空间对齐,使用特征依赖门控和概率状态 dropout 提升跨不同机器人数据的空间理解能力,同时保留推理架构。
IT之家 · AI5858Pangram Image 1.0 模型通过热力图定位 AI 生成内容,在 1200 张照片测试数据集上准确率达 99.96%。该模型能对抗压缩、缩放和人工修饰影响,256×256 分辨率下准确度仍达 96.4%。同时发布的 Pangram Image Flash 1.0 视频检测模型在 DF26 数据集上准确率 98.7%,领先第二名 29 个百分点。
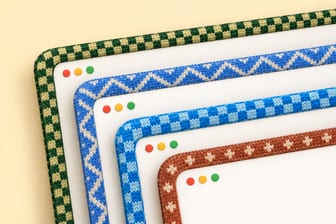
开发者发布 Mac 应用 Window Sweaters,为 37 款应用添加针织边框,颜色灵感源自应用图标,支持自定义样式和模式,可通过 Homebrew 或手动安装,需 macOS 13 或更高版本。
IT之家 · AI3030QQ 鸿蒙版 App 9.2.80 (3592) 正式版更新上线,空间相册新增 AI 修复功能,新增支持简洁模式。
IT之家 · AI3535华为今日面向 Mate 90 系列手机推送了 HarmonyOS 7.0.0.111 SP15 版本升级,优化搭配睿影 Z10 模块相机的拍摄效果,同时提升整机系统稳定性。睿影 Z10 模块相机代号“金刚”,集成红枫传感器,支持软硬芯 AI 协同对焦,拥有独立光学防抖模块。
Hugging Face Daily PapersWeLM-Image 是一个集成多模态理解的统一图像基础模型,支持文本到图像生成、指令引导编辑和多参考合成。
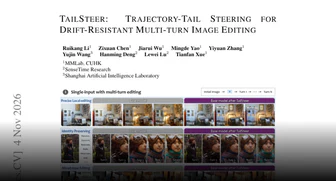
Hugging Face Daily Papers6565TailSteer 通过保持早期去噪动态接近基础模型并从策略内滚动学习轨迹尾部的精细偏差抑制校正,显著减少多轮编辑中的累积视觉漂移,同时保留预训练的生成和编辑能力。实验表明,TailSteer 在 FLUX、SenseNova 和 Qwen 系列模型上,能在 15-20 轮编辑中大幅降低漂移,且在大量文本到图像和单图像编辑基准测试上基本保持基础模型性能。
IT之家 · AI尼康 Z70 相机搭载 4,100 万像素非堆叠式传感器、EXPEED 7 图像处理器,支持 8K 60p 视频录制,具备 120fps 取景刷新率,电子取景器分辨率达 576 万点,可能内置 RED 相关技术支持 Apple ProRes RAW 录制,机身顶部新增 REC 录制按钮。
IT之家 · AIAMD 下一代移动 APU Medusa Point 在联想测试系统中跑出 Geekbench 7 单核 1560 分、多核 11575 分,配备 10 核 20 线程(4 Zen 6 性能核+6 Zen 6c 能效核),16MB 三级缓存,支持 AVX-512 等指令集。
 TechCrunch · AI同一件事 · 2 家6565
Meta 宣布其消费者 AI 代理 Muse 的语音和视频聊天功能 Muse Realtime Avatar 和 Muse Realtime Voice 现已面向美国所有用户开放,用户可通过与可爱的动画头像 Jolly 互动进行实时对话,该头像可根据用户喜好定制,并使用与对话情绪匹配的细微表情和手势。
各家口径不同:The Verge 提及语音模式在 iOS 上可用,并将很快应用于 Meta 的 AI 眼镜和即将推出的 Muse Charm 设备;TechCrunch 没有提及这些细节。
 The Verge · AI同一件事 · 2 家6565
Meta允许用户实时与Muse AI代理进行语音对话,CEO马克·扎克伯格宣布该功能已向部分用户推送。在iOS应用中,Muse代理的头像会根据对话内容实时动画,用户可通过询问代理或浏览头像设置中的选项来调整语音语调。该语音模式在美国地区现已上线,并将很快应用于Meta的AI眼镜和即将推出的Muse Charm设备。
各家口径不同:The Verge 提及语音模式在 iOS 上可用,并将很快应用于 Meta 的 AI 眼镜和即将推出的 Muse Charm 设备;TechCrunch 没有提及这些细节。
 SemiAnalysis
Google TPUv7 Ironwood 在 Qwen 3.5 397B FP8 上单次推理性能每美元优于 B200 和 B300 50%,并在多模型 AgentX 基准中展现竞争力或最佳结果,支持 vLLM、SGLang 等生态,但 NVIDIA 对此反应激烈并加速研发。
 Microsoft Research
PDD Kit 将用户意图转化为形式化规范,并验证智能体为每个输入编写的代码是否符合该规范,同时辅以测试。团队在 GitHub Next 的 Chopin 环境中使用 PDD Kit 正式验证了 Rust 编写的 Pet Store 登录逻辑,Verus 工具发现并修复了现有 Bug,证明规范下无登录 Bug。
Hugging Face Daily Papers6565EmoReward 通过从实际训练运行中收集的奖励轨迹中提取证据可靠性,自适应地指导多奖励权重分配,以校准情感视频生成的奖励权重。该机制首先根据情感提示规划特定的接地线索进行评估,然后使用异构信号原语在生成阶段对视频进行评分,并通过反射奖励门控对它们的贡献进行校准。
IT之家 · AI4242大疆发布 Matrice 5T 无人机,首次在轻型行业无人机上标配激光雷达、毫米波雷达与全彩全向视觉感知系统,售价 57,488 元。配备原生 1K 热成像相机、多焦段可见光相机,支持 IP55 防水等级,最长飞行时间 59 分钟,内置机载算法可辨别超 20 种目标类型,开放算力可导入第三方 AI 模型。
IT之家 · AI6565Rollme 推出 AuraCam 头戴式耳机,配备 800 万像素摄像头和电子防抖,支持 OpenAI 图像识别与实时翻译功能,售价 89.99 美元。耳机具备会议录音、拍照录像功能,通过按钮同步至手机 App,支持蓝牙 5.4 和 Wi-Fi 6,续航最长 50 小时。
Hugging Face Daily Papers6565NEO-VLA框架通过让动作策略直接访问网络深处的视觉表征,消除了固定视觉编码器,在多种操控场景和分布偏移下实现了更强鲁棒性。该框架使用轻量级卷积层对图像进行分词,并让视觉表征与语言在骨干网络中共同演化,使动作专家能从指令条件化的不同深度视觉表征中获取信息。层探查实验显示,动作关键信号常在最终视觉表征形成前就已达到峰值。
MarkTechPost精选同一件事 · 3 家7070OpenAI 在 ChatGPT、Codex 和 API 上线 Images 2.6,API 侧提供 GPT-Image-2.6 Flare 与 Sunburst 两个模型,官方称生成速度比上一版快 50%
MarkTechPost同一件事 · 2 家Google AI Research 发布 Agile Deliberation 框架,通过人类参与循环将模糊概念转化为结构化定义,用于灰色区域图像分类。该框架基于 Gemini 2.5 Pro 和 Gemini 2.5 Flash API,无需微调,平均 F1 分数比零样本 Gemini 2.5 Flash 高 10.5 分,付费场景下 F1 达 0.59。
各家口径不同:谷歌研究提到用户实验减少疲劳和焦虑;MarkTechPost 关注 F1 分数提升。
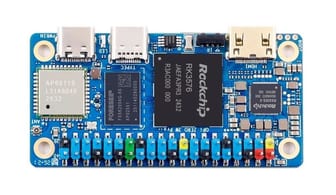
IT之家 · AI6565香橙派发布 OrangePi Zero 3W Pro 小尺寸 SBC,基于瑞芯微 RK3576 处理器,支持 16GB LPDDR 内存和多种存储扩展,集成 Wi-Fi 6E & 蓝牙 5.3,适合本地轻量 AI 推理。
 MIT News · AI
UQ-DAAAM 系统能识别并修正机器人记忆中的错误描述,通过比较多视角图像量化不确定性并优化物体描述,提升机器人对物体、位置和时间的认知准确率,目前修正成功率约 92%,准确率提升 5%。该系统采用 LLM 融合多视角描述,并使用启发式规则选择最佳补充图像,无需重跑 VLM 即可大幅降低计算量。
IT之家 · AI3535FurMark 2 2.11.0.4 版本更新,支持 RTX Spark 等新 GPU 设备测试,优化 Windows GPU 核心热点与内存温度显示及 Linux Wayland 协同。
量子位精选同一件事 · 3 家7878OpenAI 的 GPT-Image-2.6 已在 ChatGPT、Codex 和 API 全线上线,全线免费及付费用户均可使用,整体生成时间缩短 50%,最快 6 秒出图。
 OpenAI News精选同一件事 · 3 家6262
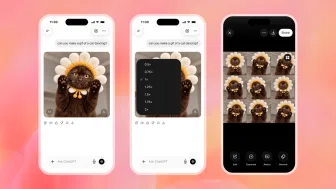
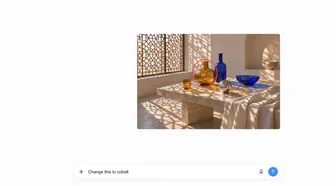
OpenAI 发布 Images 2.6,带来更快的图像生成、GIF 创建、更精确的编辑,以及新的 API 控制。该版本覆盖 ChatGPT、Codex 和 API 三个入口。
推荐理由: 原文列出图像生成提速、GIF 创建、更精确编辑和 API 控制四项变化,可据此判断 ChatGPT、Codex 与 API 的图像能力边界。