inclusionAI/Ling-3.1-flash-1019 发布:560B 参数大语言模型推理能力提升
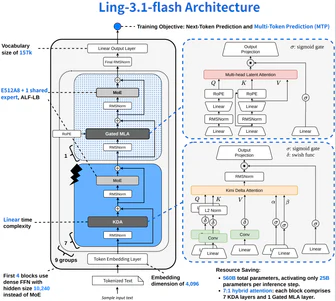
inclusionAI/Ling-3.1-flash-1019 发布,560B 参数量,25B 活跃参数/Token,1M 上下文窗口,推理能力提升,AA-Briefcase 分数 1524 Elo,AutomationBench-AA 68%,Artificial Analysis Intelligence Index v4.3.2 44 分。支持 SGLang 和 vLLM 推理。
北京大学 的 Harness-Zero 项目通过将 Qwen3.5-9B 框架的行为训练到模型中,使其在表格编辑、多应用工具使用和化学任务上平均成功率提升 21 点,超过原框架+模型组合。
Browser Use 和 Browserless 都支持现有脚本和 AI 工作流,但价格、API 和部署选项不同。Browser Use 提供 Chromium 基础设施和托管浏览器代理,价格按小时 $0.02 计算,免费层级提供 $1 信用额度;Browserless 则支持 Firefox/WebKit,提供专用截图/PDF API,价格基于单位,原型层级每月 $25。
OpenAI发布GPT-6.1 Terra,标准API输入1美元/百万Token、缓存输入0.05美元/百万Token、输出5美元/百万Token,价格约为GPT-5.6 Terra的一半。
推荐理由: 原文给出GPT-6.1 Terra的官方基准、API定价与网友实测成本对比,可据此判断低价电脑操作模型的性价比边界。
Ai2 发布 Old Ideas, Novel Problems 研究,评估六款 LLM(GPT-5.1至5.4、Claude Sonnet 4.5至4.6)判断科研创新性的可靠性,发现微调提示词可致准确率差异超 50%。研究构建包含 154 人类原创及 154 AI 生成科研想法的基准数据集,证实模型判断稳定性不足,需更可靠方法评估 AI 提出的新想法。
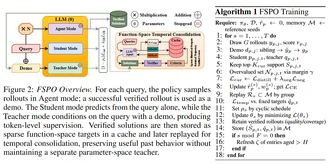
函数空间策略优化(FSPO)框架通过存储稀疏历史下一词分布作为固定时间目标,结合特权适应与函数空间时间整合,显著改进了 SDPO 方法,无需维持持久教师模型即可实现时间分离。
提出统一框架整合基础模型与运行时组件以可靠执行复杂数字任务,引入工作持久性与开放性维度,并识别五类核心能力及优化方法。
FORK 奖励机制通过结合评分驱动的必要性信用和事实评分,同时优化召回率和精确率,提升了响应质量并减少了冗余。与仅基于召回率的传统奖励相比,FORK 显著提高了精确度并缩短了响应长度,同时保持了相似的评分覆盖率,在 RubricHub-Medical 和 HealthBench 上将胜率分别从 10.6% 提升至 68.0% 和从 22.1% 提升至 74.1%。
百度开源 Unlimited OCR 2,一个 3.34B 参数的 OCR 视觉语言模型,可在单次请求中解析数百页书籍、财报和报告,权重以 MIT 协议发布,代码在 GitHub。
推荐理由: 原文给出 SR-SWA 的稀疏注意力机制与百页文档基准对比,可看长文档 OCR 的上下文成本如何被压平。
vLLM Semantic Router 团队发布 d3-ultra,这是一款 26.09B 参数(含 0.46B 视觉编码器)、上下文长度 131,072 token 的 27B 开源多模态决策模型。
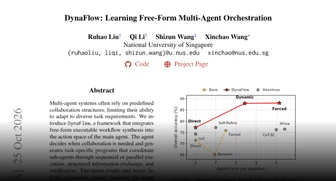
DynaFlow 通过让主智能体合成可执行的流程来协调子智能体,实现自适应多智能体协作。该框架在主智能体的动作空间中集成了自由形式的可执行流程合成,主智能体决定何时需要协作并生成特定任务的程序,通过顺序或并行执行、结构化信息交换和验证来协调子智能体。
SingProbe 是一个基于 Qwen/Qwen3.8-Flash-Next 的流式安全探针,通过复用基础模型的隐藏状态在生成时每一步评分查询意图、响应不安全性和幻觉风险,解码时开销不到 0.5%。
inclusionAI 发布基于 GLM-5.3-Flash 的轻量级流式安全探针 SingProbe,通过复用基础模型的隐藏状态实时评分查询意图、响应不安全性和幻觉风险。
Trajectory2Gym 通过构建具有组合覆盖和决策基础的交互来改进工具使用训练,而非收集成功轨迹。该系统在五个 Qwen3 模型规模上提升了 Tau1、Tau2 和 BFCL 指标,平均提升 16.9-29.8 百分点,尤其增强状态化多轮交互能力。
StreamVibe-Bench 发布包含 4.1K 评估样本和 85K 训练样本的基准,用于测试显式、隐式和动态用户意图交互;StreamVibe-VL 是一个流式主动视频语言模型,通过持续观察推断隐式意图并动态调整交互;StreamVibe-Harness 通过分层内存框架维持用户意图为持久状态,跟踪最新用户意图和环境状态,使主动交互响应一致性提升 12.3%;
inclusionAI/Ling-3.0-flash-Sante-fp8 发布 FP8量化版本,保留124B参数(5.1B/Token)与BF16性能,降低内存并提升部署效率,支持医疗推理、研究及工具辅助工作流,需专业人工审核。在Healthbench、ReDisQA等基准上表现稳定,通过块状FP8量化(128×128块)实现高效推理。
OpenAI 发布 GPT-6.1 Terra,一款面向视觉推理、computer use 和写作的快速模型,已以 gpt-6.1-terra 上线 API,标准定价为每百万输入 token 1 美元、输出 5 美元,是 GPT-6.1 Sol 的一半。
蚂蚁集团发布灵光 2.0,将 AI 助理从被动响应指令、完成单次任务,向主动发现需求、持续管理事务演进。依托独立云主机,灵光 2.0 突破单次对话限制,在用户退出后继续运行任务,并根据新信息动态跟进。目前内置支付宝账单、会员、出行,以及钉钉、飞书、邮箱、米家等服务能力,管理范围延伸至跨平台工作流和智能家居设备控制。
Lakeflow Connect 通过原生连接器支持维基、项目管理工具和 AI 基础模型,使下游 AI 智能体获得完整业务上下文。该平台提供全面管理的原生连接器,支持 SaaS 应用、数据库和文件源,数据直接导入 Databricks 平台,通过点选式 UI 或 API 配置,增量导入 Unity Catalog 表格。
OpenAI 发布新模型 GPT-6.1 Terra,主打以更低成本完成需要视觉推理和操作桌面软件的复杂任务,于 10 月 27 日向 Plus、Pro、Enterprise 和 Edu 用户开放,可在 ChatGPT Work 和 Codex 中使用,API 模型标识为 gpt-6.1-terra。
推荐理由: 原文给出多项基准与每任务成本对比,读者可据此判断低成本模型在桌面自动化上的取舍。
使用 JSON Schema 定义目标数据结构,并在所有网站上应用。对于静态页面,获取干净的页面文本(Markdown),让 LLM 填充该 Schema。仅对需要登录、点击或 JavaScript 流程的页面使用浏览器代理。
LangChain Deep Agents 的 deepagents-code==0.2.2 版本发布,包含安全与性能改进。新增 GPT-6.1 Terra 支持、选中文本输入至聊天、插件更新检测等功能;修复项目 .env 文件设置信任值、终端 UI 链接限制、Git 选项限制等 Bug;通过重用父进程上下文、优化服务器启动流程、精简转录渲染等提升性能,推荐尽快升级。

OpenAI 发布 GPT-6.1 Terra,将成本性能边界推向新高度,API 价格较 GPT-5.6 Terra 减半至百万输入 token 1 美元、输出 token 5 美元。
Databricks Free Edition 允许师生免费在浏览器中运行完整数据或 AI 课程,无需云合同或许可证管理,适用于全球学生和教育工作者。该平台提供协作笔记本、Spark、Delta Lake、Lakeflow、Databricks SQL、Genie 代码助手等功能,支持从入门编程到 AI 项目的各类课程,技能直接应用于行业标准工具,无生产环境与教学沙箱的转换成本。
GHARP 方法通过少量输入图像和表情信号实时动画化 3D 人头,分为离线的身份阶段(构建几何与外观表示)和运行时的动画阶段(预测表情残差)。该方法在预训练重建模型的语义结构潜在空间中执行动画,使表情变化空间受限,实现高效残差预测,并在 Ava-256 基准上达到 SOTA 质量,A100 GPU 速度提升 13 倍、高斯数量减少 8 倍。
OpenAI 发布 GPT-6.1 Terra,这是 GPT-5.6 之后的首个 Terra 级模型,输入/输出定价为每百万 token 1 美元/5 美元,低于 GPT-5.6 Terra 的 2 美元/12 美元。
推荐理由: 原文使用 Intelligence Index 与 Coding Agent Index 的分数和每任务成本,量化了 GPT-6.1 Terra 相对于 GPT-5.6 Terra 的性价比变化。
Cognition 推出 Devin Security 产品,该产品通过 Claude Mythos 和其他前沿网络模型提供深度扫描,企业无需单独访问模型即可使用这些功能。
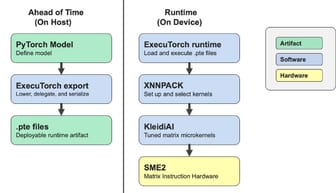
Nemotron 3.5 在 Google Pixel 11 上使用 ExecuTorch 和 SME2 实现了最高的流式语音识别准确率,最高可达 11.7% WER(使用 1,120 ms 音频块和 QC8W 精度),比 FP32 快 3.5 倍,但延迟增加;较短的音频块(如 80 ms)可以降低延迟,但准确率降至 15.2% WER。
Supabase 计划通过 Supabase Compute 在数据库旁运行长时工作负载,并简化模式以方便 AI 智能体理解,同时设计支持更多应用的基础设施。其收购的 Turso 产品支持扩展,且公司正利用 AI 内部提升效率,同时坚持开源与商业销售并行。
Amazon SageMaker SDK v3发布,通过双分支SageMaker Pipeline为每台相机训练异常检测器和缺陷分类器,并设置质量门禁阻止性能不佳的模型。
Anthropic 工程师 Doug 分享在站会与发布评审中使用 Claude Docs 的方法。Claude 在文档中协同工作,自动提取数据、验证论点并响应评论中的问题。该工具专为团队协作设计,支持文档内实时分析。
使用 AWS CDK 在 Amazon Bedrock 管理知识库上构建企业级智能检索,通过 AgentCore 提供的推理代理和 AgenticRetrieveStream API 实现多轮规划和工具驱动检索,返回带引用的答案。该方案部署包含 Amazon S3 语料库、知识库和推理代理的 CDK 应用,支持语义路由和多次检索,并内置 Amazon CloudWatch 监控和评估功能。
Nace AI 发布 Drex for Search,一款用于文档搜索的检索层,其决策模型 Drex 在 BrowseComp-Plus 评测中达 92.05% 准确率,每问题仅用 12.6 次搜索调用。支持通过 CLI、SDK、MCP 或 REST 调用,与 GPT-5、Gemini 3.5 Flash 或 Qwen 27B 等回答模型搭配使用,在 3/4 公开排行榜中排名前二。
NVIDIA Minerva 通过整合 AI 工厂中数十万 GPU、NVIDIA Spectrum-X 网络和 NVLink 等复杂系统,将遥测数据转化为极致 GPU 产能。该系统支持分布式调度器和多周训练运行,实现持续同步的生产流程。
各家口径不同:NVIDIA博客称Minerva帮助团队更早发现问题并保持AI工厂生产力;NVIDIA技术博客则侧重于通过整合复杂系统将遥测混乱转化为极致GPU产能。
Claude Code v2.1.159 发布,Anthropic 26% AI 研发由 Claude 领导并有人监督;Sakana AI 和 Gemini 驱动的 AlphaEvolve 代码智能体分别提升 SWE-bench 和 Polyglot 30pp/15pp,MiniMax M2.7 模型智能体迭代提升 30%。
OpenAI GPT-6.1 Sol 在将 COBOL 代码迁移到现代语言(C++、Java、Kotlin、Python、Rust)时,低推理努力下行为保留准确率达 87%,高推理努力下达 98%。Anthropic 的 Claude Code 也被用于 COBOL 代码迁移,但未提供性能基准。专家认为 AI 工具在处理遗留代码方面取得进展,但距离安全替换关键遗留系统仍很远。OpenAI GPT-6.1 Sol 在迁移 COBOL 代码到现代语言方面取得显著进展。
AI安全创业公司Resolution通过AI系统自动形式化统计学习理论中的数学命题,完成singularities的形式化,预计将加速对损失函数几何与泛化关系的研究。
IBM 和 PyTorch 基金会宣布 Spyre 加速器将成为 PyTorch 的第一类后端并支持多加速器调度。torch-spyre 编译器、Spyre vLLM 插件及持续集成工作使模型和流程能运行在 Spyre 上,该架构针对推理优化,适合 IBM Z、LinuxONE 和 Power 系统。
讯飞开源的Spark-X2.6大模型采用MoE架构,总参数量293B,支持1M上下文,API价格打六折,每百万输入tokens 0.9元。实测显示,Spark-X2.6在代码和智能体能力上提升约8个点,国产算力训练效率提升4倍,高频应用场景Token消耗下降约60%。模型支持纯端侧、纯云侧和云+端三种协同模式,在CPU推理下完成机器人公司周度经营复盘,用时6.8分钟交出完整报告,准确率达九成。
无问芯穹与三体宇宙发布智子Agent 1.0,该AI对话Agent以637号小宇宙管理员为角色锚点,通过AgentWorks平台实现角色一致性、交互连续性,支持跨会话记忆,依托多智能体协同机制保障人设与知识约束,采用PDD跨集群异构推理架构降低首Token延迟51.5%。