量子位5858
无问芯穹在NVIDIA GPU算子性能评测榜单SOL-ExecBench上取得88项第一
无问芯穹在NVIDIA Research推出的GPU算子性能评测榜单SOL-ExecBench上以88项单题第一位居所有参赛团队之首,覆盖L1基础算子、L2融合算子、Quant量化算子与FlashInfer-Bench推理算子四大赛道。其通过容器化隔离架构、模块化Skills与共享记忆机制,结合针对不同计算场景的精细化优化策略,实现了AI自主完成复杂算子优化的能力。
量子位5858无问芯穹在NVIDIA Research推出的GPU算子性能评测榜单SOL-ExecBench上以88项单题第一位居所有参赛团队之首,覆盖L1基础算子、L2融合算子、Quant量化算子与FlashInfer-Bench推理算子四大赛道。其通过容器化隔离架构、模块化Skills与共享记忆机制,结合针对不同计算场景的精细化优化策略,实现了AI自主完成复杂算子优化的能力。
 IT之家 · AI6565
开发者在 DeepSeek Harness GitHub 代码库中发现 deepseek-v5、deepseek-v5-open 和 deepseek-v5-next 三个模型标识符,目前仅作为框架占位符。
 Hugging Face Daily Papers6565
大规模评估显示,专用记忆系统常弱于简单检索增强生成,引入记忆收益与记忆税框架评估净价值。记忆在长时程智能体中日益普遍,但构建记忆相较于直接从原始历史检索的净价值仍不明确。
Hugging Face Daily PapersPDRVLA通过集成轻量级物理动态模块改进机器人行动生成,该模块在物理世界模型监督下预测未来视觉特征,避免在线视频生成带来的延迟。PDRVLA在四个模拟基准上取得99.3%(LIBERO)、89.9%(LIBERO-Plus)、93.6%(RoboTwin~2.0)和81.5%(SimplerEnv)的成功率。
Hugging Face Daily Papers6565Looped Transformers 在相同计算量下通过完整回溯时训练优于截断回溯,扩展规律表明当模型大小可调时两个循环为最佳。Looped Transformers 通过复用共享层块增加计算深度而不增加可训练参数量,通常使用回溯时训练(BPTT),但为节省训练计算量常截断至最后几循环,这可能导致梯度偏差削弱循环优势。
量子位同一件事 · 2 家蚂蚁集团旗下百灵大模型开源 Ling-3.1-flash-1019,在智能指数 AA-Briefcase 中得分 1524 Elo,较上一版本提升 3 分;基础模型 Ling-3.1-flash-base 采用混合线性 MoE 架构。
Hugging Face Daily PapersHarness Self-Evolution通过元技能指导技能适应来改进LLM代理,无需参数更新即可提升弱模型性能。研究发现,技能对强模型有益但对弱模型可能有害,在七种模型和三种基准测试中,有103个任务-技能对使GPT-5.6-luna提升了31.1分,但使Gemma-4-E4B降低了8.8分。
Hugging Face Daily Papers6565Test-Time Memory Evolution (TTME) 方法通过更新外部存储而不改变模型权重,比Test-Time Training (TTT)更高效地指导科学发现。在五个数学任务上,TTME优于TTT,同时将FLOPs计算成本降低82.8-84.6%,运行时间减少47.7-58.4%。
 Browser Use
GPT-6 Astra 在 Odysseys2 长时程网页智能体基准中表现最佳,完成 47 项任务,平均评分为 84.6。该基准包含 100 项真实网页任务,每项任务有 8-12 项通过/失败检查,15 个智能体参与测试,其中 Opus 5.5 高效模式完成 18 项任务,平均评分为 71.2。
Hugging Face Daily Papers6565ThinkWorld模型通过将动作表示为动态链并利用世界想象从无标注人类视频中学习,提升了机器人泛化能力。该VLA框架将每个动作推理表示为动态推理链(CoD),通过强化学习与世界想象结合强化推理,使无标注视频能提供状态转换的直接监督,实现人类与机器人经验的共同推理空间。实验证明其在仿真和真实机器人上有效实现人机迁移并泛化到未见任务和环境。
Hugging Face Daily PapersOvisOCR3是一个0.8B视觉语言模型,通过多导师蒸馏和强化学习统一多种OCR任务,在文档解析、通用OCR、关键信息提取、图文描述和跨页表格重建等任务上达到SOTA结果,在OmniDocBench v1.6上获得96.74分,在OCRBench v2英语和中文拆分中排名第一,并在多个基准测试中超越基线模型。
Hugging Face Daily PapersChronoReplay训练框架通过将异构时空监督组织成按时间排序的交互片段、保留特定任务答案格式、平衡不同监督信号学习,使单一模型能学习互补时空能力并保持时间一致性,在 OVO-S-Bench、OST-Bench 和 UCS-Bench 基准测试中均取得提升,OST-Bench 提高 13.41 分,同时通过自适应帧选择优化流式推理性能。
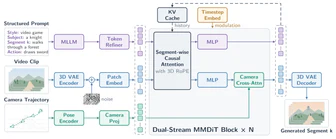
Hugging Face Daily PapersHy-Nomas 是一个 8B 参数的扩散模型,支持自由形式文本指令和跨多轮交互的相机控制,通过因果注意力与结构化视频描述相结合的方式遵循多轮文本和相机指令,在人类评估中优于现有世界模型,已开源模型权重、代码和基准。
IT之家 · AI5050Oracle 正建立多样化的 AI 算力组合,SambaNova SN50 RDU 芯片将加入 OCI 云服务。该组合还包括 NVIDIA、AMD 芯片、Positron Atlas 芯片、Google TPU 和 Cerebras 晶圆级芯片,未来还将支持英特尔 Diamond Rapids 处理器。
Browser UseCloudflare 由于自动化特性(navigator.webdriver 为真,Playwright 默认无头壳用户代理不显示 HeadlessChrome)经常封锁标准无头 Chrome,并且通常来自云服务器 IP、无 Cookie 启动。
 OpenAI News
GPT-6 Astra 成为 Retell 语音代理基准测试的领先者,Codex 则帮助其实现人均年营收 160 万美元的营收规模。
 Ollama releases
Liquid AI 发布 LFM3 小模型家族,包含 1.7B 参数的 lfm3 文本模型(256K token 上下文)、支持图像理解的 lfm3-vl、18 语言语音处理能力的 lfm3-audio 及通用模型 lfm3-omni,用于本地智能体和结构化输出;d1 决策模型升级至 2B 参数,支持文本、图像及音频决策,部分模型支持苹果硬件。
 NVIDIA Technical Blog6565
NVIDIA CUDA 13.4 发布,在 Kubernetes 中通过内存强制机制实现 GPU 共享,允许将单个 GPU 分割为硬件隔离的实例供多个 AI 工作负载使用,提升资源利用率。
 Together AI Blog3838
Together AI 推出 GPU 集群自动修复功能,通过在虚拟机和宿主机两端持续监控节点健康,在检测到故障时推荐最小化修复动作并提供证据,允许用户选择自动执行或手动批准。该功能目前全面可用,支持被动健康检查、修复建议、自动修复策略(含故障和节点级授权)、空闲等待控制、升级阶梯和安全护栏,并通过 API 和控制台进行修复;预览版提供基于节点标签的修复合约支持第三方检测系统。
量子位千里科技推出AI 4D毫米波雷达,内置10 TOPS NPU,支持本地AI感知与卫星架构并行输出,实现从天线设计到点云输出的端到端AI处理。该雷达点云密度增强10倍,探测距离提升40%,鬼影消除率达95%,空间角分辨力提升12倍,提供边缘侧、卫星架构及兼容三种工作模式,以适应不同功能等级和平台需求。
 Databricks Blog4545
Databricks Vital Skills 通过开源 Agent Skills 标准为 Genie Code 增强医疗健康与生命科学领域知识,使其在 BiomniBench 基准测试中得分提升。
 The Decoder
DeepMind 发布 Genie 4,这是公司首个能实时生成声音的即时世界模型,用户可通过键盘移动场景、用文本提示引导事件。Genie 4 基于视频模型 Gemini Omni 构建,由 Gemini 大模型族在后台规划模拟进程,支持背景音效、角色对话及实时交互。目前仅限选定测试者体验,未来将向 Google AI Ultra 订阅者开放,并集成 SynthID 水印标记 AI 生成内容。
NVIDIA Technical BlogNVIDIA RTX Spark 是面向 AI 开发、创作和游戏的新 Windows PC 平台,适用于轻薄笔记本电脑和紧凑型台式机,搭载 NVIDIA Blackwell RTX GPU 和 Grace CPU,提供高达 128 GB 的统一内存,并支持完整的 NVIDIA CUDA 堆栈及 RTX 技术(包括光线追踪和 DLSS 5)。该平台为游戏开发者构建基于 RTX 的应用提供支持。
 TechCrunch · AI
OpenAI 发布了三个数学难题的解决方案,其中包括对指数时间假说(ETH)的意外否定。该假说在计算机科学中扮演重要角色,影响对计算难度的理解。OpenAI 的解决方案基于现有工作,引发科学界对 AI 贡献规范的讨论,Anthropic 随后也发布了自己的 ETH 反驳。
 Google Developers Blog3434
Google 发布对话式商务工作原型 HappyDelivery,基于 LangGraph 和 Gemini 在 GCP 上实现;Ingress 层通过 GKE/Cloud Run 和 Cloud Pub/Sub 处理来自 WhatsApp 的输入
Databricks BlogDatabricks 通过构建包含评审环节的文档提取流程,使用 ai_extract 结合 JSON schema 和全局指令提升准确率,并借助 MLflow Prompt Registry 版本化配置,最终在固定人工标注数据集上验证改进效果,使系统整体性能得到提升。
 Google Research5858
Google Research 提出睡眠框架,让 LLM 通过交替的主动(清醒)和睡眠阶段实现持续学习;睡眠阶段利用 MoE 和 Hope 架构进行参数扩展与知识蒸馏,将短期记忆整合为长期参数,支持高达 10M token 的长上下文知识保留和复杂推理能力提升。
 AWS Machine Learning Blog3434
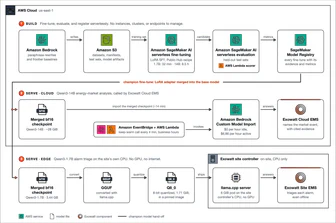
Exowatt 通过 Amazon SageMaker AI serverless 模型定制,为边缘和云部署目标生成了任务特定微调模型 Qwen3-1.7B 和 Qwen3-14B,在准确性上超越前沿模型的同时成本降低了高达 49 倍,并将模型开发周期从数月缩短至数天。
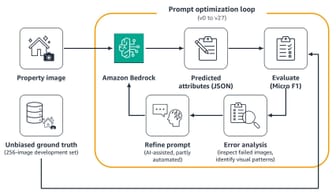
AWS Machine Learning Blog3434Property Finder 在迁移视觉 AI 工作负载至 Amazon Bedrock 时发现其评估数据集 96.8% 的标签来自单一模型的预测而非人工验证,导致新模型客观比较受阻。该公司通过人工专家独立标注 356 张图像构建可信基准数据集,并采用进化式提示优化迭代 27 次后,在保持 86% 准确率的同时将成本降低 86%。
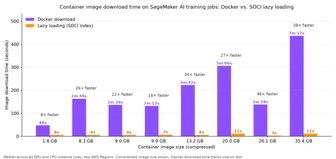
AWS Machine Learning Blog3434AWS SageMaker AI 推出 SOCI-indexed images 功能,将容器镜像下载从关键路径移除,使 SageMaker AI 训练和处理任务启动时间从分钟缩短至秒级。该功能通过预索引 AWS Deep Learning Container (DLC) 或为自有镜像添加索引实现,无需修改工作负载定义,基准测试显示可将 GPU 空闲时间减少 90%,提升效率 8-46 倍。
 NVIDIA Newsroom5858
NVIDIA Vera Rubin NVL72 和 NVIDIA Vera CPU 现已在 Oracle Cloud Infrastructure (OCI) 上正式提供,计划引入 HGX Rubin NVL8 系统以帮助组织加速前沿模型训练、提高推理效率并扩展智能体工作负载。
NVIDIA Technical Blog6565Fine-Tuning NVIDIA Nemotron 可通过本地数据适配通用模型,使其具备特定应用所需的本地知识与文化精确性。该技术使模型在满足本地语言需求的同时,能理解并执行本地规则。NVIDIA Nemotron 通过微调实现这一功能,适用于需要高度本地化能力的场景。
 Hugging Face Blog
Hugging Face 发布 Old Ideas, Novel Problems 研究,评估六款 LLM(GPT-5.1至5.4、Claude Sonnet 4.5至4.6)判断科研创新性的可靠性。
 Replit Blog
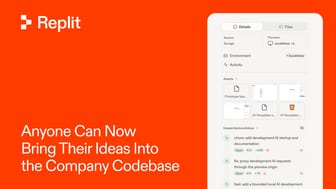
Replit Cloud Agents 允许团队任何成员直接安全地贡献代码到核心代码库,通过在运行应用中测试每个变更、传递审查反馈并共享配置,工程师保持控制权,同时降低其他人的贡献门槛。
Ollama releasesLiquid AI 发布 LFM3 小模型家族,包含 1.7B 参数文本模型 lfm3 及支持图像、音频功能的变体,上下文窗口达 256K tokens;d1 决策模型升级至 2B 参数,支持文本、图像及音频推理,Apple 硬件已支持 rc1 版本。
NVIDIA Technical Blog同一件事 · 2 家6565Inclusion AI 在 NVIDIA DGX Spark 上对 Ling-3.0-flash 进行批大小 1 评估时发现解码是内存限制因素,其中 MoE 计算和输出层投影导致执行时间增加。MoE 计算和输出层投影是瓶颈。
各家口径不同:NVIDIA技术博客指出解码是内存瓶颈,由于MoE计算和输出层投影,而MarkTechPost强调了由于新的MoE后端、FP8输出层和推测解码导致的42.5%吞吐量提升和3.5倍速度提升。
 NVIDIA Blog
C-BRAIN 与 NVIDIA 正利用 AI 改变痴呆症研究进程。他们通过整合此前未公开的阿尔茨海默症研究数据,包括未发表结果和受管制的专有数据,加速新疗法研发。C-BRAIN 运用混合集中式和联邦式架构保护数据隐私,部署 64 块 NVIDIA 数据中心 GPU 及云端节点,并计划引入 NVIDIA Blackwell 系统以支持其扩展目标。
The DecoderThore Graepel团队提出借鉴AlphaGo策略构建AI系统,通过知识账本记录已知信息并验证每一步结论,以减少幻觉。该方法要求推理步骤需经独立验证才改变知识状态,类似AlphaGo结合预测网络与系统搜索。因推理可分解为小步骤,该方案可能更适合小模型在边缘设备和机器人上部署。
 MarkTechPost6565
Mirendil 发布了其首款 AI 模型 Fern 0.1,支持高达 10M-Token 的上下文窗口,约等于 23 MB 代码或 50 万行,首次实现 Megatron-LM 级别代码库的完整加载。
 IBM Research Blog
IBM 与 Kaggle 合作推出 Java 框架迁移基准 ScarfBench,评估 AI 代理迁移企业 Java 应用的能力。在 204 个迁移任务中,Gemini 4 Argon 配合 Antigravity 排名第一(烟雾测试 75.2%),Claude Opus 5.5 配合 Claude Code 排名第二(全部通过率 72.1%)。