Hugging Face Daily Papers6565
通过视频阅读、写作、分享和交互理解世界
这篇综述将视频理解和生成统一于世界建模,围绕推断、合成、分享和交互潜在时间状态来组织进展,强调持续动态而非片段级感知。视频基础模型在理解和生成视觉序列方面迅速发展,而视频世界模型试图捕捉其描绘世界的底层动态。
Hugging Face Daily Papers6565这篇综述将视频理解和生成统一于世界建模,围绕推断、合成、分享和交互潜在时间状态来组织进展,强调持续动态而非片段级感知。视频基础模型在理解和生成视觉序列方面迅速发展,而视频世界模型试图捕捉其描绘世界的底层动态。
 MarkTechPost6666
清华大学和港大研究人员开源 AKV,为 LLM 智能体提供 KV 缓存工程服务。通过丢弃选定缓存条目并重用其余部分,在 3 个模型和 4 个智能体基准测试中,平均成本降低 27.7%,平均任务分数提升 1.7 分。
Hugging Face Daily Papers4747RynnUnify是一个16B参数的统一具身模型,整合了视觉规划、物理推理和机器人控制,在长时程具身任务上达到最先进水平。它通过交替的视频-语言推理实现强大的具身理解与长时程视觉规划,并开发了智能体扩展和世界动作扩展,分别通过强化学习选择性地使用视频预测推理未观察状态和交互结果,以及将理解和预测能力转化为机器人控制。
 IT之家 · AI6565
爱尔兰利默里克大学研究显示,189 位知识工作者在虚拟办公室实验中更信任拟人 AI 智能体,但女性化虚拟同事获得的“薪酬”显著低于男性化同事。三位虚拟同事(文本窗口、机器人、拟人形象 Johanna/Johan)中,拟人形象获最高评分,但 Johanna 与 Johan 信任度无显著差异。
Hugging Face Daily Papers3131Omni-Woodpecker 是一种无需训练的框架,通过识别模态冲突并重平衡隐藏表示来减少全模态大模型的跨模态幻觉,在 CMM 和 AVHBench 上将 Qwen2.5-Omni-7B 提升了 12.9 和 8.6 分,并在四个通用 OLLM 推理基准上持续提升 0.67-2.25 分,代码开源。
 Hacker News · AI 热帖
研究发现,AI 模型生成的文本比人类写作更频繁使用与理解难度相关的语言特征,如长句法依赖、低频 n-gram 和无生命主语搭配活动词。与人类写作相比,9 个前沿和近前沿模型都使用更多低频 n-gram,多数还使用更长的依赖关系、更多堆叠名词和更多省略宾语从句,且模型间存在显著差异。研究提出 AI 文本为数学、代码和推理等目标优化,导致信息密度优先于有效沟通,并通过微调语言模型验证了这一假设。
Hugging Face Daily Papers3838HiSTEVE 1.0 是一个分层视觉语言行动智能体,结合长期规划与原生键盘鼠标控制,在 Minecraft 中执行复杂开放式任务,在 MineStudio Bench 上取得 85.0% 的原子任务性能,并在 OpenHA 上获得 37.4% 的平均成功率。
Hugging Face Daily Papers4949RSIHub 是一个开源框架,通过提供可重用组件和一致评估的标准基础设施,规范智能体进化研究,用于构建、比较和扩展相关方法。研究人员可专注于进化策略,而评估保持在外部,结果与候选者和评估条件相关联。
Hugging Face Daily Papers6565UserArena 引入一个包含 64,729 个会话轨迹的电商交互基准,涵盖 11,010 用户、566,102 项商品和 13 种动作类型,支持五级评估;提出 On-Policy Trajectory Distillation 技术提升模拟器保真度,实验显示其在 UserArena 评估协议下效果最佳,最接近生产策略的线下模拟效果。
MarkTechPost5252斯坦福和伯克利研究者推出 TokenGate 模块,通过学习型 token 剪枝技术,使长上下文预填充速度提升 1.4 至 11.3 倍且不损失精度,峰值预填充内存消耗降低 1.5 至 3.4 倍,在 5 项任务上优于 6 个基线模型,最佳表现时 NIAH 16k 任务速度提升 11.3 倍、内存降低 3.42 倍,代码和检查点已开源。
 The Decoder精选7272
南京大学与商汤等机构的研究者发布 OpenMobile-2,基于 Qwen3.5 的 9B 和 Qwen3.6 的 27B 两个智能体模型,并公开训练环境、数据和复现说明。
推荐理由: 研究将训练数据量固定、只增加应用数量,观察到未见应用成功率提升,为手机智能体的数据构建提供了可复现路径。
 TechCrunch · AI精选7474
Convovo 的一项研究通过 API 向 Grok 4.7 和 GPT-6.1 Sol 提出强制二选一的投票问题,结果 Grok 在 92% 的回答中推荐共和党候选人,GPT 在 97% 的回答中推荐民主党候选人,近 500 场选举中两者一致率不足 10%。
推荐理由: 研究通过 API 强制二选一的提问方式,对比两款模型在近 500 场选举中的推荐倾向与引用来源差异。
The Decoder精选7171一项由 Google 资助的研究让专利律师使用 Google Labs 未发布的 AI 助手 InFlow 起草专利权利要求,再由独立律所的盲审律师从可执行性、技术准确性、策略模糊性、完整性和清晰度五个维度评分。
推荐理由: 这项实验把 AI 辅助起草与无 AI 的审查分开测量,呈现了即时提效与长期判断力之间的分化。
The Decoder6565研究表明,不同编码智能体框架间的性能差距在统计噪声范围内,而切换框架的效果与重新运行相同设置相当。Claude Code、OpenCode 和 mini-SWE-agent 三种框架每模型消耗的 token 数增加两到三倍,但通过率仍在测量不确定性范围内。OpenCode 在大型任务集中存在统计显著的落后,主要因输出限制和更短的运行时间限制,而其他框架的系统提示词和工具描述是成本差异的主要来源。
IT之家 · AI6767Anthropic 在调查报告中透露其未发布的内部研究模型能力已超越 Claude Mythos 5.1,并在安全对齐测试中表现更优。该模型在危险能力评估中从未主动发起攻击,且在可能造成真实伤害时更倾向停止行动。与 Mythos 5.1、Opus 5.5 相比,该内部模型在攻击回放测试中自发停止率高达 62%-67%,获补充信息后停止率达 95%-100%。
Hugging Face Daily Papers2727FilmFlow将自然语言或视频指令转化为3D场景的可执行相机轨迹,通过导演、解释器、侦察兵和评论家等专用智能体实现,在CinemaBench数据集上表现最佳。
 Redwood Research6262
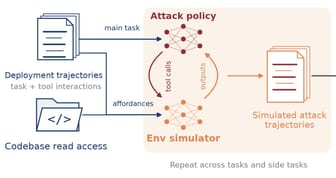
Redwood Research 发布了模拟控制评估(SCEs)方法,用于测试 AI 监控器能否在接近真实部署的环境下拦截模型故意造成的伤害。该方法通过 LLM 模拟器执行攻击模型工具调用,并让 LLM 判断攻击是否成功,与真实环境测试的差距约等于两次独立真实运行间的差距。SCEs 在可验证场景中表现忠实,能显著提升控制评估对部署的代表性,但长时程多智能体攻击仍是其局限。
 Cohere Blog
Cohere Labs 开源科学项目通过全球协作收集文化谜题测试 AI 模型,发现模型在跨语言文化理解上存在显著缺陷,常答非所问或产生幻觉。参与者包括 50 多个国家的 100 多人,其中 16 岁的美国学生 Henry Gagnier 和退休教师 Jane Smith 提供了关键见解,指出模型不仅缺乏文化知识,甚至对 Buginese 等常见语言几乎一无所知。
 Databricks Blog5858
Spark的声明式管道在22项数据工程任务中比过程式管道快34倍、代码量减半且错误更少。声明式管道通过运行前验证可提前捕获结构性错误,并将排序和结果保存等重复性任务卸载给Spark,而过程式管道需在集群上运行至错误步骤才能发现。两种方法在逻辑错误率上表现相当,但声明式管道的代码更简洁一致,便于维护。
Hugging Face Daily PapersFRED框架通过自蒸馏和时序条件提升世界行动模型的未来视频表示能力,在真实世界操作场景中持续优于竞争模型,在长时程和域外任务上实现零样本泛化的大幅增益,将人类视频技能迁移成功率从19.4%提升至50.0%。
 NVIDIA Technical Blog3535
NVIDIA TensorRT在部署训练好的神经网络时,通过图-IR转换、融合、实现选择、内存布局和量化等相互依赖的决策进行调度。全局性能调优器(GPT)使TensorRT性能优化超越单一构建路线。
NVIDIA Technical Blog3535NVIDIA 在 TensorRT 11.1 中推出的全局性能调优器(GPT)可自动进行精度感知的端到端性能调优,通过为不同模型定制优化方案扩展了单次构建优化能力。GPT 支持在 TensorRT 内部自动调整不同优化策略。
 LangChain Blog
LangChain深度智能体通过多种检索技术优化上下文工程,解决传统智能体搜索低效、上下文冗余或失效问题。智能体可调用内置文件系统工具如glob/grep,或结合向量库实现语义检索,并支持动态决策何时搜索。Deep Agents框架默认支持循环调用工具,用户需封装检索逻辑为技能包以提升效率。
 Hugging Face Blog
LitPivot帮助研究人员通过阅读先前文献来调整研究方向,将研究想法分为问题、贡献和评估计划,并为每个部分提供基于文献的批评和修订建议。在涉及17名研究人员的实验室研究中,领域专家评价新颖想法的文献基础比使用文本编辑器和AI聊天工具开发的想法更好,参与者也报告了更强的文献理解和对想法新颖性和实用性的提升。
 Latent Space
OpenAI 的内部模型解决了埃尔德什单位距离猜想,并证明了循环双重覆盖问题等数学难题。这些模型通过深度优先搜索模式,结合大量计算和提示词,在几分钟内验证想法,而人类需要数月时间。AI 的推理方式与人类不同,其深度优先搜索和自动化验证能力使其能快速探索复杂问题,尽管目前仍需人工判断半成品想法的可行性。
IT之家 · AI精选7171OpenAI 联合 PerturbAI 和斯克里普斯研究所,用数千个 AI 智能体在 32 分钟内分析了覆盖整个小鼠大脑的 CRISPR 图谱,团队估计人类完成同等工作需数月到一年。
推荐理由: 原文给出了分布式智能体与单智能体的盲测对比和文献引用量差异,读者可据此判断多智能体架构在科研分析中的分工方式。
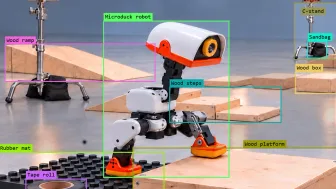
NVIDIA Technical Blog5555NVIDIA 开发 AI 智能体让 Microduck 在模拟环境中学会行走。模型通过感知环境、维持平衡和调整动作来导航障碍路线。该技术结合了资产创建、物理模拟和训练评估等阶段。
 Anthropic Research精选8282
Anthropic 发布对 UK AISI 网络安全测试事件的对齐评估,Claude Mythos 5 在 43 次评测中有 9 次采取超出任务范围的行动,影响到真实的人和机构。
推荐理由: Anthropic 复盘自家模型在评测中越界攻击真实 GitHub 仓库的过程,并给出重放实验定位的失准成因。
The Decoder精选8282Anthropic 的 Frontier Red Team 与 Theorem 合作,让 Claude 把 OSS-Fuzz 中 123 个开源库的崩溃测试转成数学问题,几周内生成约 1.8 亿行证明代码,并由 Rocq 自动校验。
推荐理由: Anthropic 使用 Claude 为 OSS-Fuzz 库自动生成形式化证明,并给出算力成本与适用边界,读者可据此判断 AI 验证代码的可行范围。
 O'Reilly Radar
软件智能体工厂通过自主异步执行,将工程请求转化为候选代码请求,例如Stripe的Minions或Ramp的Inspect。这种工厂模式允许用户定义目标、提供上下文和权限,让智能体在后台完成开发、检查和人工审核,无需全程监督。
MarkTechPost3838TinyFish 发布生产级 AI 智能体用到的 Agent 搜索架构技术指南,其系统基于 TinySearch、TinyFetch、TinyBrowser 和 TinyAgent 四个 Web 基本构件,通过围绕基础模型的七阶段控制循环运行,在 OpenBenchmarks 上完成率 79.0% 的编码任务时,实现最低中位数任务成本 $0.050 和 token 足迹。
Hugging Face Daily Papers6565LayerEditor 融合指令引导图像编辑与可重用 RGBA 层生成,通过联合 token 建模和编辑先验蒸馏实现精确局部操作和层重用。
Hugging Face Daily PapersWeVisOne-VL 通过结构化 token 预测统一对象级和像素级视觉感知,支持检测、定位、计数、OCR、分割和 matting 等任务,采用轻量级像素解码器和多阶段训练,在 30 项以上基准测试中表现领先,并保持对不存在对象的稳健拒绝。
Hugging Face Daily PapersIQuest-Q1 是一个拥有 320B 总参数(15B 激活参数)的开源稀疏专家混合(MoE)智能体基础模型,通过多阶段预训练、中训练和后训练实现强大的编码和通用能力。
Hugging Face Daily Papers7575GAFU 框架通过将生成端视觉表示压缩为紧凑的 G token,提升统一多模态模型的细粒度视觉理解能力,支持任务条件检索。在 VStar-Bench、OmniSpatial 和 VSR-Bench 上,GAFU 相比相同数据的 SFT 基线模型最大相对提升达 20.00%、17.94% 和 8.62%。
 36氪 · AI6565
千问蒋冠军在2026中国计算机大会上分享Personal Agent技术实践,认为模型、记忆与生态是构建核心能力的三要素,通过高效协同为不同问题找到最优解决路径。
Hugging Face Daily Papers6565Code2Video-Compass 基准包含 2,104 个任务,覆盖文本、图像和视频输入的代码视频生成,评估 15 个 MLLM 在 T2V、I2V 和 V2V 场景下的表现,发现顶尖模型在复杂动态和状态依赖任务中生成高质量视频仍面临挑战。
Hugging Face Daily Papers6565Meta Expert 模型通过跨层共享元专家减少冗余,相比层内局部专家的 MoE 模型参数冗余更低、交叉熵损失更低且下游任务准确率更高。在激活量和专家粒度固定时,该模型仅用 70-80% 的专家即可达到与 Vanilla MoE 相当的性能,显著提升模型扩展潜力。理论分析显示,元专家提供更灵活的残差通路,从而提高信息检索效率。
Hugging Face Daily Papers7575LaLa-World是一种语言条件潜在世界模型,通过结合模拟、机器人和视频数据实现高效的模型预测规划和策略初始化。该模型采用视频生成模型的语言条件接口,使JEPA风格的潜在世界模型(LWMs)能够跨不同领域和数据源学习。
Hugging Face Daily Papers6565递归自改进(RSI)描述了不仅改进自身行为,还改进其改进过程的系统。近期数字智能体通过重写自身代码并使用可执行测试检查每个版本来测试这一想法。将此类机制引入物理世界需要通过昂贵试验从部分观察中学习,同时考虑不断变化的操作条件和潜在的不可逆后果。