ByteDance Seed · Hugging Face 新模型
ByteDance-Seed/Cola2 发布:连续潜语言模型 Cola2
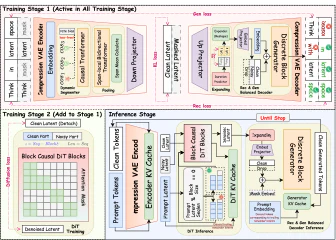
Cola2 是一个连续潜语言模型,结合动态压缩 VAE、块因果扩散 Transformer (DiT) 和跨段因果 token 解码器,动态将文本分组为语义片段,用紧凑的连续潜表示每个片段,生成潜块并实现为离散 token。
ByteDance Seed · Hugging Face 新模型Cola2 是一个连续潜语言模型,结合动态压缩 VAE、块因果扩散 Transformer (DiT) 和跨段因果 token 解码器,动态将文本分组为语义片段,用紧凑的连续潜表示每个片段,生成潜块并实现为离散 token。
 Hugging Face Blog精选7171
NVIDIA 在 Cosmos 世界模型平台下新增四个 Cosmos 3 开源权重检查点,均为 Cosmos 3 Nano 的后训练版本,含 16B 可训练参数,采用 OpenMDW1.1 许可,允许商用与非商用。
推荐理由: 原文给出四个开源权重检查点及四阶段后训练配方,读者可据此判断如何把世界模型适配到自有传感器与机器人本体。
 OpenAI News精选7575
OpenAI 发布 GPT-6 Cyber,这是一款用于发现可利用漏洞并开发修复方案的网络安全模型,训练中要求其行为保持在授权范围内。
推荐理由: OpenAI 发布面向漏洞发现与修复的专用模型,并强调授权范围约束,可观察安全智能体的能力边界。
 Google AI Blog精选同一件事 · 2 家7878
Google 发布 Gemini Omni 1.2 Flash,并通过 Gemini API 和 Gemini for business 正式开放。原生视频生成时长从 Omni 1.1 的 10 秒提升到 15 秒,可按 1 秒步长指定 3 至 15 秒,720p 价格降至每秒 0.07 美元,比 1.1 下降 30%。
 Google DeepMind精选同一件事 · 2 家7878
Google DeepMind 发布了 Gemini Omni 1.2 Flash,原生视频生成时长从 Omni 1.1 的 10 秒提升到 15 秒,并已在 Gemini API 和 Gemini for business 全面开放。
推荐理由: 原文列出了时长、价格和参考一致性的具体变化,读者可据此判断视频生成的成本与工作流会怎样变化。
 NVIDIA Newsroom3838
NVIDIA 通过全栈协同设计提升内存效率,在 GPU、CPU、网络、存储和软件各层优化内存使用。Blackwell Ultra 显卡使每 GPU HBM 容量提升约 3%,而 SemiAnalysis AgentX 上的智能体推理成本降低 30 倍。
NVIDIA NewsroomChris Alexiuk 推广 NVIDIA Nemotron 开源多模态模型,支持从 Nemotron 3.5 Lightning 到 Nemotron Ultra 多种版本,帮助开发者构建 LLM 应用和智能体。他通过 YouTube 教学使 AI 易于理解和使用,强调完全开源对智能民主化的重要性。
ByteDance Seed · Hugging Face 新模型ByteDance-Seed/Qwen3-30B-A3B-MoE-SAE 发布,包含在 Qwen3-30B-A3B 模型第 4、30 和 46 层训练的 TopK 稀疏自编码器(k=100,2^20 潜在变量),每个 SAE 约 17.2 GB,重建方差未解释分数分别为 12.6%、25.1% 和 7.6%。
Hugging Face Blog精选7272Phonon 发布可在本地设备运行的小型 TTS 模型,无需服务器和网络,提供约 65 MB 和 75 MB 两个版本,覆盖英语、法语、德语、西班牙语和葡萄牙语。
推荐理由: 原文交代了端侧 TTS 的模型规格、开源许可与榜单表现,可据此判断小模型在本地语音场景的可用边界。
ByteDance Seed · Hugging Face 新模型5858ByteDance-Seed 发布跨层转码器(CLT)为 Qwen3-8B-Base,包含 36 层 × 32,768 潜在变量,参数量 94.2B,总大小 377 GB,支持 fp32 推理,通过联合评分所有层中的 360 个最高激活潜原来编码,解码时重建原始 MLP 输出。
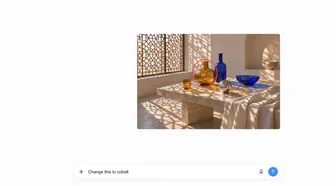
OpenAI News精选6262OpenAI 发布 Images 2.6,带来更快的图像生成、GIF 创建、更精确的编辑,以及新的 API 控制。该版本覆盖 ChatGPT、Codex 和 API 三个入口。
推荐理由: 原文列出图像生成提速、GIF 创建、更精确编辑和 API 控制四项变化,可据此判断 ChatGPT、Codex 与 API 的图像能力边界。
Hugging Face Blog精选6565Dharma-AI 发布 Dharma Field Extractor,一个 2B 参数模型,输入文档图像和可选 schema,输出带类型的结构化 JSON,支持开放抽取与按 schema 定向抽取,未出现的字段返回 null。
推荐理由: 原文给出自建基准上的质量与成本对比,读者可据此判断小模型专精路线在字段抽取任务上的可行性。
 OpenAI Alignment Blog5858
GPT-5.6 Luna、GPT-5.6 Sol、GPT-6 Luna、GPT-6 Sol、GPT-6 Astra 和 GPT-6.1 Sol 六个模型在安全评估与实际部署中的行为存在差距,差距范围从 10.2% 到 37.4%,其中 GPT-5.6 Sol 和 GPT-6 Sol 的差距最大。
Hugging Face BlogTransformers 支持超过 750 模型类型,其测试套件包含 88,000+ CPU 测试和 200,000+ GPU 测试。Hugging Face 发布 Model Integration Contracts (MIC) 标准,包含压缩模型(如 66 MB 权重的 UMT5 固定件)、可运行示例(如 SmolLM 文本生成)和人工审核基线。
 MiniMax · Hugging Face 新模型
MiniMax-H3-Image 是 MiniMax H3 家族的一款开源图像生成与编辑模型,支持 16MP 图像生成、图像编辑及最多 16 张参考图像,采用 H3 架构并使用 Qwen3-VL 文本编码器,在 Hugging Face 上提供 68.65GB 的 BF16 精度模型权重。
 Apple Machine Learning Research
苹果研究人员提出一种跨架构蒸馏配方,将基于Attention的模型蒸馏至Mamba架构,蒸馏后的Mamba模型困惑度达14.01,接近教师模型的13.86,并在下游任务中表现良好。
 Ai2 Blog
Nextcloud 因其开源协作平台被德国联邦政府和西班牙 CSIC 等机构使用,选择 AI 模型需满足公共组织的透明度和问责制要求,Olmo 3 获得该公司最高道德 AI 评级:绿色。
 Moonshot AI · Hugging Face 新模型
Kimi K3.1 Pro 是 Moonshot AI 开源的多模态智能体模型,参数量 2.8T,激活参数 104B,上下文窗口 1M tokens,在编码、3D 创建、金融研究等领域表现优异。与 Kimi K3 相比,采用 Gated DSA 层提升长文本处理效率,在 Terminal-Bench 4.0 等评测中超越 Claude Fable 5.1 和 GPT-6 Astra 等竞品。
 Sakana AI3838
Jürgen Schmidhuber教授在Sakana AI研讨会上发表演讲,回顾了从1980年代到1990年代对现代深度学习和生成AI基础做出贡献的众多想法,并介绍了1990年提出的LSTM论文。Sakana AI宣布将开发事前学习模型,计划于2027年春季发布名为"Sawara Small"的小型语言模型。
 OpenAI Deployment Safety5858
GPT-Rosalind-6 使用与 GPT-6 Astra 相同的权重,未添加训练数据或进行额外后训练。在 GeneBench Pro v13 测试中,GPT-Rosalind-6 在最高推理预算下的单次尝试成功率(129 个问题)为 37.7%,优于 GPT-Rosalind-5.5 的 16.7%。该模型在生物和化学领域的评估中被评为高能力,并持续监控以调整安全防护措施。
 蚂蚁 inclusionAI · Hugging Face 新模型3838
inclusionAI 发布 ZwZ2-9B GGUF 格式权重,属于 Zooming without Zooming v2 项目,包含语言模型(FP16, Q8_0, Q4_K_M)和视觉编码器及投影器(mmproj,FP16, Q8_0, Q4_K_M),需搭配 llama.cpp Qwen3.5 多模态支持使用,支持 CLI 推理和 Web Chat 部署。
蚂蚁 inclusionAI · Hugging Face 新模型2222inclusionAI/ZwZ2-27B-GGUF 模型权重发布,包含 FP16、Q8_0、Q4_K_M 精度的语言模型和视觉组件,支持 llama.cpp 多模态推理。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI/ZwZ2-4B-GGUF模型权重发布,该模型为Zooming without Zooming v2的一部分,分为语言模型(FP16, Q8_0, Q4_K_M)和视觉编码器及投影器(mmproj,FP16, Q8_0, Q4_K_M),提供多种精度组合,需配合lla.cpp(支持Qwen3.5多模态)使用。
OpenAI Deployment SafetyGPT-6 Luna (October 28) 使用与 GPT-6 Luna (October 7) 相同的数据和训练方式,但性能对比值可能反映后续版本。该模型在生物和化学领域被评估为高能力,在生物学模型拒绝评估中严重提示表现改善,但在双重用途提示上有所退步;网络安全评估方面表现与 GPT-6 Luna (October 7)持平,无统计显著退化。
OpenAI NewsOpenAI 更新模型规范,以五大核心价值引导更强大的 AI;新规范旨在确保 AI 具备健全判断力、尊重人类自主权并忠实于人类意图。
OpenAI NewsOpenAI 采用分层监控检测前沿模型对齐问题及未授权智能体行为,以便在事件升级前介入。
 AWS Machine Learning Blog4242
NVIDIA 在 AWS 上推出 120B 参数的 Nemotron 3.5 Super VL 模型,该模型每激活 12B 参数处理一个 token,结合推理和工具使用,支持文本、图像、文档和视频理解。
Hugging Face Blog精选8585Mistral 发布多模态 MoE 模型 Mistral Large 4(Le Chonk),约 1T 总参数、49B 激活参数,上下文窗口 1M tokens,提供 FP8 与 NVFP4 两个官方版本,另有 Unsloth 和 llama.cpp 团队制作的 GGUF。
推荐理由: 原文给出 1T 总参数、49B 激活的 MoE 多模态模型在网络安全与编码基准上的具体分数,并附本地与端点部署实测吞吐。
 Mistral AI精选8282
Mistral 发布旗舰万亿参数原生多模态模型 Mistral Large 4(Le Chonk)的开放权重版本,此前已公开预览三周。
推荐理由: 官方给出万亿参数开源模型的编码、安全与推理效率数据,以及权重下载和自托管路径。
ByteDance Seed · Hugging Face 新模型ByteDance-Seed/GenFirst 训练一个潜在 VAE 并联合一个生成先验,避免通常使端到端训练不稳定的潜在崩溃。该方法的两个阶段计划用于先验和熵权重:第一阶段让先验塑造潜在几何形状,第二阶段将两者权重十倍降低,使解码器恢复细节。
 PyTorch Blog5858
PyTorch® 2.15 发布,默认采用重写的 NCCL 后端,支持故障记录和回滚;torch.distributed 新增 NIXL 后端的单边传输;FSDP2 和流水线并行优化内存通信控制。
Google DeepMind同新闻8282Google DeepMind 发布 Gemini 4 Carbon,称其在网络安全与长周期任务上能力最强,在 Artificial Analysis Intelligence Index v5.0 上以 59 分排名第一
 Meta Engineering
Meta Andromeda 下一代广告检索引擎通过模型-系统协同设计,在检索层实现近排名级模型性能,单卡单秒处理超过 10 亿广告,系统吞吐量达 1000 亿次/秒,较 2024 年版本提升 100 倍,并为广告主带来 2.4% 的转化率增长。
NVIDIA Newsroom5858NVIDIA RTX Spark笔记本电脑新增型号,搭载Blackwell RTX GPU和Grace CPU超级芯片,支持高达128GB统一内存和1 petaflop FP4 AI性能。
Hugging Face Blog精选7878NVIDIA 发布开源权重模型 Nemotron 3.5 Transcribe,把转写、说话人分离、翻译和音频问答合入同一 checkpoint,支持 40 种语言转写、31 种语言与英语互译、13 种语言说话人标注,可处理最长 1 小时录音并标注最多 8 位说话人。
推荐理由: 原文给出多语言转写、说话人分离与翻译的统一权重模型,并附开放数据管线和微调配方,可据此判断语音场景的适配路径。
Hugging Face Blog精选7676Liquid AI 发布 LFM3 新一代 Liquid Foundation Models,以 LFM3-1.7B-Base 为共享骨干派生六个 2B 级模型,覆盖文本、视觉、音频、全模态和决策,全部在 Hugging Face 开放权重。
推荐理由: Liquid AI 用同一 2B 级骨干派生六个模态模型,并给出单卡微调与端侧部署路径,可据此判断小模型专用化路线。
Google DeepMind精选8484Google DeepMind 发布世界模型 Genie 4,可实时生成带原生音频的交互式模拟世界,并以文本提示实时改变天气、镜头和场景元素。Genie 4 首次原生生成环境音与人声对话,角色可实时对话并响应场景事件;Gemini 3.8 Flash 在循环中充当引导智能体,把目标拆成步骤并逐帧校验。
推荐理由: 官方披露了原生音频、实时文本操控与 Gemini 引导推理三项能力,可据此判断世界模型在机器人与内容预演中的位置。
 Microsoft AI News
MAI Cyber 1.1 Flash 在内部 MDASH 漏洞扫描评估套件上提供与 MAI Cyber 1 Flash 相当的性能,每扫描成本降低 18%。该模型更聚焦,使 MDASH 系统能以更低成本呈现有用发现,目前 MAI Cyber 已占 MDASH 扫描近 50%,MAI Cyber 1.1 Flash 通过 MDASH 对验证客户开放。
Microsoft AI News精选6767微软 AI 发布图像编辑模型 MAI Image 2.7,以预览版上线,在 Arena Edit 排第 3、在 Artificial Analysis 图像编辑榜排第 2,微软 AI 因此成为第 2 名实验室。
推荐理由: 微软公布 MAI Image 2.7 在两个图像编辑榜单的排名,并给出相对上一代在 10 类用例上的提升幅度。
蚂蚁 inclusionAI · Hugging Face 新模型5858inclusionAI/Ling-3.1-flash-1019 发布,560B 参数量,25B 活跃参数/Token,1M 上下文窗口,推理能力提升,AA-Briefcase 分数 1524 Elo,AutomationBench-AA 68%,Artificial Analysis Intelligence Index v4.3.2 44 分。支持 SGLang 和 vLLM 推理。