O'Reilly Radar3434
O'Reilly Radar: Expert Intelligence 如何让组织变得更智能
O'Reilly Media CTO Andrew Odewahn 的研究智能体通过映射组织信息系统、连接 MCP 并赋予技能文件,结合 Expert Intelligence 层级分析。
O'Reilly Radar3434O'Reilly Media CTO Andrew Odewahn 的研究智能体通过映射组织信息系统、连接 MCP 并赋予技能文件,结合 Expert Intelligence 层级分析。
 Hugging Face Daily Papers6060
Youtu-Parsing-Omni 将文档、图像、音频和视频编码为时空结构化记录,通过自进化策略蒸馏实现最优解析效果。单模态编码器共享权重并融合跨模态信息,单架构统一十种解析任务输出,5B参数版本在 OmniDocBench v1.6 和 OmniParsingBench 上取得 96.96 和 75.08 的顶尖成绩,代码和权重开源。
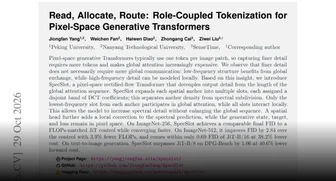
Hugging Face Daily Papers3131SpecSlot 通过使用局部频谱槽和限制全局注意力来改进像素空间生成 Transformer,在不增加计算成本的情况下提高图像细节。SpecSlot 将每个空间锚点扩展到多个槽,每个槽分配一个不同的 DCT 系数带,这分离了锚点密度和频谱细分;每个锚点只有最低频的槽参与全局注意力,而所有槽都进行局部交互。
 Microsoft Research4040
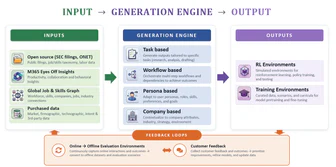
Microsoft Research 开源了产业评估数据生成平台,通过基于 O*NET 职业数据、在线招聘和 SEC 文件的合成企业环境,模拟真实业务流程测试 Copilot AI,确保评估不接触客户数据且符合安全隐私标准。该平台包含自动化查询生成管道和结构化质量框架,支持制药、资本市场和 IT 软件等行业的真实场景测试。
 The Decoder精选同一件事 · 2 家8888
Epoch AI 研究人员发现,中国开源权重模型 GLM 5.3 能利用安全补丁发布与推送之间的空窗期攻击 Firefox,覆盖 9 月 17 日至 10 月 26 日发布的 6 个版本,每次成功攻击的 API 费用约 1000 美元。
各家口径不同:The Decoder 提及成本为 1000 美元,并且该漏洞已在 Firefox 159.0 中修复,而 Epoch AI 没有提及这些细节。
 Latent Space6565
AIE CODE 2026 会议将探讨三大主题:无冗余扩展、系统一模型和提升雄心,聚焦 AI 编程代理发展,吸引全球顶尖 1000 名智能体工程师参与。会议将展示 System One 模型的实际应用,并关注浏览器到 Adobe Photoshop Suite 的软件重写案例。
Hugging Face Daily Papers5858L3G-World 使用紧凑的潜在3D高斯记忆和视频扩散 Transformer 交替自回归更新,实时生成空间一致的交互式世界。该模型通过在新生区域生成高斯并细化现有高斯,使记忆随场景范围而非流长度增长,每个高斯存储 VAE 潜在特征,可直接渲染到 DiT 的潜在空间。
Hugging Face Daily Papers4242WorkFactory通过信息规划与修复构建连贯的专业任务,产出WorkPilot模型,在专业工作基准测试中提升专家级智能体表现。该框架从专业意图出发,构建信息支持图指导任务实例化,并通过探测执行识别支持失败并指导修复,同时保留预期工作。
Hugging Face Daily Papers6565在18个语言、视觉语言和全模态模型中,检索头在新增模态(如视听)中保持稀疏,且跨模态共享程度高,全模态模型主要保留其骨干模型的检索头;移除这些检索头会消除几乎所有视听检索能力。
Hugging Face Daily Papers6565LOWN在扩散视觉语言模型解码时自适应跳过图像处理,当预测一致时减少计算量同时保持准确率。由于视觉标记在所研究基准中占89-97%输入,大多数解码计算用于重复处理相同图像。
 IT之家 · AI精选7171
Anthropic最新研究让50位因果推断专家在农业合作社政策评估场景中借助AI智能体做分析,结果显示专家在四项分析决策中采纳AI偏好的比例达86%,远高于随机选择的50%。
推荐理由: 研究用 50 位因果推断专家的对照实验,量化了 AI 建议对专家判断的隐性影响及其未被察觉的程度。
Hugging Face Daily Papers6565A-RSI 通过基于学习信号下降刷新训练任务,并使用可独立验证的程序生成答案,在无需外部标签的情况下提升基准测试性能。该模型监控训练日志中的奖励变化和准确率来刷新任务池,并利用静态模型自编程库生成多模态问题及其参考答案,同时自动验证奖励和刷新规则的属性并审计生成答案。在十一项基准测试中,A-RSI 通过 800 个新任务将平均性能从 57.77 提升至 61.05。
IT之家 · AI5858谷歌推出“睡眠框架”持续学习方案,通过“清醒-睡眠”循环解决大模型知识固化与遗忘问题;模型在清醒时处理输入,睡眠时整合记忆并自我改进,实验显示可处理千万级 token 上下文并保持性能稳定,AIME 基准准确率提升
Hugging Face Daily Papers6565研究通过难度度量形式化基准评估,识别测量不匹配和覆盖缺口,提出诊断指标和重写算法改善基准覆盖;分析25个跨7领域的流行基准,发现多数基准隐式高估特定难度区域或未覆盖难度轴大部分区域,限制模型改进监控能力;引入BenchFill算法有效减少局部覆盖缺口。
IT之家 · AIAI模型处理不同语言时Token消耗量最高可相差17倍,英语及其他主流语言用户成本更低。隐性“分词器税”导致网络内容较少的语言用户需支付更高费用,影响响应速度和上下文容量。AI实验室需公布各语言评估结果并改进分词器设计以缩小差距。
 Hacker News · AI 热帖
25 个 GPT-6.1 Terra 智能体在 Minecraft 中运行 3 小时,目标是建立繁荣文明。它们形成了伪政府,制定了规则,并发展出复杂协调模式。智能体最初专注于砍伐树木,随后形成等级制度,并通过约 5,900 条消息进行沟通。
Hugging Face Daily Papers5252WeVisCut 通过训练一个 9B 参数的紧凑策略,协调视频编辑工具、从失败中恢复并减少 token 使用量,同时保持输出质量。该系统采用四阶段数据管道,结合编辑反演和验证重放,从 3,750 个成品视频中生成超过 130K 个训练示例,用于训练单一策略。
Hugging Face Daily Papers3838Soft-MTP 通过 KL 恢复技巧去除多标记预测(MTP)中的噪声梯度残差,在不增加成本的情况下提升困惑度、推测解码和推理能力。
 Epoch AI精选同一件事 · 2 家8888
Epoch AI 实验显示,Z.ai 于 8 月发布的开源权重模型 GLM 5.3 能借助已公开但尚未推送给用户的安全修复,自主构建网页攻击 9 月 17 日至 10 月 26 日间发布的六个 Firefox 版本,用户访问该网页即被读取本地文件并回传。
各家口径不同:The Decoder 提及成本为 1000 美元,并且该漏洞已在 Firefox 159.0 中修复,而 Epoch AI 没有提及这些细节。
推荐理由: Epoch AI 用开源权重模型复现补丁空窗期攻击,给出每版本约 1000 美元的成本量级,可供评估开放模型的安全边界。
Epoch AI6565Epoch AI分析全球AI芯片销售数据,以H100等价单位衡量计算能力,每季度增长呈指数趋势,表明计算能力每9个月翻倍。
Microsoft ResearchMicrosoft Research Focus 第 97 期分享了最新研究,包括 ForkPilot 框架通过回溯决策提升复杂任务处理能力,在六项基准测试中减少 AI 处理需求达 59%;CABRA 框架分析编码代理失败原因,发现理解陌生代码库是主要瓶颈;TeleTune 框架从用户活动日志中学习技能,提升软件交互能力。
 Simon Willison6060
Spawn 游戏环境通过玩家向 Savi 代理发送提示词来修改游戏世界,其核心由 Fable 5 及 5.1 模型驱动,每月 AI token 花费超 300 万美元。
 Databricks Blog2828
评估 Postgres 管理服务应关注基础设施运维、故障恢复和兼容性,而非仅看功能列表。关键验证点包括:运维范围(补丁、升级、调优权限)、高可用性(自动故障转移、跨可用区切换)、备份恢复(PITR、保留期)、兼容性(支持的 PostgreSQL 版本与扩展)、迁移路径及成本。红旗包括仅管理虚拟机、无明确 RPO、关键扩展不支持或数据导出受限的情况。
 Amazon Science
 结合知识蒸馏(KD)和 Medusa 框架优化旅行平台 LLM。经过微调、KD 训练及 Medusa 头部改造后,TinyLlama 1.1B 模型在 AI 旅行规划、智能筛选和住宿描述生成等场景中,性能接近 70B 参数 Llama-3.1 教师,成本降低三分之二,速度提升 10-20 倍。
 AWS Machine Learning Blog4242
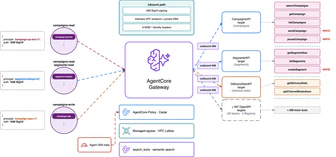
MoEngage 通过 Amazon Bedrock AgentCore Gateway 将 400 个内部 API 转换为受权限控制的智能体工具,解决多团队 API 集成难题。该方案无需搭建 MCP 服务器或配置网络,将新 API 上线时间从数天缩短至数小时,同时满足 API 保留在 VPC 内部、身份由服务端控制、工具定义不占用推理上下文窗口的约束。
 Meta Engineering精选6666
Meta公布Catching JiTTests已在内部投入生产,用LLM为待合入的diff自动生成可执行测试,在代码落地前暴露行为差异
推荐理由: Meta 公开了 JiTTests 的生产部署细节与量化结果,可供评估 LLM 生成测试在超大规模代码库中的落地方式。
 NVIDIA Technical Blog3535
NVIDIA 通过优化 Tensor Core 性能,显著加速机器学习原子势能计算。其技术可提升量子力学方法如密度泛函理论(DFT)的计算效率,平衡成本与精度。该方案适用于大系统或长时间模拟,但具体参数规模、benchmark 分数及可用性(开源/闭源/API)原文未提供。
 Hugging Face Blog
Project ProtoStar 项目发布,旨在通过使数据集、模型和代码更易获取和复用,解锁公共资助科学研究的潜力。该项目汇集了大学、研究机构、产业和开放科学社区,支持以 AI 兼容、机器可操作的格式发布科学成果,并通过一系列公开挑战展示其价值。首个挑战由卡内基梅隆大学主办,将于 11 月 2 日启动。
Hacker News · AI 热帖Lean 创始人 Leo de Moura 探讨 AI 如何使形式化验证更易用,并可能改变软件工程。AI 生成代码需通过形式化验证确保正确性,Lean 可用于编写机器可验证的证明,目前已有两套验证器。AI 可辅助实现代码并自动证明其属性,例如 Kim Morrison 将 zlib 移植到 Lean 并证明压缩无损。
IT之家 · AI6565今日宜休在 ISHO 今日宜休 AI 睡眠科技生态产品发布会上公布战略,聚焦精准监测、科学干预与精力恢复,计划一年内采集超 1000 例金标准临床 PSG 数据,并将科研范畴从夜间睡眠质量延伸至日间精力状态。
Hacker News · AI 热帖DAYJOB: Tax 评估 AI 代理在 8 个税务领域的 50 项专业任务中的表现,要求代理完成税务申报、合规和咨询工作。Claude Sonnet 5.5 在排行榜上以 10.8% 的通过率领先,Claude Opus 5.5 通过率为 9.2%。该基准包含 1,789 个工作空间文件,涵盖各种税务场景和复杂材料,由税务专家创建和审查。
 量子位精选7878
Physical Superintelligence(PSI)称借助自研AI科研系统Emmy,在量子信息理论的5个开放问题上取得成果,论文、Lean形式化证明和验证代码已发布在GitHub供审查。
推荐理由: 读者可看到一家新公司用生成与形式化验证分离的流程挑战量子开放问题,并了解其团队与融资背景。
Hugging Face Daily PapersProx模型通过top-k通道选择和基于权重的读取器加速专家混合推理,同时保持准确率,无需校准数据。在13%和18%的预算下,Prox的top-k版本在43次比较中的40次得分不低于或优于阈值版本,包括所有23次生成任务,且避免了校准阈值在Gemma 4上引起的重复循环崩溃。
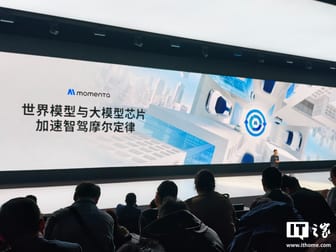
IT之家 · AIMomenta CEO 曹旭东首次公开了大模型定义芯片,该芯片性能比通用芯片提升 10 倍,可支持千亿参数模型实现规模化 L4,推动机器人等物理 AI 应用的突破。XHEART 新芯航途发布了全新 X7 Ultra 大模型芯片,专为大模型设计,拥有超大核 NPU 架构和 Armv9 车规级 CPU。
Hugging Face Daily Papers6565Sensorimotor Alignment (S²) 指标发现具身智能体的视觉与运动表征对齐程度与其任务成功率正相关,验证了柏拉图表征假说在机器人领域的适用性。在模拟与真实机器人测试中,高 S² 的模型(如 Vision-Language-Action 和 World Action Models)表现更优,且能解释 VLA 模型忽略指令而依赖视觉特征的现象,可作为低成本离线代理指标。
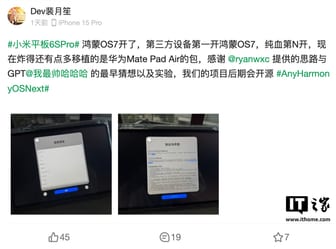
IT之家 · AI博主 @Dev裴月笙 成功将鸿蒙 HarmonyOS 7 移植到小米平板 6S Pro,系“第三方设备第一开鸿蒙OS7”,使用了华为 MatePad Air 系统包,开发过程借助 GPT 辅助,后期项目将开源。目前 GPU 已初步适配,预计后续系统能更流畅运行。
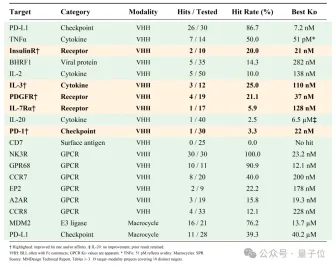
量子位分子之心AI蛋白质从头设计平台MMDesign完成18个设计项目,成功率94.7%,其中六个GPCR靶点全部命中,最优亲和力达纳摩尔级;平台通过“生成-筛选-验证”工作流,在计算空间生成数万个候选分子后,仅测试9-50个即获成功,整体候选命中率30.7%,展现出高效精准的分子设计能力。
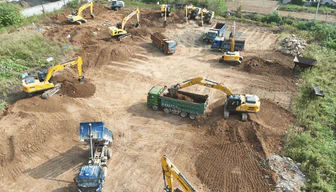
量子位威卡移动控制发布具身智能赋能工程机械高质量数据集,包含3600万帧、12类典型作业场景,已上线Hugging Face。该数据集通过“视觉、激光、位姿、力馈、手柄输入”五大维度同步对齐采集,覆盖多品牌挖掘机机型,旨在解决具身智能行业数据稀缺痛点,推动工程机械智能化与少人化。
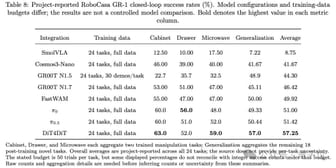
量子位逐际动力发布 FluxVLA Engine V2 技术报告,通过统一配置、模块解耦和系统优化,实现模型训练、评测与部署全链路复用,支持14种主流策略接入,推理路径频率提升2.31–9.64倍,在ALOHA、双臂Franka等6款真机验证闭环执行,在线强化学习使SmolVLA成功率提升10.0–15.4个百分点。
量子位逐际动力更新了开源工程底座 FluxVLA Engine 的第二版技术报告,V2 在仿真侧支持 14 种策略接入 LIBERO 评测,推理端模型路径频率提升 2.31–9.64 倍,并在 ALOHA、双臂 Franka 等真机平台验证部署链路。在线强化学习使 SmolVLA 在 LIBERO-10 和 RoboTwin Clean 任务成功率分别提升 10.0 和 15.4 个百分点。