Artificial Analysis Articles7575
Mistral 发布 Mistral Large 4,法国成为美国和中国以外最智能模型所在地。
Mistral 发布 Mistral Large 4(1T 参数,49B 活参数),在人工智能分析指数上得分 38,与 GPT-6 Luna(最高分 38)和 DeepSeek V4.1 Flash(最高分 39)相当,使法国成为美国和中国以外拥有最智能模型的国家。
Artificial Analysis Articles7575Mistral 发布 Mistral Large 4(1T 参数,49B 活参数),在人工智能分析指数上得分 38,与 GPT-6 Luna(最高分 38)和 DeepSeek V4.1 Flash(最高分 39)相当,使法国成为美国和中国以外拥有最智能模型的国家。
 Google Developers Blog
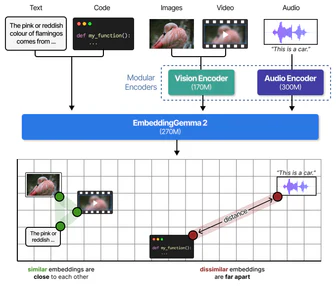
EmbeddingGemma 2 是基于 Gemma 4 开发的 740M 参数开源模型,将文本、代码、图像、视频和音频映射到统一 768 维空间,支持模块化加载(270M-740M 参数),在代码搜索和跨模态检索上表现优异,可通过 sentence-transformers 库使用。
 Liquid AI Blog
Liquid AI 推出 d1 决策模型,现支持文本与图像输入,在六项实际应用中超越 GPT-6.1 Sol 和 Claude Opus 5.5,成本降低 19-200 倍且速度显著提升。
 Google DeepMind
Gemini 4 Argon 在复杂工作流程中提供前沿性能,支持软件工程、企业知识工作(法律和金融)以及网络安全防御。该模型的输出令牌限制扩展至行业领先的 1M,并在 DeepSWE v1.1(77.9%)、Vals Index(金融、编码、法律、税务)、AutomationBench(51.3%)等基准中领先。
 OpenAI Deployment Safety
GPT-6.1 Sol 使用与 GPT-6 Astra 相同的数据和训练方法,在生物学和化学领域被评估为高能力,未跨越临界阈值。在网络安全评估中表现优于所有先前生产模型,但在合成和半合成智能体环境中较 GPT-5.6 Sol 略有下降,模型拒绝仍是安全边界的一层。
 Claude.dev Blog
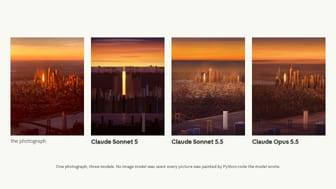
Claude Sonnet 5.5 是 Claude 5.5 家族继 Opus 5.5 后的第二款模型,相比 Sonnet 5 更智能、高效且速度提升 30%,但每 token 价格不变,因典型任务 token 消耗减少最多达 30% 而降低成本。
 Claude 应用发布说明
Anthropic 发布 Claude Sonnet 5.5,Claude 5.5 家族中第二款模型,作为 Claude Opus 5.5 的更快、更低价补充。
 Anthropic精选5555
Anthropic 推出 Sonnet 5.5,作为 Opus 5.5 的更快补充,用于范围明确的任务、错误修复和文档创建。其发布公告称,相比 Sonnet 5,性能和效率均有提升。
推荐理由: 编辑要点:将各模型与你自己的编码和文档任务进行对比。此次发布强调日常工作,同时区分更复杂、开放式的工作负载。
 小米 MiMo · Hugging Face 新模型
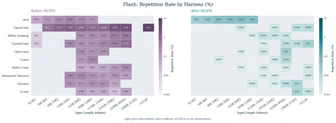
Xiaomi MiMo 团队发布 MiMo-V2.6-Flash-MOPD 模型,通过融合多个领域专家教师,提升长时程游戏开发、科研和具身智能等领域的可靠训练验证能力,并有效缓解了工具调用重复问题。
小米 MiMo · Hugging Face 新模型XiaomiMiMo/MiMo-V2.6-Pro-MOPD 融合多个领域专家教师,扩展到长时程游戏开发、科学研究等可靠训练验证困难的领域。
Liquid AI Blog7575Liquid AI 发布 DSpark 视觉语言模型加速器 LFM2.5-VL-3B,通过轻量级 drafter 模型在边缘和 GPU 上将解码吞吐量提升 2.66 倍(GPU)和 3.13 倍(边缘设备)。
 Baseten Blog
NVIDIA Nemotron 3 Diarization 模型以约100M参数的Transformer架构实现实时语音标签识别,每音频小时成本仅0.01美元。
Claude 应用发布说明Anthropic 发布 Claude Opus 5.5,该模型性能达到 Claude Fable 5.1 水平,运行成本比 Opus 5 低 40%。
小米 MiMo · Hugging Face 新模型小米 MiMo 通过在 MiMo 生成的数据上对 Qwen3.5-9B 进行监督微调,发布了 9B 参数的智能体模型 MiMo-V2.6-Distill-Qwen-9B,涵盖编码、通用智能体任务、视觉编码和网络安全领域。
Anthropic精选8282Anthropic 推出了 Opus 5.5,对编码、沟通和保障措施进行了更新。该公司描述了专注于复杂任务,并报告称其典型运行成本低于 Opus 5。
推荐理由: 编辑要点:持续的工程工作需要与快速分类不同的评估。在更改生产模型之前,请查看原始发布和安全文档。
 Qwen · Hugging Face 新模型
Qwen/Qwen-Image-2.1-PE-I2I 发布,一个 7B 参数的统一文本到图像生成与编辑模型,包含 32 层单流 DiT 架构,支持生成常规或透明图像、编辑透明图层、提取照片主体,并具有 10 张参考图像编辑能力。
Qwen · Hugging Face 新模型Qwen/Qwen-Image-2.1-PE-T2I发布,一款7B参数的统一文本到图像生成与编辑模型,包含32层单流DiT架构,支持生成常规或透明图像、编辑透明图层、提取照片主体,并可通过圆形、涂鸦标注或独立掩码进行局部编辑。其文本到图像提示词重写模型Qwen3.5-VL 9B可将多语言请求转化为详细英文提示词并推荐宽高比。
 阶跃星辰 · Hugging Face 新模型
阶跃星辰发布旗舰模型 Step-5-Preview-BF16,600B 总参数、27B 活跃参数,支持高达 1M 上下文窗口,在软件工程、专业知识工作及金融领域表现突出,可处理文本、图像和视频,通过 OpenAI 兼容 API 或离线生成部署。
阶跃星辰 · Hugging Face 新模型阶跃星辰发布旗舰模型 Step-5-Preview,采用 600B 总参数、27B 活跃参数的稀疏 MoE 架构,支持高达 1M token 上下文,兼顾软件工程、专业知识和金融任务,在 DeepSWE v1.1 评测中表现优异。模型可通过 vLLM 或 SGLang 以 OpenAI 兼容 API 方式部署,或使用 Transformers 进行离线生成。
Google DeepMindGoogle DeepMind 推出 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 大型语言模型,前者专为规模和成本效益设计。
 Google · Hugging Face 新模型
谷歌发布了EmbeddingGemma 2,一个包含740M参数的多模态嵌入模型,支持文本、图像、视频和音频的统一768维向量表示。该模型可在消费级硬件上运行,提供低延迟的语义表示,适用于搜索、检索增强生成等应用。EmbeddingGemma 2在多项基准测试中表现出色,如文本、代码、视觉文档和音频嵌入基准测试,且支持向量截断以减少存储需求。
 Cognition Blog
SWE-2是我们迄今最先进的编码模型,在FrontierCode 1.1 Main评测中取得50.0%分数,以64%的成本优势接近Fable 5.1的表现,并首次将强化学习扩展到万亿参数规模。
OpenAI Deployment SafetyOpenAI 的 GPT-Image-2.5-Sunburst 和 GPT-Image-2.5-Flare 使用公开数据、第三方信息和用户生成内容训练,并经过严格数据过滤。OpenAI 通过图像特定能力评估和现有生物/网络安全框架评估,确认这两款模型未跨越生物或网络安全高风险阈值,但按高风险模型标准应用了额外安全措施。
 Microsoft AI News
MAI-Image-2.6 成为迄今最强图像模型,在 Arena 排名第二,在 Artificial Analysis 排名第一;MAI-Image-2.6-Flash 生成图像速度比 GPT-Image-2-Medium 快 2.8 倍,效率提升 72%。两者均支持多图像参考编辑、网络接地和动态宽高比,MAI-Image-2.6 以最佳每 Elo 性价比表现帮助生产团队控制成本。
Microsoft AI NewsMAI-Transcribe-2 在 FLEURS 基准测试中跨 60 种语言平均 Word-Error-Rate 为 5.2%,在 Artificial Analysis 上定义了准确性与延迟的帕累托前沿。
Google · Hugging Face 新模型Google 发布 GNM-v3 3D 人体头模型,提供精细控制面部身份、表情和姿态的参数化模型,包含可控内部解剖结构。模型支持 NumPy、JAX、PyTorch 和 TensorFlow,采用 Apache 2.0 许可证。
 DeepSeek · Hugging Face 新模型
DeepSeek-V4-Flash-Vision-Exp 发布,DeepSeek-V4 家族首个实验性多模态模型,在 DeepSeek-V4-Flash 架构基础上集成视觉模块并持续训练以解锁视觉理解能力。
 智谱 Z.ai · Hugging Face 新模型
智谱发布 GLM-5.3-Flash,首个原生多模态 GLM-5 系列模型,拥有 320B 总参数和 18B 活性参数,在基准测试和实际工作负载中超越 GLM-5.2,价格仅为其十分之一,编码和智能体基准测试接近 Claude Opus 4.8。
Google · Hugging Face 新模型Google 发布预训练时间序列基础模型 TimesFM 3.0,采用 Stacked Mixing Transformer 架构,上下文长度 32+64,20 层 Transformer,参数量 1280,支持量化中位数预测,使用 GiftEvalPretrain 预训练,遵循 TimesFM Non-Commercial License v1.0。
Liquid AI BlogLiquid AI 发布 LFM2.5-230M、LFM2.5-350M、LFM2.5-1.2B-Instruct 和 LFM2.5-2.6B 的 4-bit 检查点,采用量化感知蒸馏(QAD)技术,在保持 Q4_0 GGUF 低内存占用和高速处理的同时,恢复约 97% 的 BF16 精度。
 MiniMax News
MiniMax Music 3.0发布,通过创意概念和可选歌词一次性生成完整歌曲。该模型通过改进生成流程,更准确捕捉创作者意图,支持长达五分钟的歌曲,并提升乐器清晰度和人声自然度。其核心架构包括8B Global LLM(基于Qwen3.5-8B初始化)、0.6B Local LLM及2.4B流匹配模块,结合多层级残差矢量量化(RVQ)和Flow-VAE实现高保真音频重建。
Microsoft AI News微软推出 MAI-Thinking-1 推理模型,35B 活性参数、~1T 总参数的稀疏专家混合模型,在 SWE-Bench Pro 上与 Claude Opus 4.6 并列,AIME 2025/26 分数达 97.0%/94.5%。该模型未使用第三方模型蒸馏,采用清洁、可追溯的企业级数据训练,并通过 Hill-Climbing 机制持续优化能力。
Liquid AI Blog精选7171Liquid AI 发布 LFM2.5-VL-3B,这是在其前代 LFM2-VL-3B 基础上升级的 3.1B 端侧视觉语言模型,已在 Hugging Face 和 Playground 上线。
推荐理由: 原文给出 28 项基准、端侧与 GPU 吞吐数据,可对照同尺寸竞品判断这颗 3B 视觉模型的实际位置。
Microsoft AI NewsMAI-Image-2.6 发布,在 Arena 文本到图像排行榜上排名第二,整体评分比 MAI-Image-2.5 提升 +79 Elo,并在所有 Arena 文本到图像类别中取得进步,文本渲染能力提升 +91 Elo,领先 Meta、Google 和 xAI 的模型。
 MiniMax · Hugging Face 新模型
MiniMax Music 3 支持5分钟完整歌曲生成,结合8B Global LLM和0.6B Local LLM,通过歌词和音乐描述生成结构连贯、音质稳定的歌曲。模型采用连续隐藏状态合成系统,输出32 kHz/16位立体声WAV音频,支持通过[Verse]等标签和结构化描述实现精细控制。基于SGLang-Omni部署,输入歌词和描述即可生成音乐,无需离散tokenizer解码。
Liquid AI Blog精选7171Liquid AI 发布 LFM2.5-2.6B,这是一个完全在设备端运行的智能体模型,可完成规划、工具调用和多步任务,基础版与后训练版均已上线 Hugging Face。
推荐理由: 原文给出端侧智能体模型的完整训练流程与多基准对比,可据此判断小模型在本地跑智能体的实际位置。
MiniMax NewsMiniMax 发布 H3 模型,支持文本、图像、视频和音频的统一上下文理解,能生成带原生立体声的 2K 分辨率视频(最长 15 秒)。
MiniMax · Hugging Face 新模型MiniMax-H3 是一个通用多模态生成系统,支持统一理解文本、图像、视频和音频,能生成最高 2K 分辨率、最长 15 秒的带立体声音频的视频。其 H3-Context-IR 模块用于深度理解输入指令并转化为 H3-Base 可理解的中间表示,但未开源。H3-Base 和 H3-Regenerate-2K 模块分别负责 768p 和 2K 分辨率的音频视频生成,前者开源,后者需 API 调用。
Liquid AI Blog5858LFM2.5-Encoder-230M 和 LFM2.5-Encoder-350M 是两款基于 LFM 混合架构的新双向编码器,设计用于分类、自然语言理解和 token 级任务。在输入长度高达 8,192 个 token 时,它们的质量与更大编码器相当,但扩展性更温和。
 Meta AI Blog
Meta AI 的 DINOv3 和 SAM 模型在边缘计算中实现实时感知,支持匹兹堡大学 RAMMP 项目开发辅助机器人,通过自然语言与图像数据交互,降低用户认知负荷,已在原型中集成自动门按钮检测、杯子识别及导航辅助功能,并计划增加语音和触控输入支持。