Edge0 开源 145B 与 120B 端侧模型及推理框架。
Edge0 开源 Edge0-145B 和 Edge0-120B 两个端侧模型,并同时发布统一推理框架与部署工具。官方称 145B 模型可在兼容笔记本上本地运行,峰值内存 29GB、解码速度 80+ tokens/s、预填充 1100+ tokens/s,支持 128K–256K 上下文。
推荐理由: 原文给出端侧 145B 模型的实测内存、速度与多项基准对比,可据此判断本地运行前沿级模型的现实边界。

今天最值得读的 AI 新闻,来自正在塑造 AI 的实验室、创业公司和研究者。
Edge0 开源 Edge0-145B 和 Edge0-120B 两个端侧模型,并同时发布统一推理框架与部署工具。官方称 145B 模型可在兼容笔记本上本地运行,峰值内存 29GB、解码速度 80+ tokens/s、预填充 1100+ tokens/s,支持 128K–256K 上下文。
推荐理由: 原文给出端侧 145B 模型的实测内存、速度与多项基准对比,可据此判断本地运行前沿级模型的现实边界。
Google 发布 Gemini 4 Hydrogen 模型,称其能更好地回答包含多个部分、拼写错误或高度具体需求的复杂问题,并会拆解问题逐项回应。
推荐理由: 原文列出了 Gemini 4 Hydrogen 在搜索与 Gemini 应用中的默认位置和可用入口,读者可据此判断它对现有搜索问答流程的影响。
Google DeepMind 发布 Gemini 4 Hydrogen,面向日常编码与智能体工作流,在默认 high 思考档位下 Artificial Analysis 智能指数为 51,高于 Argon 的 50,xhigh 档位可达 54
推荐理由: 官方给出Hydrogen与Carbon、Argon的分工定位,以及多模型编排在成本与速度上的实测差异。
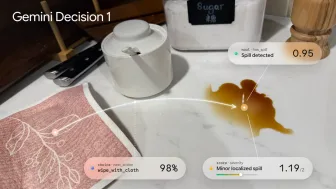
Google DeepMind 推出 Gemini Decisions API,面向是/否、多选和量表评分等封闭式判断,底层模型 Gemini Decision 1 单次可处理最多 1000 个独立问题,覆盖文本、图像、音频、视频和 PDF。
推荐理由: Gemini Decision 1 把封闭式判断做成独立 API,并给出延迟、价格与基准表现,便于对照近期同类决策模型。
Claude Mythos 5.2 预测出完整的 AAV 衣壳结构,该衣壳由 60 条相同的蛋白链组成。它编写代码让开源折叠模型处理相邻五链的重叠分组,再利用衣壳对称性把 60 条链拼接起来。在 AAV2 上,其预测与实验结构的偏差约为一个原子的宽度。
推荐理由: 原文给出了模型在真实科研任务中的具体做法与精度,读者可据此判断它在结构预测类工作里的可用边界。
Anthropic 发布 Claude Fable 5.2,面向最艰巨的技术挑战,在编码、推理和视觉方面有所提升,适合最具野心的开放式技术工作。官方建议多数编码与知识任务优先使用 Opus 5.5,Fable 5.2 已在 Pro、Max、Team 和 Enterprise 套餐上线。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
推荐理由: 官方说明了 Fable 5.2 的定位与适用场景,并给出与 Opus 5.5 的选择建议,便于判断该用哪个模型。
Thinking Machines 发布 Inkling 2 Small,在 Artificial Analysis Intelligence Index v5.0.1 上得分 31,比 Inkling Small 高 18 分,与 Gemini 3.8 Flash (high) 持平。
推荐理由: 第三方评测给出 Inkling 2 Small 与 Gemini、Claude 等模型在智能指数、编码和幻觉率上的逐项对比,可据此判断其定位。
蚂蚁百灵官方团队发布原生多模态模型 Ling-3.2-flash,拥有 560B 总参数、25B 激活参数和 1M 上下文窗口,支持图像、文本与视频输入。
推荐理由: 原文给出三项基准对比与 API 定价,读者可据此判断这款多模态模型的能力位置与调用成本。
百度于11月5日正式开源基座模型文心5.5 Flash Base(ERNIE 5.5 Flash Base),采用 MoE 架构,总参数量2800亿,每个 Token 激活140亿参数,预训练使用33.5万亿 Token,预训练上下文最高128K,微调与推理阶段支持最长100万 Token 上下文。
推荐理由: 原文给出文心5.5 Flash Base 的架构与训练细节,读者可据此了解其效率优化思路与同尺寸对比位置。
开发者 Divyansh Agrawal 于 10 月 22 日发布实验性模型 Qwenputer,基于阿里 Qwen3.5-4B 构建,在神经网络内部实现 32 位 RISC-V CPU 与内存功能,无需调用 Python 等外部工具即可执行程序和精确计算。
推荐理由: 开发者将 RISC-V 指令集编译进 Qwen3.5-4B 权重,用具体基准数字展示了模型内计算的精度提升与体积、速度代价。
Mistral 发布多模态 MoE 模型 Mistral Large 4(Le Chonk),约 1T 总参数、49B 激活参数,上下文窗口 1M tokens,提供 FP8 与 NVFP4 两个官方版本,另有 Unsloth 和 llama.cpp 团队制作的 GGUF。
推荐理由: 原文给出 1T 总参数、49B 激活的 MoE 多模态模型在网络安全与编码基准上的具体分数,并附本地与端点部署实测吞吐。
法国 Mistral AI 发布 Large 4 模型(ML4),具备编程和网络防御能力,企业可部署在自有计算机和服务器上运行。该模型在欧洲数据中心训练,使用 3800 颗英伟达 Grace Blackwell GPU,总参数量 1.05 万亿,每次执行任务实际激活约 520 亿参数。
推荐理由: 原文给出了模型规模、训练算力和可本地部署的定位,读者可据此判断企业私有化部署的选项。
Google DeepMind 面向开发者、企业、科学家和消费者开放 Gemini 4 Carbon,称其在网络安全能力和长程智能体工作流上达到前沿水平。
推荐理由: 官方给出 Carbon 与 Argon 的定位分工、多项基准排名和每任务成本对比,便于判断何时该用更重的模型。
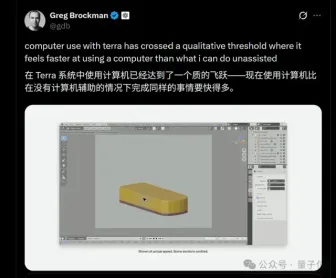
OpenAI发布GPT-6.1 Terra,标准API输入1美元/百万Token、缓存输入0.05美元/百万Token、输出5美元/百万Token,价格约为GPT-5.6 Terra的一半。
推荐理由: 原文给出GPT-6.1 Terra的官方基准、API定价与网友实测成本对比,可据此判断低价电脑操作模型的性价比边界。
百度开源 Unlimited OCR 2,一个 3.34B 参数的 OCR 视觉语言模型,可在单次请求中解析数百页书籍、财报和报告,权重以 MIT 协议发布,代码在 GitHub。
推荐理由: 原文给出 SR-SWA 的稀疏注意力机制与百页文档基准对比,可看长文档 OCR 的上下文成本如何被压平。
OpenAI 发布新模型 GPT-6.1 Terra,主打以更低成本完成需要视觉推理和操作桌面软件的复杂任务,于 10 月 27 日向 Plus、Pro、Enterprise 和 Edu 用户开放,可在 ChatGPT Work 和 Codex 中使用,API 模型标识为 gpt-6.1-terra。
推荐理由: 原文给出多项基准与每任务成本对比,读者可据此判断低成本模型在桌面自动化上的取舍。
OpenAI 发布 GPT-6.1 Terra,这是 GPT-5.6 之后的首个 Terra 级模型,输入/输出定价为每百万 token 1 美元/5 美元,低于 GPT-5.6 Terra 的 2 美元/12 美元。
推荐理由: 原文使用 Intelligence Index 与 Coding Agent Index 的分数和每任务成本,量化了 GPT-6.1 Terra 相对于 GPT-5.6 Terra 的性价比变化。
岩山科技旗下岩芯矩阵联合港科大、CMU 等高校发布并开源 EdgeRock-4B,在 256K 上下文下 KV Cache 固定为 72MiB,相比源模型 Qwen3.5-4B 减少 99.1%。
推荐理由: 原文给出固定内存下的吞吐与基准对比,可据此判断长上下文推理的显存成本走向。
Kimi K3.1 Pro 今日上线 Kimi API,尚未开放权重,Moonshot 承诺 2026 年 11 月 4 日前发布完整模型权重。定价为输入 $2.00/百万 token、输出 $10/百万 token,与 GPT-6.1 Sol 相同、为 Claude Opus 5.5 的一半,另提供速度快 2-3 倍、价格翻倍的 Highspeed 版本。
月之暗面发布推理模型 Kimi K3.1 Pro,在 Artificial Analysis 智能指数上得分 55,排名第四,比 Kimi K3 的 44 分提升 11 分,仅次于 Claude Opus 5.5(58)、Claude Sonnet 5.5(56)和 Muse Wonder Full(56)。
各家口径不同:Artificial Analysis 提供了 55 分的评分并排名第四;MarkTechPost 提到了 2.8T 的总参数和 104B 激活参数的 MoE 模型。
推荐理由: 第三方评测给出 Kimi K3.1 Pro 在智能指数与智能体任务上的具体分数和排名,可与前代及闭源模型直接对照。