量子位精选同一件事 · 3 家8282
MiniMax开源图像模型H3-Image:原生4K、支持16张参考图
MiniMax开源图像模型H3-Image支持原生4K(4096×4096像素)生成,最多可输入16张参考图。作者实测其能根据产品外观图推演正交三视图和机械爆炸图,并在人脸毛孔、雀斑等细节上减少塑料感。API价格为主流竞品的50%到70%,首周16MP请求再打五折。
量子位精选同一件事 · 3 家8282MiniMax开源图像模型H3-Image支持原生4K(4096×4096像素)生成,最多可输入16张参考图。作者实测其能根据产品外观图推演正交三视图和机械爆炸图,并在人脸毛孔、雀斑等细节上减少塑料感。API价格为主流竞品的50%到70%,首周16MP请求再打五折。
 vLLM Blog精选6060
vLLM-Omni 团队将 MiniMax H3-Image 接入 NVIDIA Vera Rubin,四卡 SP4 配置下原生 4096×4096 文生图短提示词基准中位延迟 0.87 秒,四副本 SP1×DP4 吞吐达 6115 张/小时。
推荐理由: 原文给出 H3-Image 在 Vera Rubin 上的实测延迟、吞吐与跨硬件部署配置,可据此判断 4K 图像生成的部署成本。
 IT之家 · AI6565
摩尔线程宣布旗下 MTT S5000 智算卡及 MUSA 软件栈已适配 MiniMax H3-Image 图像生成模型。该模型可在 10 秒内生成 4096×4096 像素高分辨率图像,速度达市面主流 5 倍。摩尔线程基于 MTT S5000 进行全链路优化,支持文本生成图像、图像参考和编辑能力。
 MiniMax News精选同一件事 · 3 家8080
MiniMax 发布了基于 H3 的开源权重图像生成模型 H3-Image,支持文生图、参考图生成和图像编辑,可在 10 秒内生成 4096 × 4096 的 4K 图像,最多支持 16 张参考图。
推荐理由: 官方给出 4K 生成速度、参考图数量和定价区间,可据此判断开源图像模型与闭源方案的差距。
 Comfy Blog
MiniMax H3 图像现已原生支持 ComfyUI,提供 4096×4096 高分辨率输出,支持文本生成图像和参考图像编辑,通过 Partner Nodes 也可直接运行。
IT之家 · AI同一件事 · 3 家MiniMax H3-Image 发布并开放权重,10 秒生成 4096x4096 像素 4K 图像。模型具备文本生成图像、图像参考和编辑能力,速度达市面主流 5 倍,支持 16 张参考图,首周 16MP 生成请求五折。
 MiniMax · Hugging Face 新模型
MiniMax-H3-Image-PE 通过提示扩展(PE)将简短请求转换为详细图像描述并推荐宽高比。它支持文本到图像(T2I)和图像编辑两种工作流程,使用微调自 Qwen3.8-27B 的 FP4 权重。在线 API 可通过 platform.minimax.io 或 platform.minimax.cn 访问,文档提供中英文支持。
MiniMax · Hugging Face 新模型MiniMax-H3-Image 是 MiniMax H3 家族的一款开源图像生成与编辑模型,支持 16MP 图像生成、图像编辑及最多 16 张参考图像,采用 H3 架构并使用 Qwen3-VL 文本编码器,在 Hugging Face 上提供 68.65GB 的 BF16 精度模型权重。
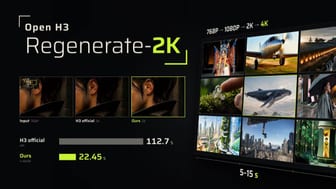
量子位英伟达与麻省理工学院团队开源视频增强方案 Open-H3-Regenerate-2K,基于 MiniMax H3 模型将低分辨率视频重生成 2K(2560×1440)或 4K(3840×2160)视频。
Comfy Blog7070使用 FastVideo 的 FastH3 V2 检查点,通过四步采样、稀疏注意力、小型文本编码器、小型检查点和融合 FP4 MLP 等优化,在单个 RTX 5090 GPU 上生成 15 秒 448×256 分辨率的视频,VRAM 需求从 80GB 降至 <30GB;该自定义 Comfy 节点已开源,可通过 Comfy API 请求 GPU 和模型进行部署。
MiniMax NewsMiniMax 发布 H3 模型,支持文本、图像、视频和音频的统一上下文理解,能生成带原生立体声的 2K 分辨率视频(最长 15 秒)。
MiniMax · Hugging Face 新模型MiniMax-H3 是一个通用多模态生成系统,支持统一理解文本、图像、视频和音频,能生成最高 2K 分辨率、最长 15 秒的带立体声音频的视频。其 H3-Context-IR 模块用于深度理解输入指令并转化为 H3-Base 可理解的中间表示,但未开源。H3-Base 和 H3-Regenerate-2K 模块分别负责 768p 和 2K 分辨率的音频视频生成,前者开源,后者需 API 调用。
 MarkTechPost
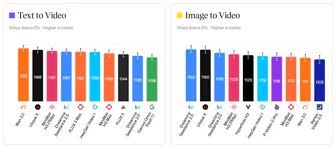
Elo排名显示Alibaba Wan 3.0(1175 T2V Elo)居首,每秒价格0.20美元;Utopai X(1170 T2V Elo)并列第二但无API;MiniMax H3(1161 T2V Elo)为首个开源视频模型,每秒0.08美元,但受地域限制。排名依据盲测人类偏好,结合每秒API价格与权重许可状态。
 蚂蚁 inclusionAI · Hugging Face 新模型
inclusionAI 发布 Duo 1.0 causal-base 模型,这是一个用于实时音视频交互的全双工多模态世界模型,包含实现权重和主干、意图模型和适配器、音视频编解码器、语音识别器和强制对齐器。该模型权重基于 MiniMax H3 初始化,并已开源。
IT之家 · AI新华三完成 H3C UniServer R4930 G7 服务器核心平台迭代升级,搭载全新国产处理器,单机最高 192 核、768 线程,单线程 IPC 性能提升超 15%。
量子位3838海马云旗下 RunningHub 平台通过自研算力池和垂直模型后训练,将算力利用率提升至行业 70% 以上,推出 RH Upscale 超分模型、H3 Lightning 视频生成模型等,实现低成本、高效率的 AI 内容生产。平台整合 Agent、工具链与专家知识上下文,支持模型动态路由和智能编排,用户无需掌握复杂操作即可完成专业级任务,每月 Token 消耗量达 9 万亿。
 Latent Space
No AI Slop 宣言在 AIE CODE 会议讨论后发布,由 Dex 在闭幕主题演讲中引入并获多发言人联署,旨在为工作讨论提供实用工具;该宣言已获 Hacker News 支持。
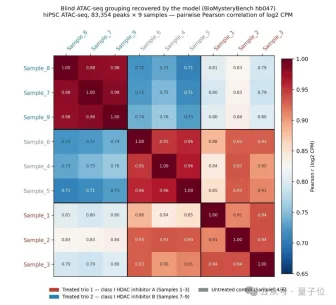
量子位无界前沿开源生物信息大模型Fx-Bio-1031,在BioMysteryBench基准测试中,困难子集Pass@5达到70.59%,大幅领先GPT-6-Astra(47.06%)和Claude Opus-5(52.94%)。Fx-Bio-1031采用125B参数的高效MoE架构,支持本地化部署,适用于药物研发、多组学分析等场景。
Latent Space精选8888NVIDIA 宣布黄仁勋在执掌 33 年后辞去 CEO、总裁和董事会成员职务,SEC 文件显示董事会于 11 月 11 日接受辞任,公司于 11 月 12 日公布;2013 年起担任 CFO 的 Colette Kress 保留原职并出任临时 CEO,Harvey Jones 成为董事会首位主席,董事会已启动继任者搜寻。
推荐理由: NVIDIA 董事会接受黄仁勋辞任、CFO 临时接任,同时 Anthropic 递交 IPO 注册文件,两条人事与资本动作同日出现。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI 发布 Duo 1.2 causal-base 模型,这是一个用于实时音视频交互的全双工多模态世界模型,包含改进的生成质量,模型权重可在 Hugging Face 下载。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI 发布 Duo-1.0-distill,一个用于实时音视频交互的全双工多模态世界模型,包含四步蒸馏的 Realization 权重,需与 causal-base 套件叠加使用。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI 发布 FP8-量化四步蒸馏的 Duo 1.0 Realization 权重,用于其因果基础模型,支持全双工实时音视频交互,需与因果基础模型权重叠加使用。
Latent SpaceMercor报告500万专家,年收入达30亿美元,AI推理支出已超员工薪酬三倍;该公司表示美国有800多种职业尚未被模型评估,AI投资正使其团队效率提升。
MarkTechPostMBZUAI 的 IFM 发布 PAN 2,一个开放 29B 参数扩散 Transformer(MMDiT)世界模型,输入文本和可选首帧,输出 704×1248 分辨率 24 fps 视频(最长 20 秒),在 100 步多任务中实现 34.0% 的完整计划完成率,领先 6 个测试模型,但长计划失败率高且硬件需求高,代码在 Apache 2.0 下开源。
MarkTechPost精选同一件事 · 5 家7171Thinking Machines Lab 发布第二代 Inkling 的首个模型 Inkling 2 Small,为 594B 总参数、17B 激活参数的稀疏 MoE,支持文本与图像输入和可变推理强度,上下文 1M token。
vLLM BlogVeRL-Omni v0.3.0 发布,将异步执行扩展到更多多模态强化学习工作负载,并将 V1 训练器设为默认选项,同时扩展了图像、视频、音频和多模态理解的后训练支持。
Latent Space同一件事 · 4 家6060Latent Space 报道 AI 领域最新动态,包括前沿大模型直接编辑权重技术(如 GPT-6 Astra 编辑 Qwen3.5-0.8B 权重使 MATH-500 从 7.9% 提升至 48.1%),以及腾讯 Hy4 在 APEX-Agents 上取得 75.2 分、Kimi K3.1 Pro 在 Agent Arena 排名第 14 位的最新评测结果。
IT之家 · AI5050苹果推送 macOS 27.3 Golden Gate 首个开发者测试版(26C5035r),距离 macOS 27.2 仅约一周,主要亮点或为扩展 Siri AI 语言支持至繁体中文,该功能或于 12 月随正式版上线。首批 Apple 智能技能通过 iOS 27.3 首个开发者预览版解锁 iPhone,Mac 等平台待后续更新。
 Simon Willison
Qwen 3.8 27B 也能在我的笔记本电脑上解释模型权重。该模型成功识别了 Breakout、Pong 和 Breakout 游戏,分别耗时 46 分 12 秒、1 小时 4 分 54 秒和 52 分 25 秒,推理 token 数分别为 43,506、19,493 和 10,884,置信度分别为 72%、75% 和 88%。
 Recode China AI6565
芯讯通(CXMT)第三季度净利 54.4 亿人民币,营收 118.71 亿人民币,同比增长 613.2%。其传统内存业务受益于全球竞争对手优先高价值产品,价格上涨。
量子位同一件事 · 2 家4242Utopai Studios完成融资估值10亿美元,其定制的视频模型Utopai X在文生视频和图生视频评测中均位列全球第二,配合自研制片智能系统PAI进入真实制作流程。公司与CJ ENM、Globoplay等达成合作,是首家加入好莱坞编剧协会与演员工会AI影视公司,2027年有多部作品将院线上映,包括奥斯卡提名演员安东尼奥·班德拉斯主演的历史史诗《科尔特斯》。
Latent Space6565AIE CODE 2026 会议将探讨三大主题:无冗余扩展、系统一模型和提升雄心,聚焦 AI 编程代理发展,吸引全球顶尖 1000 名智能体工程师参与。会议将展示 System One 模型的实际应用,并关注浏览器到 Adobe Photoshop Suite 的软件重写案例。
 SGLang releases00
GitHub Copilot v0.5.23 发布,提供代码生成、审查、安全和协作功能,支持自定义集成和高级安全特性。
量子位精选7272天数智芯发布基于天枢架构的云端通用GPU天垓300和端侧产品彤央TY1200,并在现场随机出题与英伟达H200、Jetson Thor T5000对比。
推荐理由: 现场随机出题、云端与端侧双线对比英伟达,并给出可复现的实测数字与软件栈落地方式。
 ChinaTalk3434
咸鱼,已故AI的作者,认为AI模型在写作方面缺乏幽默感,并分享了其创建一个让普通人通过梗的趣味性对视频模型进行排名的网站的经历。他还指出主流AI模型在编程能力提升的同时,写作能力反而下降,因此他已停止使用AI进行写作。咸鱼同时讽刺了AI领域中的Chinglish现象,并探讨了五年计划作为衡量标准的问题。
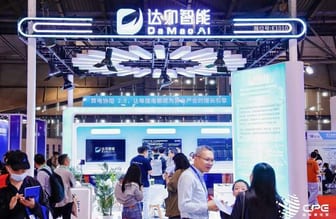
量子位达卯科技在CPE 2026上提出E-AIDC能源驱动型智算中心新范式,通过能源AI系统解题路径破解绿电直连僵局,实现投资方IRR提升约20%、用户到户电价下降10%。其全栈算电协同技术产品体系包含能源大模型与智能体集群,支持多源时空、多市场数据预测和全局统筹策略求解。
 Hugging Face Blog
Hugging Face 发布 TorchTPU,使 TPU 成为 PyTorch 的原生后端设备。Transformers、Diffusers 和 Kernels 现可直接在 TPU 上运行,用户只需从 Hugging Face Hub 选择模型,指定 device_map="tpu" 即可。
SGLang releasesSGLang v0.5.22 发布,新增 Model Type Cookbook、Clef、Clef Flash、PPLX-Decider v1/v1.1、EmbeddingGemma 2。
Hugging Face BlogTorchNeuron 为 PyTorch 在 AWS Trainium 提供新原生后端,Transformer、Diffusers 和 Kernels 均原生支持,使在 Trainium 上运行模型和在 HF Hub 分享模型变得前所未有的简单。
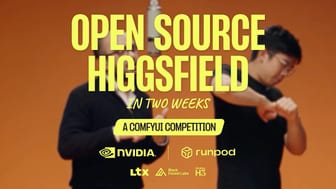
Comfy Blog5252Comfy博客承诺开源其整个平台但未兑现,因此Comfy启动了一个竞赛,为Genjutsu、Cinema Studio等创意应用的最佳开源重建提供资金支持,大奖为10,000美元,并设有多个奖项类别,包括最具创新性和病毒式传播的应用,所有参赛作品必须使用开放权重模型。