IT之家 · AI6565
小米MiMo Desktop会员权益升级:额度加量不加价、新增DeepSeek等第三方模型
小米MiMo Desktop会员额度提升,加量不加价,新会员及现有会员均实时生效。新增DeepSeek V4 Pro、DeepSeek V4.1 Flash、GLM 5.3、GLM 5.3 Flash、Kimi K3、Qwen 3.8 Flash、Qwen 3.8 Max等第三方模型供会员选择,各模型标注消耗倍率。
IT之家 · AI6565小米MiMo Desktop会员额度提升,加量不加价,新会员及现有会员均实时生效。新增DeepSeek V4 Pro、DeepSeek V4.1 Flash、GLM 5.3、GLM 5.3 Flash、Kimi K3、Qwen 3.8 Flash、Qwen 3.8 Max等第三方模型供会员选择,各模型标注消耗倍率。
 量子位精选同一件事 · 10 家8888
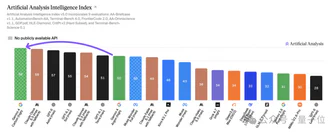
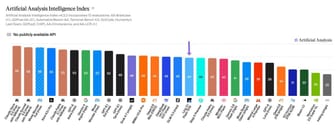
谷歌发布 Gemini 4 Carbon,在 Artificial Analysis 智能指数 5.0 上以 59 分登顶,Terminal-Bench 4.0 得分 65.2%,高于 Claude Opus 5.5 的 59.6% 和 GPT-6 Astra 的 59.1%。
量子位同一件事 · 2 家扩散智能发布Clover-35B-A3B-Preview模型,350亿参数量在网页Agent评测WindTunnel中中位执行时间1.52秒,速度比Jev+Mercury 2.5组合快一倍,成功率98.6%。模型采用MoE架构,支持思考模式,在SWE-bench Verified上取得73.6分。
 Latent Space精选8282
Google DeepMind 发布 Gemini 4 Carbon,距 Argon 仅两周,宣称在网络安全与长周期任务上达到 SOTA,在 Artificial Analysis Intelligence Index v5 上以 59 分位列第一。
推荐理由: 汇总了 Gemini 4 Carbon 在多个独立榜单上的位置与定价,并列出编码、幻觉率等与竞品的差距。
 MarkTechPost精选同一件事 · 3 家7171
NVIDIA 发布 Nemotron 3.5 Transcribe,这是一个开放权重的语音大模型,单模型支持 40 种语言、最长 1 小时音频,并可输出逐字稿、书面体、说话人标注和翻译结果。
 Hugging Face Daily Papers
Falcon是一个因果音视频目标说话人提取模型,通过目标说话人嘴部视频从嘈杂重叠语音中提取其声音,结合单次多尺度时频分离器和编码器空间说话人对比损失,在不增加推理成本的情况下减少干扰说话人泄露。
 ByteDance Seed · Hugging Face 新模型
ByteDance-Seed/GenFirst 训练一个潜在 VAE 并联合一个生成先验,避免通常使端到端训练不稳定的潜在崩溃。该方法的两个阶段计划用于先验和熵权重:第一阶段让先验塑造潜在几何形状,第二阶段将两者权重十倍降低,使解码器恢复细节。
IT之家 · AI腾讯宣布混元 Hy4 即将发布,相比 Hy4 preview 全面提升,首次引入视觉理解能力,强化长程和生产力任务;Hy4 flash AI 模型同期推出,提供极致性价比,继承 Hy4 视觉与 Agent 能力。
 36氪 · AI同一件事 · 10 家
谷歌发布新一代前沿AI模型Gemini 4 Carbon,用于维护网络安全防御并处理复杂工程问题,能够处理长流程AI智能体任务、生成安全代码,并降低模型失准和编造信息的比例。
 The Verge · AI同一件事 · 10 家
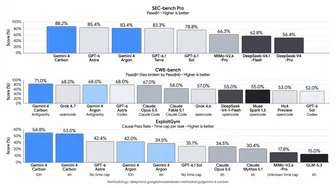
谷歌发布最新大模型Gemini 4 Carbon,在编码、智能体任务和网络安全方面取得“显著提升”。该模型在人工智能分析指数(v5.0)基准测试中排名第一,并在SEC-bench Pro和ExploitGym评测中表现优异。
IT之家 · AI精选同一件事 · 10 家8585谷歌正式发布新一代前沿大模型 Gemini 4 Carbon,主打顶尖网络安全能力与长程任务处理,在 Artificial Analysis Intelligence Index v5.0 中以 59 分排名第一。
 The Decoder精选同一件事 · 10 家8989
Google DeepMind 在 Argon 发布两周后推出 Gemini 4 Carbon,该模型在 Artificial Analysis Intelligence Index v5.0 上以 59 分登顶,前代 Argon 为 50 分。
MarkTechPost精选同一件事 · 10 家8080Google DeepMind 推出 Gemini 4 Carbon,称其为面向长周期智能体编码与网络安全防御的前沿模型,在 Artificial Analysis Intelligence Index v5.0 上以 59 分排名第一。
 Ars Technica · AI同一件事 · 10 家6565
Google 发布了 Gemini 4 Carbon,在编码、智能体任务和科学分析方面达到了新的阈值,但尚未开放使用。该模型在网络安全应用中显著提升了漏洞检测、验证和修复能力,生成无漏洞代码的概率是 Argon 的两倍,生成高质量补丁的能力是非 Google 模型的 10 倍。
 PyTorch Blog5858
PyTorch® 2.15 发布,默认采用重写的 NCCL 后端,支持故障记录和回滚;torch.distributed 新增 NIXL 后端的单边传输;FSDP2 和流水线并行优化内存通信控制。
 Google DeepMind精选同一件事 · 10 家8282
Google DeepMind 发布 Gemini 4 Carbon,称其在网络安全与长周期任务上能力最强,在 Artificial Analysis Intelligence Index v5.0 上以 59 分排名第一
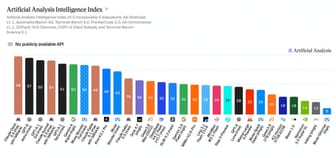
IT之家 · AI6262人工智能分析指数v5发布,60%评测权重首次基于私有测试集,DeepSeek V4.1 Flash 1017在FrontierCode 2.0上获得28%得分领跑开源模型,但综合排名仍落后Claude Opus 5.5 26分。
 Meta Engineering
Meta Andromeda 下一代广告检索引擎通过模型-系统协同设计,在检索层实现近排名级模型性能,单卡单秒处理超过 10 亿广告,系统吞吐量达 1000 亿次/秒,较 2024 年版本提升 100 倍,并为广告主带来 2.4% 的转化率增长。
The Decoder5858Artificial Analysis 更新其智能指数,Kimi K3.1 Pro 排名从第四降至第九,被八款封闭模型超越,公开模型与榜首差距扩大至 12 分。新指数 60% 依赖私有测试集以防止 "benchmaxxing" 行为,Grok 4.7 也下降 12 分,但封闭测试集的缺点是外界无法发现提示词错误。
The Decoder精选同一件事 · 3 家7171Nvidia 发布开源语音识别模型 Nemotron 3.5 Transcribe,支持 40 种语言转写、31 种语言与英语互译、13 种语言的说话人识别,可处理最长 1 小时、最多 8 人的录音。
 NVIDIA Newsroom5858
NVIDIA RTX Spark笔记本电脑新增型号,搭载Blackwell RTX GPU和Grace CPU超级芯片,支持高达128GB统一内存和1 petaflop FP4 AI性能。
 Hugging Face Blog精选7878
NVIDIA 发布开源权重模型 Nemotron 3.5 Transcribe,把转写、说话人分离、翻译和音频问答合入同一 checkpoint,支持 40 种语言转写、31 种语言与英语互译、13 种语言说话人标注,可处理最长 1 小时录音并标注最多 8 位说话人。
推荐理由: 原文给出多语言转写、说话人分离与翻译的统一权重模型,并附开放数据管线和微调配方,可据此判断语音场景的适配路径。
IT之家 · AI摩尔线程开源 Megatron-MUSA-Titan 项目,支持万卡级集群的万亿参数 MoE 模型训练,覆盖预训练与强化学习场景,实现高 MFU 与长稳训练。项目支持 blockwise FP8 训练,结合 DeepEP 与 ACE 异步通信引擎加速 Token 分发与结果合并,提升端到端训练效率。
Hugging Face Daily PapersSPOT 通过预测 token 生成顺序并行验证候选,将扩散语言模型的遍历次数减少高达 6.8 倍,同时保持精确解码。该 0.62M 参数模型读取目标输出分布,预测顺序并提出候选树,目标模型通过状态等式在单次遍历中验证。SPOT 在 SDAR-8B 上将目标遍历次数减少至标准解码的 1/6.8,吞吐量提升 3.4 倍,并在所有任务和预算下超越校准无训练基线。
IT之家 · AI同一件事 · 2 家Liquid AI 发布 LFM3 模型家族,首批多款均基于 LFM3-1.7B-Base,其中 LFM-1.7B 拥有 256K 上下文窗口,在参数减少 35% 的同时性能优于上代 LFM2.5-2.6B。
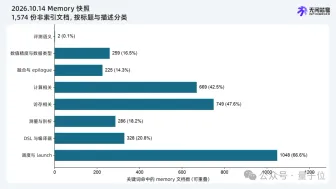
量子位5858无问芯穹在NVIDIA Research推出的GPU算子性能评测榜单SOL-ExecBench上以88项单题第一位居所有参赛团队之首,覆盖L1基础算子、L2融合算子、Quant量化算子与FlashInfer-Bench推理算子四大赛道。其通过容器化隔离架构、模块化Skills与共享记忆机制,结合针对不同计算场景的精细化优化策略,实现了AI自主完成复杂算子优化的能力。
IT之家 · AI6565开发者在 DeepSeek Harness GitHub 代码库中发现 deepseek-v5、deepseek-v5-open 和 deepseek-v5-next 三个模型标识符,目前仅作为框架占位符。
MarkTechPost精选同一件事 · 7 家7777Google DeepMind 发布研究预览版 Genie 4,可从文本和图像提示实时生成可探索世界,并原生生成环境音、音乐和角色对话。该模型在仿真循环中引入 Gemini 作为规划器,由 Gemini 3.8 Flash 拆解目标、检查帧并重新规划,Gemini Omni 负责锚定世界的外观与行为。
各家口径不同:The Verge 表示模型支持长达两分钟的场景,而 Ars Technica 和 TechCrunch 提到物理和人物模拟的改进,但没有具体说明场景时长。
Hugging Face Daily Papers6565Looped Transformers 在相同计算量下通过完整回溯时训练优于截断回溯,扩展规律表明当模型大小可调时两个循环为最佳。Looped Transformers 通过复用共享层块增加计算深度而不增加可训练参数量,通常使用回溯时训练(BPTT),但为节省训练计算量常截断至最后几循环,这可能导致梯度偏差削弱循环优势。
量子位同一件事 · 2 家蚂蚁集团旗下百灵大模型开源 Ling-3.1-flash-1019,在智能指数 AA-Briefcase 中得分 1524 Elo,较上一版本提升 3 分;基础模型 Ling-3.1-flash-base 采用混合线性 MoE 架构。
Hugging Face Daily Papers6565Test-Time Memory Evolution (TTME) 方法通过更新外部存储而不改变模型权重,比Test-Time Training (TTT)更高效地指导科学发现。在五个数学任务上,TTME优于TTT,同时将FLOPs计算成本降低82.8-84.6%,运行时间减少47.7-58.4%。
 Artificial Analysis Articles
人工分析智能指数 v5 发布,首次超 60% 基于私有数据集评估,新增 FrontierCode 2.0 和 Terminal-Bench-Science 基准,Claude Opus 5.5 在综合指数中领先,但 Kimi K3.1 Pro (权重未发布) 在开放权重模型中表现最佳。
IT之家 · AI同一件事 · 2 家微软推出 MAI-Image-2.7-Preview 模型,在 Artificial Analysis 评测中排名全球第二,仅次于 OpenAI 的 GPT Image 2.5 Sunburst (max)。
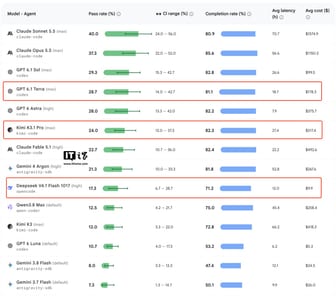
IT之家 · AI6565谷歌更新的 Android Bench 榜单显示,Gemini 4 Argon 通过率 21.3%、完成率 81.8%,排名第五,远落后于 Claude Sonnet 5.5(通过率 40%、完成率 80.9% 榜首)和 GPT-6.1 Sol(通过率 29.3%、完成率 82.8% 榜二),其平均调用成本 267.70 美元。
36氪 · AI4040OpenAI发布GPT-6.1 Terra模型,可解读图纸、编辑视频,标准API价格比GPT-5.6 Terra和GPT-6.1 Sol低50%。
IT之家 · AI同一件事 · 7 家3535谷歌 DeepMind 推出研究预览版世界模型 Genie 4,可生成高拟真可交互虚拟世界,支持实时编辑场景、同步生成音频,还计划向 AI Ultra 订阅用户开放。
各家口径不同:The Verge 表示模型支持长达两分钟的场景,而 Ars Technica 和 TechCrunch 提到物理和人物模拟的改进,但没有具体说明场景时长。
IT之家 · AI精选同一件事 · 7 家8282谷歌DeepMind于10月27日发布Genie 4世界模型,定位为重大研究里程碑,用户可用自然语言指令实时改变天气、镜头、角色和物体,而非重新生成一段视频。
各家口径不同:The Verge 表示模型支持长达两分钟的场景,而 Ars Technica 和 TechCrunch 提到物理和人物模拟的改进,但没有具体说明场景时长。
IT之家 · AI精选同一件事 · 7 家7777谷歌 DeepMind 推出世界模型 Genie 4,目前处于研究预览阶段,可生成可交互虚拟世界并在运行中输入提示词修改场景,还能生成与画面同步的实时音频。相比前代 Genie 3,Genie 4 画面拟真度提升,支持实时调整天气、镜头角度和增删人物物体,最长维持两分钟连贯场景,为前代的两倍。
各家口径不同:The Verge 表示模型支持长达两分钟的场景,而 Ars Technica 和 TechCrunch 提到物理和人物模拟的改进,但没有具体说明场景时长。
MarkTechPost精选同一件事 · 2 家7171据 Hugging Face 博客和 MarkTechPost,每个模型均可在单张 GPU 上微调;文本模型 LFM3-1.7B 为 1.73B 参数、256K 上下文窗口,4-bit 量化下约 1 GB 内存即可运行,可部署在手机、笔记本、私有服务器或云端。MarkTechPost 称免费商用上限为年营收 1000 万美元,完整 128K 上下文需 1.6 GB KV 缓存。IT之家称 LFM-1.7B 参数比上代 LFM2.5-2.6B 减少 35%,性能却更优。
推荐理由: 6 个 2B 级开源模型共享同一骨干,并给出与 Qwen3.5-9B 等竞品的逐项对比,可据此判断小模型在端侧与智能体任务上的位置。
 Ollama releases
Liquid AI 发布 LFM3 小模型家族,包含 1.7B 参数的 lfm3 文本模型(256K token 上下文)、支持图像理解的 lfm3-vl、18 语言语音处理能力的 lfm3-audio 及通用模型 lfm3-omni,用于本地智能体和结构化输出;d1 决策模型升级至 2B 参数,支持文本、图像及音频决策,部分模型支持苹果硬件。