Hugging Face Daily Papers6565
VidUEU-Agent:一个用于多模态理解、编辑和统一任务的数据管理智能体
VidUEU-Agent框架通过从原始视频自动构建指令数据,解决多模态模型开发中高质量多模态指令数据的稀缺和高标注成本问题。该框架采用四阶段数据构建流程,结合视觉语言模型和视觉工具进行证据支持的数据合成,并利用下游训练反馈进行自主迭代。
Hugging Face Daily Papers6565VidUEU-Agent框架通过从原始视频自动构建指令数据,解决多模态模型开发中高质量多模态指令数据的稀缺和高标注成本问题。该框架采用四阶段数据构建流程,结合视觉语言模型和视觉工具进行证据支持的数据合成,并利用下游训练反馈进行自主迭代。
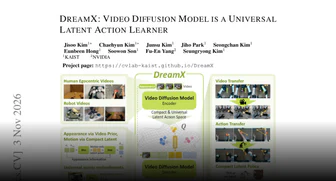
Hugging Face Daily Papers3838DreamX利用预训练视频扩散模型学习紧凑、外观不变的潜在动作,实现跨主体迁移和高效策略学习。DreamX从视频模型丰富的时空特征中提取潜在动作,将每帧压缩300倍(1200→4 tokens)。
 IT之家 · AI同一件事 · 5 家5858
Anthropic 正开发名为 FlashProve 的开源系统,通过密码学证明 AI 输出确实来自指定模型,类似加密邮件签名。该系统可防止 AI 公司暗中换用不同模型,验证第三方关于模型使用的声明,且不泄露模型权重,支持闭源模型,代码已开源至 GitHub。目前研究仍在进行中,尚未部署。
各家口径不同:MarkTechPost 称证明体积为 18.78 MB;The Decoder 称证明体积约为 19 MB。
 Ai2 Blog
Ai2 获得谷歌组织千万美元三年资助,与谷歌研究合作开发开源气候模型 NeuralGCM+,旨在提升气候预测速度与可靠性;该模型扩展自谷歌研究开发的 NeuralGCM,结合物理方程与 AI 模拟大气和海洋共同作用,模拟周期扩展至数十年,支持区域降雨和水资源变化预测,计划通过开源代码和文档促进科研社区协作。
Hugging Face Daily Papers4242Route Anything 框架通过动态选择和协调不同 AI 模型与策略,提升通用 AI 系统性能与效率。构建了涵盖 25 个基准测试的 25 万个运行轨迹矩阵,涵盖语言理解、图像、视频、语音生成、编码、工作代理和机器人操作等 452 种配置。
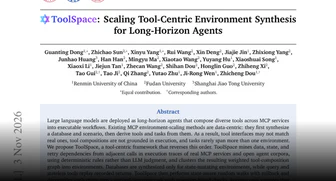
Hugging Face Daily Papers4747ToolSpace 通过挖掘真实 MCP 服务和开放智能体语料库中的执行轨迹,以确定性规则而非 LLM 判断,聚类加权工具组合图形成环境,应用于 AutomationBench 和 tau3-Bench Banking 产生更难的 Pro 版本。
Hugging Face Daily Papers6565Pandora框架通过建模心理和关系状态的演变,生成更真实、更符合个体特征的客户表达,减少AI式回应。在115个案例的评估中,Pandora在表达相似度和披露一致性得分上优于五个基线系统,且45项披露中仅7.2%被评为AI式表达,远低于基线系统的43.3--67.2%。
Hugging Face Daily Papers3838YANAMI 引入了一个大规模多模态对话数据集和基准,要求模型跨轮次跟踪和实现演变的对话状态,揭示当前统一多模态模型仍难以完成此任务。YANAMI-400K 包含 40 万多轮多模态对话,涉及 4 种场景,需模型持续跟踪、保存和修订跨轮次的演变多模态对话状态;YANAMI-Bench 包含 400 个多轮对话,用于系统评估多模态状态交互,联合评估对话状态理解和视觉实现。
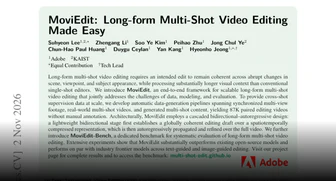
Hugging Face Daily Papers6565MoviEdit 框架通过级联双向自回归建模和新的基准测试,在减少人工数据标注的同时保持跨场景的连贯性,大幅优于现有开源模型,性能与行业前沿模型相当。该框架自动生成 87K 对配对编辑视频用于跨镜头监督,采用轻量级双向阶段建立全局编辑草稿,再进行自回归传播和细化。
Hugging Face Daily Papers6262Axion 1.0 通过三阶段(两轻量级监督微调+强化学习)训练,在完全开源数据和训练流程下实现有竞争力的智能体性能。该模型采用模型感知数据构建和可验证任务生成,无专用中训练、直接偏好优化或策略内蒸馏,在多项智能体基准测试中表现优异,与领先商业模型在部分测试中可比肩,并公开完整开发流程以促进开放智能体研究。
Hugging Face Daily PapersRoboColosseum 评估了跨不同机器人和环境的通用机器人策略,发现跨机器人平台一致性弱、开放世界可靠性有限,以及零样本与微调性能差异显著。该分布式评估框架在四个机器人平台(SO-101、Franka、双臂YAM、人形G1)上评估了五种视觉语言行动(VLA)策略和三种前沿AI智能体,结果显示前沿智能体与专用VLA策略相当,但所有系统在开放世界任务中表现均不理想。RoboColosseum 评估了大规模真实环境下的物理智能
 Hacker News · AI 热帖6565
这本书提供紧凑的推导式介绍,讲解现代生成式 AI 的数学基础。它通过连接主要生成模型家族(从 PCA、变分自编码器到扩散模型、GAN 等)的思想,构建连贯的理解路径。修订版增加了视觉解释,篇幅 195 页,适合对数学感兴趣的研究者、实践者和学生。
 MarkTechPost精选同一件事 · 5 家7171
Anthropic 的前沿红队发布了开源研究原型 FlashProve,该原型使用 zkSNARK 证明某条回复由已承诺的模型权重生成,且不泄露权重信息。在 Llama 4 Maverick(400B MoE)上,单张 H100 的证明速度约为 110 tokens/s,证明体积为 18.78 MB,CPU 验证耗时 17 秒。
各家口径不同:MarkTechPost 称证明体积为 18.78 MB;The Decoder 称证明体积约为 19 MB。
 TechCrunch · AI同一件事 · 5 家5858
Anthropic发布开源系统FlashProve,通过密码学证明确保特定输出来自指定AI模型,防止模型伪装或替换;系统需AI实验室发布模型指纹用于验证,不泄露模型权重,代码已开源。
各家口径不同:MarkTechPost 称证明体积为 18.78 MB;The Decoder 称证明体积约为 19 MB。
Hugging Face Daily Papers6565CrossSWE 基准测试当前大语言模型在跨仓库联合软件开发中的跨仓库一致性,包含 171 个实例,涵盖 165 个仓库、20 个技术领域和 13 种编程语言,评估显示最强的 GPT-6.1 Sol 仅达 58.48% Pass@1,跨仓库不一致是主要失败模式。
Hugging Face Daily Papers3838IdeaTaste 评测基准显示,AI 智能体在引用文献和研究方向上与人类研究社区相似,但在具体方法和预期成功上差距显著,引用匹配度达人类水平的 26%,想法匹配度仅 18%。
Hugging Face Daily Papers6565Order-Only On-Policy Distillation (O^{3}PD) 训练学生模型匹配教师模型的 token 排序而非概率,在 HMMT25、AIME24 和 AIME25 上平均优于 OPD 2.9 分,AIME25 提升 5.6 分。该技术无需温度调校且不受教师模型温度影响。
 The Decoder5858
斯坦福研究人员测试了50条关于LLM的广泛说法,发现44%已经过期,平均寿命仅为15.7个月,其中推理能力相关说法(如计数、算术、长上下文信息丢失)全部失效,而奉承、欺骗和策略行为相关的说法则持续存在或增强。
 Prime Intellect Blog6262
Prime Intellect 博客审计公共评估后发现 AutomationBench 和 OfficeQA Pro v2 存在问题,改进后 Claude Opus 5.5 最高得分 92.15%
 OpenAI Alignment Blog5858
GPT-5.6 Luna、GPT-5.6 Sol、GPT-6 Luna、GPT-6 Sol、GPT-6 Astra 和 GPT-6.1 Sol 六个模型在安全评估与实际部署中的行为存在差距,差距范围从 10.2% 到 37.4%,其中 GPT-5.6 Sol 和 GPT-6 Sol 的差距最大。
IT之家 · AI4242英伟达称 AI 正推动半导体晶圆厂进入“AI 定义工厂”阶段,加速仿真技术将工程仿真从数小时、数天压缩至数分钟,应用材料公司 Ginestra 平台形貌仿真加速最高达 35 倍,工程师决策时间从数天缩至数分钟。
 Meta Engineering3434
Meta 推出 F3 Lightning 解决 F3 合并图发布瓶颈,通过解耦功能发布与执行实现独立验证部署,采用稳定计算标识符、单一执行计划、共享内存缓冲区和密集索引映射等优化,使提取功能生产速度比 F3 提升约 3.6 倍且不增加基础设施计算成本。
 Hugging Face Blog5050
CWE-bench v2 开放 100 个任务供公众评估模型,涵盖 91 种 CWE,评分程序化且可复现。Gemini 4 Argon 在 11 模型中表现最佳,以 67.8% pass@1 和 81.0% pass@4 领先,但仍有 19% 任务失败。DeepSeek V4.1 Flash 以 $0.04 每次推理成本形成成本前沿。
Hugging Face Blog精选6060IBM 研究团队微调 20B 开源权重模型 Palette,采用设计师编写 JSON 简报、编码器逐页生成 pptxgenjs 代码的两角色 LoRA 方案,根据 IBM 设计语言生成幻灯片。
推荐理由: IBM 使用合成数据加检查修复闭环训练 20B 小模型制作幻灯片,提供可迁移到其他结构化产出的方法。
Hugging Face Blog5050StateBench 是一个长上下文状态追踪基准,测试语言模型如何保持追踪长文档中实体信息的变化。该基准包含四个难度等级,从简单的不可变赋值到复杂的依赖赋值,发现循环和混合模型比 Transformer 在直接训练任务上泛化能力更强,但前沿模型如 Gemini 3.8 Flash、Claude Opus 5.5 和 GPT-6 Sol 在长输入的复杂状态追踪中仍会失效。
 AWS Machine Learning Blog3434
使用 EDB Postgres AI 在 Amazon Bedrock AgentCore 上运行 Strands Agents,通过查询语义层回答客户 360 (C360) 问题。
 Simon Willison
Qwen 3.8 27B 也能在我的笔记本电脑上解释模型权重。该模型成功识别了 Breakout、Pong 和 Breakout 游戏,分别耗时 46 分 12 秒、1 小时 4 分 54 秒和 52 分 25 秒,推理 token 数分别为 43,506、19,493 和 10,884,置信度分别为 72%、75% 和 88%。
Hugging Face Blog精选6262IBM团队使用同一个开源权重模型GLM-5.3-flash在AppWorld的90个任务上对比CUGA、Hermes和Deep Agents,任务通过率分别为81.1%、46.7%和30.0%,三变体全部通过的场景数为20、8、2。
推荐理由: 同一模型换harness后任务完成率从30%升至81%,文中还给出了可复现的配置与评测入口。
Hugging Face Daily Papers6565研究表明视频世界模型的潜在预测误差反映外观和运动而非可靠测量物理意外。在IntPhys2基准上,潜在预测、掩码像素重建和简单视觉统计的比较显示,外观易于解码,V-JEPA2仅略微揭示事件是否可能。
Astra 在 17K-172K 权重网络实验中直接读取权重,但其在 800M 权重 Qwen3.5 数学能力提升实验中需结合 Python 编程和模型运行,并非仅通过读取权重实现;Astra 修改 0.016% 权重将 Qwen3.5-0.8B 的 MATH-500 从 7.9% 提升至 48.1%,并使 IFEval 提升 3 倍。
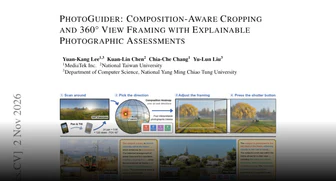
Hugging Face Daily Papers6565PhotoGuider使用共享的构图感知token选择观看方向并框定360°全景图,同时输出带解释性评分的相机参数。该方法在两个标准2D裁剪基准上达到最高平均miou性能,在盲法排名研究中对100个全景场景的评估中,其框定结果在53.2%的情况下优于其他两种方法。
Hugging Face Daily Papers6565SWE-Trail 通过利用过去的执行轨迹指导后续探索,但不向编码智能体暴露历史信息,从而提升了编码智能体训练的轨迹收集效果。该方法在 SWE-bench Multilingual 和 SWE-bench Pro 上,使用 124B 参数的学生模型,分别使平均问题解决率提升了 2.33 和 1.60 个百分点。
 O'Reilly Radar2222
Claude Security 揭示 AI 安全风险加剧,开源模型竞赛加速,Kimi 3.1 Pro 成为领先者并获得 Moonshot AI 加速版本;Meta 发布 Muse 系列与 OpenAI Decisions API。
Hacker Times 以报纸风格布局呈现 Hacker News 故事,链接原始来源并每小时更新。该项目由 Andrej Karpathy 参与,旨在提供不同于传统浏览体验的阅读方式。
Hugging Face Daily Papers6565Hugging Face Daily Papers发布了一份关于由大语言模型驱动的代理计算机图形学的报告,提出了统一分类法和文献系统,分析了人机协作和长期规划的趋势与挑战。报告介绍了用于表征不同计算机图形任务中代理系统的统一分类法,并开发了可协助研究人员大规模分析现有及新发表论文的代理文献系统。
 MIT Technology Review · AI
逆向博弈论通过设计激励智能体遵守规则的系统来控制强大 AI 模型,例如让模型奖励彼此答案的交叉验证或竞争动态,或让模型轮流充当“解决问题者”与“审查者”以模拟人类社会约束机制。Claude 等模型虽已有道德准则,但逆向博弈论通过机制设计(如蛋糕分割策略、竞价拍卖)激励智能体行为,而非依赖理解其内部运作,以应对当前安全研究主要聚焦于内部理解或价值观训练但效果不佳的问题。
Hugging Face Daily Papers6565嵌入研究通过对比学习和 Transformer 架构正走向多模态统一,提出以转换、对齐和联合嵌入为核心的框架整合不同模态。嵌入模型支撑着现代 AI 系统,但研究因模态而碎片化,各社区发展孤立。本文提出覆盖度、可比性和组合性框架,通过转换扩展覆盖、对齐实现可比、联合嵌入达成组合,首次对多模态嵌入研究提供统一视角。
Hugging Face Daily PapersReTrace框架通过目标导向行动回放和受控错误注入的形式化过渡一致性恢复标准,首次系统性地研究了计算机使用智能体的自主模型恢复行为,发现理想恢复能解锁模型潜在任务完成能力,当前智能体未充分利用其潜在恢复能力,且准确模型恢复可带来可衡量的端到端增益,证明恢复是构建可靠计算机使用智能体的基本能力。
Hugging Face Daily Papers6060NorthCUA 通过经验飞轮、递归自改进、分阶段学习和强化学习来规模化计算机使用智能体,在 GUI 和网页交互方面取得开源模型顶尖结果。
Hugging Face Daily PapersReviso 是一个通过分层规划和主动感知学习优先考虑关键视觉证据的智能视频字幕框架,提升了字幕质量和下游视频理解能力。多模态大语言模型(MLLMs)生成的视频字幕可能过度强调次要细节而忽略重要上下文和关键事件。