Hugging Face Daily Papers
PCBRouteAgent:LLM 智能体距离成为 PCB 布线工程师还有多远?
PCBRouteAgent 在 247 块合成和真实 PCB 上实现 100%、94.9%、100% 和 40% 的 D2、D3-A、D3-B、D3-C 清洁通过率,在三个真实世界子集上分别比最佳基线高 13.9、36 和 10 个百分点。
Hugging Face Daily PapersPCBRouteAgent 在 247 块合成和真实 PCB 上实现 100%、94.9%、100% 和 40% 的 D2、D3-A、D3-B、D3-C 清洁通过率,在三个真实世界子集上分别比最佳基线高 13.9、36 和 10 个百分点。
 OpenAI News
CodeRabbit使用OpenAI模型治理和信任AI生成代码,结合Codex将工程团队的软件交付量提升20倍。
 The Verge · AI同一件事 · 2 家6565
Apple 为 Logic Pro 提供 $49.99 一次性购买选项以扩展 AI 功能使用量,该功能允许用户继续使用因依赖 OpenAI 或 Google Gemini 云端 AI 模型而有限制的 Apple Intelligence 特性。
 Claude.dev Blog同一件事 · 6 家
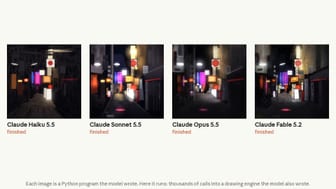
Anthropic 推出四种 Claude 模型供用户选择:Claude Haiku 5.5、Claude Sonnet 5.5、Claude Opus 5.5 和 Claude Fable 5.2。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
Hugging Face Daily PapersConfucius4-R2T2 是一个用于实时应用的稳定前缀流式语音识别模型,通过后训练将全上下文 ASR 模型转换为流式模型,无需架构修改。基于 Qwen3-ASR-1.7B 构建,R2T2 实现了近离线识别精度和低发射延迟,支持可配置的流式块大小,并展现出有前景的跨语言泛化能力。该模型和实现已公开发布。
 Google Developers Blog5858
Google Cloud 发布 MaxText v0.2.4,支持在 TPU 上进行长上下文训练,通过 MaxText Context Parallelism 技术,在 TPU 5p 上使 Llama 3.1 8B 模型达到 4 百万 token 长度的序列 70% 的 MFU,在 TPU 5p 和 TPU 7 上可无缝扩展至 14 百万 token
 AWS Machine Learning Blog5858
NVIDIA Nemotron 3.5 Super VL 已在 Amazon SageMaker JumpStart 中可用,支持图像、视频和文本输入生成文本。
AWS Machine Learning Blog同一件事 · 6 家Anthropic 在 AWS 上推出 Claude Fable 5.2 和 Claude Mythos 5.2,Fable 5.2 是其最强大的通用模型,适用于编码和科学领域,支持长达数天的无监督运行;Mythos 5.2 通过验证计划提供,在网络安全和生命科学领域表现更可靠。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
 The Decoder
Meta 发布 Muse Ember,其迄今为止最小且最高效的 AI 模型,专为处理 AI 代理日常的重复性任务设计,如调用工具、处理小规模编码任务、路由请求、提取数据和处理长文档。
Anthropic 发布 Claude Fable 5.2 和 Claude Mythos 5.2,在编码、推理和视觉任务上提升显著,支持多种复杂应用。
 One Useful Thing精选7878
Ethan Mollick在Claude Fable 5.2公开发布前试用后认为,按“在多数可用电脑完成的智力任务上达到多数人类专家水平”的定义,它接近AGI但仍有缺口。
推荐理由: 作者用六个跨领域实测案例说明模型能力已接近通用智能,但缺乏自我判断作品好坏的能力。
 Claude · YouTube精选同一件事 · 6 家7575
Anthropic 发布 Claude Fable 5.2,称其在编码、推理和视觉方面有所改进,面向最复杂、开放式的技术工作。官方建议多数编码和知识任务从 Opus 5.5 起步,Fable 5.2 已在 Pro、Max、Team 和 Enterprise 套餐上线。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
Claude · YouTube精选6868Claude Mythos 5.2 预测出完整的 AAV 衣壳结构,该衣壳由 60 条相同的蛋白链组成。它编写代码让开源折叠模型处理相邻五链的重叠分组,再利用衣壳对称性把 60 条链拼接起来。在 AAV2 上,其预测与实验结构的偏差约为一个原子的宽度。
推荐理由: 原文给出了模型在真实科研任务中的具体做法与精度,读者可据此判断它在结构预测类工作里的可用边界。
Claude · YouTube精选同一件事 · 6 家7575Anthropic 发布 Claude Fable 5.2,面向最艰巨的技术挑战,在编码、推理和视觉方面有所提升,适合最具野心的开放式技术工作。官方建议多数编码与知识任务优先使用 Opus 5.5,Fable 5.2 已在 Pro、Max、Team 和 Enterprise 套餐上线。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
推荐理由: 官方说明了 Fable 5.2 的定位与适用场景,并给出与 Opus 5.5 的选择建议,便于判断该用哪个模型。
 NVIDIA Technical Blog6565
NVIDIA Holoscan 5 通过持续计算逆动力学实现重力补偿,使机器人手臂在操作时仅需提供支撑重量的扭矩。该技术支持通过示教学习、物体操作或人机协作的机器人应用,依赖重力补偿回路构建。
The Verge · AI6565Instagram 发布 Effect Builder 功能,允许用户通过 AI 提示词创建自定义滤镜,支持附加风格参考图片并预览效果。提交的滤镜需通过安全审核后才能对其他用户开放,使用时会链接到创作者主页。
 TechCrunch · AI精选同一件事 · 6 家8282
Anthropic发布Mythos 5.2和Fable 5.2,称新模型在编码、推理和视觉方面有所提升,与用户沟通更清晰。Fable的输入价格从每百万token 10美元降至8美元,低于主要竞争对手GPT-6 Astra,响应速度提升30%,并可通过Enterprise Frontier Safeguards支持零数据保留(ZDR)政策。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
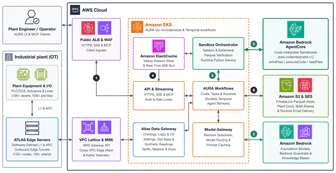
AWS Machine Learning Blog3838CrossnoKaye 通过其 ATLAS 平台和 AURA 智能体,在 Amazon Bedrock AgentCore 上实现工业物理 AI,将生产提效 11-17% 并降低能耗 21%。AURA 利用 AgentCore 的代码解释器能力,在隔离微 VM 中运行 Python 工作负载以验证数值计算,同时通过边缘集群和云优化系统实现闭环控制。
 Epoch AI
Nvidia GB300 相比 H100 在智能体推理任务上的能力提升达 25 倍,远超 8 位 FLOP/s 的 2.5 倍增长。IPI 指数通过比较芯片在多种输出速度要求下能同时处理的请求数量来衡量推理能力,GB300 设为基准值 1,得分为 1 的芯片能同等条件下服务两倍用户。IPI 版本 1 结合四款代表性模型结果,采用 GB300 当作参考基准。
 Codex releases00
GitHub Copilot 发布 0.169.0-alpha.6 版本,该版本未提供具体更新内容。
 Comfy Blog6565
ComfyUI v0.44 引入了多项质量提升功能,包括新增的 Branch Node 和 Stack LoRAs Node,简化了模型选择和堆叠流程。模板和模型现在可以自动下载示例输入,方便用户直接运行。此外,新增的导出功能允许用户一次性下载多个输出文件,提高工作效率。
 MarkTechPost6767
百度发布 ERNIE Evolve 自动化研究系统,通过给定代码库、目标和评估标准自动选择研究方向、编辑代码并运行实验,仅保留通过隐藏评估器和独立审查者验证的更改。
MarkTechPost同一件事 · 4 家6767Google 发布 TPU 8i Max 和 TPU 8tx,TPU 8i Max 将 2 个 TPU 8i 芯片整合为 1 个包装,性能翻倍;TPU 8tx 采用 TPU 8t 芯片搭配第 5 代 AMD EPYC 主机,实现机密推理,延迟降低 2 倍。
各家口径不同:MarkTechPost 表示 TPU 8tx 使用 TPU 8t 芯片搭配第 5 代 AMD EPYC,而 TechCrunch 提到它是与 AMD 合作开发,专为机密训练和运行 AI 模型设计,硬件层直接集成安全功能。
 Meta Engineering3838
LLDB 通过 lldb-server 的中立加速器插件架构支持跨 CPU 和 GPU 的应用调试,将通用调试基础设施与硬件特定设备控制分离,将 CPU 和 GPU 呈现为独立的调试进程,在单一调试会话中协同工作。该架构通过插件将硬件特定调试 API 转换为 LLDB 理解的概念,支持不同架构、寄存器、内存空间和执行模型的 CPU 与 GPU 协同调试,同时保持客户端的中立性。
 Databricks Blog4040
Databricks 发布 Unity Catalog Dataset (UCDataset) Beta 版本,通过直接从云存储流式传输 Unity Catalog 表格数据到训练作业中的每个 GPU,将推荐模型工作负载的训练时间平均缩短 10 倍。
 量子位精选7272
百度文心首次披露自动研究系统 ERNIE Evolve,该系统可自主提出研究方向、开展实验并验证结果,已用于文心 5.5 Flash 的推理优化。在昆仑芯 P800 低时延场景优化中,ERNIE Evolve 历时约 168 小时、经过 4 轮方向探索,最优版本生成速度提升至基线的 623.6%;确定性推理吞吐优化用 3 天将吞吐提升至基线的 133.7%。
推荐理由: 百度公开了自动研究系统 ERNIE Evolve 的架构与生产环境优化数据,可观察 RSI 在推理优化上的实际落点。
Hugging Face Daily Papers3434LowRAM 通过低秩分解压缩键,并使用小头网络根据键预测值,同时保留最难重建标记的残差校正,实现 4 倍值缓存压缩且性能近乎无损。选择性重建可使 262K 上下文在 4 倍 KV 压缩下峰值解码吞吐量提升 5 倍。结合量化和驱逐,LowRAM 将压缩推至 26.9 倍,同时保留 94.5% 的基线性能。
The Decoder同一件事 · 4 家5858Google 发布 TPU 8tx 和 TPU 8i Max 两种新系统,分别面向机密计算和高内存需求应用,年内共交付四种 TPU 系统。新系统基于现有芯片,通过不同封装、网络和内存配置实现快速迭代。TPU 8tx 数据在处理时保持加密,TPU 8i Max 在单机架内将计算能力、内存和带宽翻倍,每平方米数据中心空间性能显著提升。
各家口径不同:MarkTechPost 表示 TPU 8tx 使用 TPU 8t 芯片搭配第 5 代 AMD EPYC,而 TechCrunch 提到它是与 AMD 合作开发,专为机密训练和运行 AI 模型设计,硬件层直接集成安全功能。
 IT之家 · AI同一件事 · 4 家6767
谷歌推出 TPU 8tx 和 TPU 8i Max 两款新品,分别针对机密计算和超长上下文窗口 AI 应用,旨在挑战英伟达在 AI 芯片市场的地位。TPU 8tx 与 AMD 芯片协同工作,TPU 8i Max 集成两颗芯片提供更强计算能力,两款产品预计明年上市。
各家口径不同:MarkTechPost 表示 TPU 8tx 使用 TPU 8t 芯片搭配第 5 代 AMD EPYC,而 TechCrunch 提到它是与 AMD 合作开发,专为机密训练和运行 AI 模型设计,硬件层直接集成安全功能。
 36氪 · AI5858
谷歌推出两款全新版本张量处理单元(TPU)芯片,向英伟达发起竞争。新款芯片可满足机密计算需求,适配行业转向AI智能体的大趋势。四款TPU产品分别适配不同需求,谷歌芯片部门迭代提速。
 Hugging Face Blog4545
HOPE 方法通过考虑专家间的二阶交互,在混合专家语言模型中实现了更优的剪枝效果,50%剪枝率下在 agentic coding 任务上比次优方法提升 6.1%。该方法基于 Qwen3.5-122B 等模型验证,每个 MoE 层有 256 个专家,剪枝后可减少约 250 GB 内存占用,且与量化兼容。
Hugging Face Daily Papers3434P²-MOPD通过将每个学生模块表示为其自身可学习权重与冻结专家任务向量(专家减去基础模型)的加权求和,联合训练权重和混合系数α,使专家成为参数先验,显著加速多教师策略蒸馏。
MarkTechPost5858Reason Machines 发布开源 Git 服务器 Aspen,专为处理数百个 AI 智能体同时推送的仓库设计,独立实现 OpenAI Pando 的设计,单 8 核服务器持续 567 推送/秒,p99 推送延迟 314 毫秒。
Hugging Face Daily Papers3131智能体进化通过递归自我改进(RSI)提升性能而不更新模型权重,但高基准分数并不总带来可靠、高效和可迁移的改进。研究评估了四种方法在通用和编码任务上的表现,发现所有十六个进化智能体都获得了新任务能力但丢失了部分旧能力,其中一种通用任务智能体可靠性提升5.2点但丢失了十个旧任务。EvoAudit通过分析、变异和门控机制实现了最佳性能。
量子位4747基元律动发布Agent原生模型NeoHorse-1.5-Flash Preview,基于Qwen3.8-Flash训练,180B总参数、6B激活参数,在Agents’ Last Exam、Natural Language to Repository等评测中得分提升。该模型通过递归自我改进(RSI)迭代,结合OpenSquilla平台实现多模型差分诊断与在线学习,现开放限量内测。
 Hacker News · AI 热帖6565
使用 Claude Code 或 Codex 从终端工作时,用户常因任务多线程处理导致脑力耗竭。作者通过将工作组织成类似优先队列的方式,在 git 中管理任务,每项任务为 markdown 文件,状态为 git 快照。AI 智能体按循环处理新任务、运行测试和浏览器检查,但无法做决策,需用户在“所有者收件箱”中处理,并通过 Claude 工具单页查看任务,完成后再关闭,实现一次处理一项任务。
Codex releases00GitHub Copilot rust-v0.169.0-alpha.4 发布,该版本包含最新功能改进和修复。
 NVIDIA Newsroom3232
NVIDIA 发布针对韩国领先开源模型的 Dynamo 优化部署方案,支持 SK Telecom A.X K2、LG AI Research K-EXAONE 2.0、Upstage Solar Open 2 和 Motif Technologies Motif-3,通过优化多 GPU 协调和通信实现高达 2 倍性能提升,加速模型生产化部署。
 MIT News · AI3838
由麻省理工学院和纽约大学研究人员开发的FLEX平台使机器人能够从自然语言指令中推断深层含义,提升运动规划能力。该平台通过GPT-4o分析指令模式,让机器人在虚拟场景中避开笔记本电脑和手机等电子设备,无需明确指示。整个过程耗时约五秒,旨在让机器人理解人类指令背后的潜在意图。
MIT News · AI5252WorldParticle 模型能模拟从滑动的沙子到折叠的蛋白质等多种物质行为,通过将物体分解为数千或数百万个三维粒子并使用神经网络预测其运动,无需为每种物质和过程编写特定方程。该模型在模拟可变形物体、颗粒材料和蛋白质等方面比数值模拟方法精度更高,并可通过合并技术优化计算效率。