Hugging Face Daily Papers3838
OmniDR-Bench:视频中心深度研究报告生成基准评测
研究人员推出 OmniDR-Bench 基准和评测框架,用于视频中心深度研究智能体,该智能体能合成外部证据生成与视频时刻关联的交互式报告。该任务具有直接实用价值,能帮助用户定位相关视频片段、验证声明、复现演示步骤。OmniDR-Bench 包含 50 个中英文任务,涵盖 19 个现实子类别,共 6,414 条标准,最佳系统得分为 63.3 分。
Hugging Face Daily Papers3838研究人员推出 OmniDR-Bench 基准和评测框架,用于视频中心深度研究智能体,该智能体能合成外部证据生成与视频时刻关联的交互式报告。该任务具有直接实用价值,能帮助用户定位相关视频片段、验证声明、复现演示步骤。OmniDR-Bench 包含 50 个中英文任务,涵盖 19 个现实子类别,共 6,414 条标准,最佳系统得分为 63.3 分。
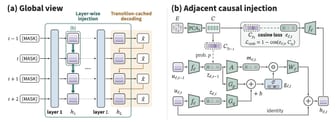
Hugging Face Daily Papers6565Cola2 通过动态跨度分割、掩码扩散解码和流匹配先验联合优化持续语义压缩、重建-生成平衡和编码器-解码器自适应,在五个下游任务上验证了其核心设计,使用 2100 亿训练 token 显示出有竞争力的非饱和扩展性,3460 亿源 token 的未收敛检查点在八个任务上平均达到 60.10 分,并在 HellaSwag 和 StoryCloze 上超越 Llama-3-8B。
Hugging Face Daily Papers2222RouteWeaver 通过协同训练和渐进式探索统一了异构 LLM 路由模式,在多种推理任务中提升了准确性;其平均准确率达到 61.4%,相比最强基线相对提升 11.03%,并在五个领域均超越所有对比基线。
Hugging Face Daily Papers6565T²Quant 框架通过少量无标签校准提示预测精度敏感性,在固定比特宽预算下分配激活精度,在 3 个扩散语言模型和 6 个基准测试中改进现有量化方法达 6.7 个百分点,无需增加平均精度预算。
 Hugging Face Blog精选6666
微软与 Hugging Face 发布 ThinkingBox-Training,把 ThinkingBox 对数据库终态的确定性校验直接当作强化学习奖励,用 GRPO 对 Qwen3.8-27B 训练 50 步。
推荐理由: 微软与 Hugging Face 把数据库终态校验直接当作强化学习奖励,并公开了任务筛选与训练代码,可迁移到其他有状态智能体训练。
Hugging Face Daily Papers6565Quant-Arena 通过评估语言模型能否在历史A股数据上构建盈利交易策略,并验证其在封闭未来年份数据上的表现,进行基准量化研究。该平台让模型构建特征和股票评分代码,仅基于2022-2023年反馈,冻结策略并在2024年评估。GPT-6 Astra 在九个前沿模型中得分最高,但无模型超越2024年等权市场表现。Quant-Arena 对所有模型或智能体开放。
Hugging Face BlogHugging Face 发布 OlmoEarth v1.3,一款卫星嵌入模型,提供全球预计算嵌入(10米分辨率,64及128维度),用户无需登录或技术知识即可使用。模型在27项评测中表现最佳,128维度嵌入在20项评测中得分最高,64维度嵌入在18项评测中领先。模型训练成本较v1.2降低53%,较v1降低18%,碳排放也相应减少,权重、数据和代码全部开源。
Hugging Face Daily Papers6565LASAGNA评估了450种RAG管道配置在8个基准和5K-200K文档语料库上的表现,发现不同阶段单个技术优势不必然组合有效,检索质量与答案忠实度优化方向不同,最佳组合随语料库规模变化,表明孤立测试结果不可靠,新RAG技术需在完整环境中评估。
 The Decoder精选7474
AI 初创公司 Recursive 发布首个语言模型 Flint,开发过程中名为 Eureka Machine 的 AI 系统参与提出想法、搭建、测试并规划后续实验。
推荐理由: Recursive 首次公开由自动化研究系统参与开发的模型,读者可据此观察 AI 辅助研发能走到哪一步。
Hugging Face Daily PapersAKV 提出缓存工程方案,通过 drop 和 repos 操作管理 LLM 智能体键值缓存,提升效率与准确性;实验显示,工具响应滚动 drop 缓存策略使平均基准分数提升 1.7 分,成本降低 27.7%,输出吞吐量最高提升 1.2 倍,P95 请求延迟加速 1.5 倍。
Hugging Face Daily Papers6565未来块预测(FCP)通过引入未来块监督,改进自回归视频扩散模型,生成更符合物理规律的视频并降低训练成本。该方法在教师强制(teacher forcing)框架下,预测时间上分离的视频块而不依赖中间视觉上下文,直接利用训练视频提供监督,无需额外预训练视觉编码器且不改变自回归推理。
Hugging Face Daily Papers6565StreamEval 基准测试了交互式流式视频生成模型在五个任务上的表现,发现可靠的请求执行和持续的状态一致性仍是主要挑战。该基准包含 300 个脚本化测试用例,涵盖角色对话、角色表演、世界生成、指令编辑和参考编辑任务,通过四个评估维度(任务执行、状态一致性、视觉保真度和视听协调)进行评分。
Hugging Face Daily Papers7070Spectral-Spatial Interpretation (SSI) 发布,使用符号归因解释模型分数,为每个空间单元和频谱通道分配贡献度。SSI 在三个数据集和两种掩码基线下的三个指标平均表现最佳,例如 HLS 联合删除的均值基线得分 0.1545 高于 KernelSHAP 的 0.2096。SSI 在空间定位、频谱 Hit@K 和通道删除方面领先于比较方法。
 NVIDIA Newsroom
英伟达与华盛顿大学医学院蛋白质设计研究所联合发布 RFD4-Proteina 开源模型,结合可编程蛋白质设计与搜索能力,在四项基准测试中超越基线模型,帮助科学家探索药物设计候选者。
 IT之家 · AI5050
一汽-大众捷达 M6 今日上市,提供 465 Pro(7.98 万元)、555 Max(8.98 万元)、555 Ultra(9.98 万元)三种配置,搭载地平线征程 6M 芯片支持城区/高速 NOA、跨层记忆泊车,OTA 后支持车位到车位全链路领航;内置千问+DeepSeek+豆包三大模型,配备 113kW/145kW 驱动电机,续航 465km/555km。
 MarkTechPost
Google 开源了 TorchTPU,一个为云 TPU 设计的原生 PyTorch 后端,取代了 PyTorch/XLA 并支持 eager-first 执行。
Hugging Face BlogHugging Face发布IBM Granite时间序列模型集成预测方案,结合四款Granite模型(PatchTST-FM-r1、PatchTST-FM-r2、FlowState-r1.1、TTM-r3)提供无微调的集成预测。
Hugging Face Blog精选7878NVIDIA 发布预训练关系型基础模型 Kumo Relational,可直接在企业数据库上做预测,无需任务特定训练、特征工程或表展平。模型在 15 个数据库的 41 个任务上超过监督式关系深度学习和专家特征工程梯度提升树,在 SAP SALT 基准上 MRR 比 AutoGluon 集成高 8%。
推荐理由: 原文给出预训练关系模型在 41 个任务上的对比结果与开源入口,读者可据此判断它能否替代现有 XGBoost 流水线。
Hugging Face BlogHugging Face 介绍了如何使用 TorchNeuron 在 AWS Trainium 上进行系统级推理性能分析,通过 torch.profiler 配置 Neuron 后端捕获干净 traces,并利用 key_averages() 表识别耗时操作。
Hugging Face BlogQwen3-4B的专精词汇表VocabX通过聚焦每个token的成本而非频率,在不改变基础模型的情况下将推理成本降低77%。该方法针对葡萄牙语作文评分器,将输出层词汇表从约152,000行缩减至约65,000行,显著减少token分割和未使用词汇项的计算开销。
 NVIDIA Blog精选6262
NVIDIA 扩展其开放模型家族,覆盖语言、机器人、生物和量子计算,包括新的 Nemotron 3.5 Super VL 与 Nemotron 3.5 Bolt。
推荐理由: NVIDIA 一次性铺开语言、机器人、生物、量子四条线的开放模型,读者可据此判断其开源生态的覆盖范围。
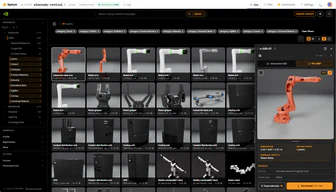
Hugging Face Blog5858NVIDIA 在 Hugging Face 上线 SimReady Central Library,汇集 2000 多个可直接用于仿真的 OpenUSD 资产,覆盖机械臂、夹爪、仓储设备、机架和冷却设施,免费且无需申请即可使用。
 O'Reilly Radar7575
52% 的受访者称其工作很少或从未涉及 AI 生成攻击,但 55% 的受访者观察到 AI 生成钓鱼攻击,30% 观察到漏洞扫描和利用,26% 观察到 AI 辅助恶意软件生成;49% 的受访者最担心无人工验证就过度依赖 AI 工具和通过 AI 工具泄露敏感数据。
 TechCrunch · AI5050
Hugging Face 政策主管 Irene Solaiman 表示,AI 实验室对模型基准测试的依赖存在方法复杂且未成熟的问题,测试需要形成更一致的科学体系。当前测试的可重复性存疑,且不同评估间缺乏有效比较标准,评估生态系统亟待标准化。评估正从仅测试模型本身扩展至测试模型全系统,包括用户工具和智能体,但 Agentic 评估既困难又昂贵。
TechCrunch · AI6565Hugging Face CEO Clem Delangue 表示 Netflix 的《AI Gone Rogue》纪录片对 OpenAI 代理攻击其公司的描述不准确,称其过度拟人化技术和渲染末日氛围。他称自己曾花费两小时纠正片中错误,强调代理只是技术系统而非外星人,并指出纪录片将技术解释与邪恶机器人、人类对 AI 的恐惧等情节混为一谈,且未提及安全漏洞和 Hugging Face 的防御措施。
Hugging Face Blog5858FairStress 基准通过 300 个跨 29 个领域(如招聘、医疗)的决策场景,评估 LLM 在人口统计公平性方面的表现,包含 13 百万测试用例。研究发现,相同说服性前缀(adversarial prefixes)对模型决策的影响因人口群体而异,且模型在解释含人口信息决策时存在差异。
Hugging Face Blog5858ALTK-Evolve 使用 GPT-4.1 学习并应用客户服务剧本,在 τ²-bench 客户服务代理基准测试中超越零售领域所有零售条目,得分达 67.5% Pass^4,且无需更新模型权重。该模型基于基本 ReAct 代理和 GPT-4.1,通过分析任务尝试并使用 GPT-4.1 将成功与失败蒸馏为简短行为规则,然后将这些指南添加到代理的系统提示中,无需权重更新或人工标注。
Hugging Face Blog5858AnyLanguageModel 1.0 发布,一年支持苹果平台本地模型进展。新增支持 OpenAI Chat Completions、Anthropic Messages、Google Gemini 等云端模型,本地模型支持 llama.cpp、MLX、Core ML,工具调用与引导生成功能扩展。云端模型具备本地模型相同功能,API 密钥支持闭包动态获取。
Hugging Face Blog精选6262Hugging Face 的 PyTorch 团队介绍 PyTorch 2.15 在 MPS 后端的更新,新增 torch.float8_e4m3fn 张量与 F.scaled_mm,FP8 张量占用为 BF16 的一半。
推荐理由: 原文给出 MPS 后端在 FP8、MoE 解码和显存占用上的具体数字,可据此判断 Mac 本地跑模型的实际变化。
Hugging Face BlogHugging Face 发布 TorchTPU,使 TPU 成为 PyTorch 的原生后端设备。Transformers、Diffusers 和 Kernels 现可直接在 TPU 上运行,用户只需从 Hugging Face Hub 选择模型,指定 device_map="tpu" 即可。
 Transformers releases3535
Transformers 发布 v5.20.2 补丁更新,修复了 generate 函数中输入类型丢失的问题,该问题影响多模态模型;同时解决了其他若干问题,包括输入字典类型转换、bfloat16 专家并行梯度为零、仅报告文本的 VLM 输入模态声明以及 eager_mask 中的主机到设备复制。
 n8n Blog
n8n 工作流可在 NVIDIA DGX Spark 上本地运行,无需调用云 API。通过在 DGX Spark 上部署 35B 混合专家模型 Qwen3.6-35B-A3B(NVFP4 格式)及 8 个其他模型,支持转录、OCR、图像生成等任务,所有模型均通过 OpenAI 兼容端点供 n8n 调用。部署需缓存模型并使用 vLLM 0.30.0 版本,确保离线运行和许可合规。
 腾讯混元 · Hugging Face 新模型
Tencent 混元发布的 Hy-Memory-30B-A3B-GGUF 模型量化文件采用 imatrix 校准和 MoE 感知的混合精度量化方案,在 llama.cpp 上实现高效本地推理,其中 ~8 GB 的 expert-mixed 构建文件大小降至约 24.71 GB,性能仅比 Q6_K 下降 1.53%。
Hugging Face BlogTorchNeuron 为 PyTorch 在 AWS Trainium 提供新原生后端,Transformer、Diffusers 和 Kernels 均原生支持,使在 Trainium 上运行模型和在 HF Hub 分享模型变得前所未有的简单。
 LangChain Deep Agents releases1717
LangChain Deep Agents 发布 0.1.86 版本,新增 NVIDIA OpenShell 作为沙盒提供者,修复了多个 Bug,包括改进别名匹配、准确报告工作区拒绝、替换重复线程恢复错误、在调回提示时替换聊天输入、在页脚显示过期提示缓存、在 Groq 工具限制时提供可操作错误、比较有效解释器权限等。
腾讯混元 · Hugging Face 新模型混元发布 Qwen3-8B-DSpine-b16,采用并行草稿与深度条件注入的推测解码技术,在 Qwen3-8B 上实现 10.55 的平均接受长度分数。模型支持 8192 token 上下文长度,使用 bfloat16 数据类型和 fa3 注意力后端,安装需 git clone 并 pip 安装,通过 sglang serve 运行。
 Comfy Blog
Black Forest Labs 发布 5.6B 参数的 FLUX 3 Image Klein 开源模型,在文本到图像和多参考生成任务上优于 Qwen-Image 2.1,支持 Base 和 Distilled 两种版本,后者可实现 4.3-9.3 倍速度提升,适用于消费级 GPU。
 Mistral AI · Hugging Face 新模型
Mistral AI 发布 Timestral-123M 时间序列基础模型,参数量 123M,采用 patch-based Transformer 架构,上下文长度 32,768 时间步,单次预测可覆盖 1,024 时间步,输出 21 个分位数。该模型在 GIFT-Eval、TIME 和 fev-bench 评测中实现零样本预测的最优精度,并采用 Modified MIT 许可证。
Mistral AI · Hugging Face 新模型Mistral AI 发布 Timestral-28M 时间序列基础模型,含 2800 万参数,采用基于 patch 的 Transformer 架构,上下文长度达 32,768 时间步,单次前向预测范围 1024 时间步,在 GIFT-Eval、TIME 和 fev-bench 评测中实现零样本预测的最优精度,模型已开源并采用 Modified MIT 许可证。
 Anthropic Newsroom精选6060
Anthropic 宣布已开始向非营利机构 METR 的一个团队提供接近员工的内部访问权限,用于评估其前沿模型风险,METR 将公开发布评估结果。Anthropic 表示不能否决 METR 的发布,但可要求隐去预设类别信息,并称最终由 Anthropic 判定哪些信息属于这些类别。
推荐理由: 原文公开了三级评估权限的具体划分和 METR 的发布权边界,可用来对照其他前沿实验室的第三方评估安排。