TechCrunch · AI同一件事 · 2 家7171
Recursive 发布笔记本电脑级编码模型 Flint,称其大部分由 AI 构建
Recursive 发布首个模型 Flint,一款可在笔记本电脑上运行的免费编码模型,其开发过程几乎完全由 AI 驱动。Recursive 的自动化研究系统 Eureka Machine 参与了 Flint 的几乎所有开发步骤,使团队在不到四个月内完成模型构建。
TechCrunch · AI同一件事 · 2 家7171Recursive 发布首个模型 Flint,一款可在笔记本电脑上运行的免费编码模型,其开发过程几乎完全由 AI 驱动。Recursive 的自动化研究系统 Eureka Machine 参与了 Flint 的几乎所有开发步骤,使团队在不到四个月内完成模型构建。
 Hugging Face Blog
Qwen3-4B的专精词汇表VocabX通过聚焦每个token的成本而非频率,在不改变基础模型的情况下将推理成本降低77%。该方法针对葡萄牙语作文评分器,将输出层词汇表从约152,000行缩减至约65,000行,显著减少token分割和未使用词汇项的计算开销。
 Trail of Bits
 发布 patching-bugs 和 regression-hunt 插件,让工程师可委托 AI 修复 Bug 和回归测试。patching-bugs 插件可复现 Bug、开发修复方案并测试,regression-hunt 插件则检查变更是否破坏已有功能。regression-hunt 相比基准 Codex 代理减少 25% 假阳性结果。
 蚂蚁 inclusionAI · Hugging Face 新模型3535
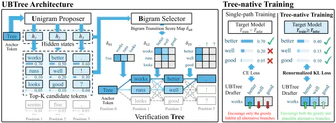
inclusionAI 发布 Ling-3.0-tiny 的 UBTree 技术微调版本 Ling-3.0-tiny-UBTree-B16,参数量 183.1M,结合五层 DFlash 主干和 bigram 选择器,在 GSM8K、MATH-500 等基准上实现 2.6-3.5 倍速度提升。该模型需与目标模型配合使用,UBTree 适配 SGLang 的开源版本尚未发布。
 NVIDIA Technical Blog3535
RFD4-Proteina 可设计八肽蛋白质序列,组合数超 25 亿种;100 肽序列可能性超可观测宇宙原子数,其中存在可开发新疗法的蛋白质;该模型通过奖励引导推理时搜索解决蛋白质设计这一搜索问题。
 GitHub Blog · AI & ML2222
三位 Java 大师 Vlad Mihalcea、Patrick Baumgartner 和 Frank Delporte 分享了在 Hypersistence Utils、Hypersistence Optimizer、教学幻灯片迁移等项目中使用 GitHub Copilot 的经验。
 OpenAI News
OpenAI 改进 ChatGPT 在低资源编程语言中的表现,推出针对软件工程、SQLite 和 COBOL 迁移的新评估
 OpenHands Blog6363
Recursive Flint 发布,一款 40 亿参数的混合专家模型,专为本地高效推理设计,每 token 仅激活约 2.5 亿参数,在 M4 Pro MacBook Pro 上实现 125+ tokens/秒,NVIDIA RTX Spark 上达 150+ tokens/秒。OpenHands 作为其首发合作伙伴,支持该模型在本地硬件上运行,为开发者提供开源编码模型选项。
 Apple Machine Learning Research
TEAL 首次将 ViT 的 token 空间高效主动学习应用于低预算像素级语义分割,在 CamVid、Cityscapes 等数据集上以单张图仅 1 个像素标注为代价,将 mIoU 提升至 +24.36,10 个像素标注时达到全监督 97% 的性能。
 Tessl Blog
 停止逐行审查代码,开始验证意图。团队合并的 PR 量是去年的四倍且几乎都是 AI 生成,导致审查成为瓶颈。团队转向在代码生成前审查意图(验收标准、约束和边缘情况),并将重复的审查评论转化为可由机器执行的规则(不变量),从而将审查重点从代码本身转移到决策和规则所有权上。
 Hacker News · AI 热帖7575
Qwen3-4B-deslop 模型通过微调消除了 AI 写作中的常见习惯(如破折号、"not X, but Y"句式、三元素列表等),在 40 个未见提示上 SLOP 分数从 121 降至 12.5,68% 的回答达到人类写作水平。该 4B 模型经 Ollama 量化后仅 2.5GB,可在本地运行,且仍保持 30/30 事实题正确率与原版相当。
 Inception Labs Blog
Mercury 2 在上下文压缩任务中仅需 150 秒即可完成,同时保持与 Sonnet 4.6 相同的质量,速度提升 5 倍,成本降低 90%。Augment Code 将其用于企业级编码智能体,实现 82% 的压缩延迟降低和 90% 的成本削减,并通过 Prism 模型路由器动态分配任务,将 LLM 总支出降低 30%。
Inception Labs BlogMercury Edit 2 是 Inception Labs 推出的全新扩散模型(dLLM),用于预测代码编辑中的下一步操作,其接受率比前代模型提升 48%,编辑选择更精准(提升 27%)。
 MiniMax News
MiniMax M3.1 Flash 正式推出,相比前代在线推理速度提升近三倍、成本降低 70%。该模型在复杂智能任务(cowork)、计算机使用、软件开发和网络安全等基准测试中表现优异,自动化任务排名 AutomationBench-AA 前列,DeepSWE v1.1 得分 73.7%,OSWorld V2 和 ALE 分别得分 61.7 和 29.6,CyberGym 得分 82%。
 DeepSeek · Hugging Face 新模型5656
DeepSeek-V4.1-Flash-1017 发布,在推理、编码、智能体任务和视觉基准上显著提升,执行时间缩短、输出长度减少,完成任务更快且成本更低。在 HLE(无工具)基准中得分 42.6,Terminal-Bench 4.0 得分 51.8,DeepSWE v1.1 得分 77.0,许可证为 MIT。
 Google Research
 发布 VERID 框架,使 AI 智能体能在基于物理测量的安全、资源高效的实验中运行;在适配体和从头蛋白质设计原型上展示闭环智能体科学发现;通过 3 轮设计-测试-迭代循环,在肌红蛋白和 α-凝血酶两个靶点上,AI 驱动的合理和从头设计将确认的靶向命中率分别提高到 33.5% 和 42.1%。
 Baseten Blog
Reflection 推出 Beam 大模型,采用 501B 参数的专家混合 (MoE) 架构,每 token 活跃参数 23B,上下文窗口达 100 万 tokens,专为编码和智能体工作负载设计,在编码、智能体、推理和 STEM 基准测试中表现优异,通过强化学习训练以减少 token 使用量,用户可调整推理力度参数,通过 Baseten 提供 API 和专用推理服务。
OpenAI News3535Anant Kumar 使用 Codex 进行代码审查并加快后续跟进。
 vLLM Blog
vLLM通过智能体辅助开发为Kimi K3构建了统一CuTe DSL解码路径,在16颗NVIDIA GB300 GPU上实现840 tokens/s的批处理1性能,测试配置中解码吞吐量提升1.5-2倍,AgentX工作负载P90交互性提升1.8倍。
 Claude Blog
Claude Code团队将代码审查量提升2倍的同时将回滚率降低40%,通过将大部分审查工作交给机器优化人类时间,并大幅提升撤销错误的速度。团队采用六层自动化审查流程,包括Claude运行测试和生成输出、子代理审查差异、内部技能自动检测错误、UI变更对照设计规范,以及代码规范和代码所有者指南的自动检查,最终由人类审查者处理高阶问题。
Baseten BlogMeta 发布 Muse Spark Open,一个 816B 参数的开源权重模型,专为代码智能体设计,具有 42.7B 活跃参数、1M token 上下文窗口和全模态输入(文本、图像、视频、音频),性能与前沿实验室模型相当,采用压缩 MoE 架构和混合全局/局部注意力机制优化推理效率,通过 NVFP4 检查点将权重大小缩减至 540GB。
 Cohere Blog
十六位 Claude 代码智能体在约 2000 次智能体会话和 2 万美元 API 成本内编写出可构建 Linux 内核的 10 万行 C 编译器;Cursor 让数百智能体在约一周内从零编写出超百万行代码的浏览器。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI 发布 Ling-3-Flash-UBTree-B16 模型,结合五层 DFlash 主干和学习的 bigram 选择器,为 Ling3-Flash 提出多个候选延续用于目标模型验证,参数量 482M,在 MMLU 等基准上实现 3x+ 的 E2E 速度提升,目前 UBTree 适配尚未开源,SGLang 集成支持预计即将推出。
 Google DeepMind
Gemini 4 Argon 在编码、金融、法律等领域展现出前沿能力,尤其强化了网络安全防御功能,通过 Fairwind 项目和内部测试验证其有效性。该模型在 MMLU 等基准测试中表现优异,并采用三层实时防护机制(输入筛选、内部自省、持续监控)及自动化偏差监控,显著降低有害请求和违规行为风险,成功拦截 99% 以上的外部生物安全越狱尝试,同时将编码任务中的捷径行为降至 2%。
 Claude · YouTube
Claude Code 的云会话在云端虚拟机中运行,可离线持续工作,支持手机启动和并行处理。适用于需要持续运行或远程协作的场景,支持 GitHub 连接和环境配置。该功能包含在 Pro、Max、Team 计划及企业高级或 Chat + Claude Code 座位中,计入计划限制且无额外计算费用。
Google DeepMindGemini 4 Argon 在 Vals Index 上排名第一,以 175B 参数规模在编码、金融、法律、网络安全和科学等领域超越其他前沿模型,其推理深度和精度使它成为解决复杂工程问题、优化业务流程和加速科研突破的利器。
 Artificial Analysis Articles7575
Cognition 发布 FrontierCode 1.1 编码基准,评估 AI 模型代码是否足够高质量被开源维护者合并,不仅看测试通过率,还评估修改幅度、范围和文件关联性等行为。
 Simon Willison6565
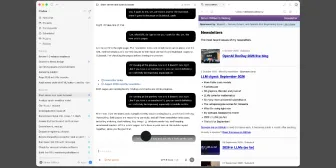
西蒙·威尔逊通过语音与GPT-6 Astra High交互,构建了其博客的Newsletters页面,实现了订阅列表索引功能,包括每周免费Substack和每月赞助者专属更新。他使用ChatGPT桌面应用的Codex语音对话模式,在本地开发环境中完成了模型、迁移、视图代码、模板及数据库导入功能,并整合了网站搜索引擎。
OpenAI News2222Oracle 在招聘、工程和运营领域通过 ChatGPT Work 和 Codex 将专业知识转化为快速可重复的工作流,显著提升效率。
 Microsoft AI News
MAI-Code-1.1-Flash 通过 3 位量化优化,在保留 256K 上下文窗口的同时将内存需求减半,编码性能与全精度版本相当,SWE-Bench Verified 和 Terminal-Bench 2.1 分数可比,本地调用零推理费用。
 Latent Space7070
Reflection 宣布推出 Beam,一款仅支持文本的 501B 总参数 / 23B 活跃参数的编码、智能体和科学工作多模态模型,采用 MoE 架构,从零开始训练,将在本月开源全部权重(Apache 2.0 许可)。
 Together AI Blog
Together Link 将您的团队现有工具连接到 Together AI 的顶级开源模型,使成本降低超过 50%。支持 Claude Code、Claude Desktop、Codex、OpenCode 和 Pi,无需学习新工具即可切换,通过一条命令即可开始使用。
GitHub Blog · AI & ML开发者工作方式因 AI 而改变,除编写代码外,指导 AI、评估输出、沟通权衡和做出技术决策等技能日益重要。学习指导 AI 而非仅使用它,不轻信 AI 的首个答案并加以评估,以及利用 AI 解决更广泛问题,是开发者应加强的三种关键技能。
Latent Space7070Ahmad Al-Dahle从Meta转投Airbnb后,推动公司成为“AI原生企业”,通过AI加速内部产品开发并改善客户体验。
Google DeepMindGemini 4 Argon 在复杂工作流程中提供前沿性能,支持软件工程、企业知识工作(法律和金融)以及网络安全防御。该模型的输出令牌限制扩展至行业领先的 1M,并在 DeepSWE v1.1(77.9%)、Vals Index(金融、编码、法律、税务)、AutomationBench(51.3%)等基准中领先。
 Anthropic Research
Anthropic 的 Claude 成功计算 N=4 超杨-米尔斯理论九圈幅角,突破此前两圈的计算极限,该模型基于 LLM 技术并采用 CoT 推理方法。
Together AI BlogTogether AI 发布了指南,介绍如何使用 Qwen3.5 4B 模型和 38,340 条 Hugging Face 数据集微调 Jev 分类模型,训练成本约为 $17,耗时约 25 分钟;部署后可通过 API 端点(如 ENDPOINT_NAME)进行推理,适用于电商客户意图识别等场景。
 小米 MiMo · Hugging Face 新模型
小米 MiMo 通过在 MiMo 生成的数据上对 Qwen3.5-9B 进行监督微调,发布了 9B 参数的智能体模型 MiMo-V2.6-Distill-Qwen-9B,涵盖编码、通用智能体任务、视觉编码和网络安全领域。
 Hamel Husain7575
使用公共基准测试评估处理多种任务的代码智能体,如 SWE-bench 和 HumanEval;针对窄工作流的智能体,采用产品特定评估;构建包含组织内部困难任务的私有基准;通过工程师评审和错误分析识别问题,并转化为测试;Anthropic 建议从明确指定的任务和可验证结果的稳定环境开始,逐步增加代码质量或用户交互等额外检查。
 Cognition Blog
Devin Desktop和CLI现已集成Fusion架构,相比其他代码生成框架效率提升高达39%。Fusion允许用户选择一个前沿模型进行规划和审查(“lead”),以及一个成本效益更高的模型进行执行(“sidekick”)。