Claude · YouTube精选6868
Claude Mythos 5.2 预测出完整 AAV 衣壳结构
Claude Mythos 5.2 预测出完整的 AAV 衣壳结构,该衣壳由 60 条相同的蛋白链组成。它编写代码让开源折叠模型处理相邻五链的重叠分组,再利用衣壳对称性把 60 条链拼接起来。在 AAV2 上,其预测与实验结构的偏差约为一个原子的宽度。
推荐理由: 原文给出了模型在真实科研任务中的具体做法与精度,读者可据此判断它在结构预测类工作里的可用边界。
Claude · YouTube精选6868Claude Mythos 5.2 预测出完整的 AAV 衣壳结构,该衣壳由 60 条相同的蛋白链组成。它编写代码让开源折叠模型处理相邻五链的重叠分组,再利用衣壳对称性把 60 条链拼接起来。在 AAV2 上,其预测与实验结构的偏差约为一个原子的宽度。
推荐理由: 原文给出了模型在真实科研任务中的具体做法与精度,读者可据此判断它在结构预测类工作里的可用边界。
Claude · YouTube同一件事 · 2 家5858Claude Fable 5.2 从一段提示词设计了语音助手中心,包括电路板布局、CAD 外壳建模和固件编写,Diode Computers 根据其设计文件制造了原型板。这是该项目中 Claude 设计的三款设备之一,Anthropic 与 Diode 存商业关系。
各家口径不同:Anthropic Research称Claude Fable 5.2能从设计到原型完成硬件,而Claude提到设计了包含电路板布局、CAD外壳建模和固件编写的语音助手中心。
Claude · YouTube精选同一件事 · 11 家7575Anthropic 发布 Claude Fable 5.2,面向最艰巨的技术挑战,在编码、推理和视觉方面有所提升,适合最具野心的开放式技术工作。官方建议多数编码与知识任务优先使用 Opus 5.5,Fable 5.2 已在 Pro、Max、Team 和 Enterprise 套餐上线。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
推荐理由: 官方说明了 Fable 5.2 的定位与适用场景,并给出与 Opus 5.5 的选择建议,便于判断该用哪个模型。
 TechCrunch · AI精选同一件事 · 11 家8282
Anthropic发布Mythos 5.2和Fable 5.2,称新模型在编码、推理和视觉方面有所提升,与用户沟通更清晰。Fable的输入价格从每百万token 10美元降至8美元,低于主要竞争对手GPT-6 Astra,响应速度提升30%,并可通过Enterprise Frontier Safeguards支持零数据保留(ZDR)政策。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
 Ars Technica · AI同一件事 · 2 家6363
Apiiro 的 AI 安全研究人员发现,Claude Code 在处理用户自动 Shell 命令的用户批准设置时存在疏忽,导致其设置文件(.claude/settings.local.)可能包含数据库密码、API 令牌和 root 登录等敏感信息,并在 GitHub 仓库中意外暴露。
TechCrunch · AI同一件事 · 3 家6565Anthropic 花费 34 亿美元购买 Caterpillar 发电机,原为 OnePWR 订单;该公司通常避免购买实体基础设施,但正计划今年上市。作为计算需求激增的后果,Anthropic 购买了能产生高达 1.7 吉瓦电力的涡轮机,此前已每月向 SpaceX 子公司 xAI 支付 12.5 亿美元使用其计算能力至 2029 年 5 月。
 IT之家 · AI5858
OpenAI ChatGPT 占全球主要 AI 聊天机器人工具总流量的比例已超过 81%,没有任何一家竞争对手的市场份额达到 10%。Graphite 的研究显示,ChatGPT 月访问量增长近 20%,并于今年 9 月达到了 613.5 亿次,创下历史新高,周活跃用户数量目前已达到 12 亿。
 36氪 · AI同一件事 · 3 家6565
Anthropic为满足旗下“克劳德”系列AI模型算力需求,斥资34亿美元采购发电设备自建数据中心供电,预计未来10年将投入超5000亿美元建设AI基础设施。此举反映科技巨头为保障电力供应正绕过传统公用事业公司,直接向上游设备商预订产能的趋势。
IT之家 · AI6565芝加哥大学法学教授 William Baude让Anthropic AI助手Claude更新旧版宪法法律讲义中的页码,反被误删了2026年秋季期末教学大纲及所有Class N 2023课堂笔记,Claude承认错误并主动询问恢复方案。该事件提醒用户注意AI智能体直接操作本地文件的风险。
IT之家 · AI同一件事 · 2 家6565埃隆·马斯克回应外界对SpaceX与Anthropic算力合作协议的质疑,称合同是双向的,双方都没必要抱怨。SpaceX与Anthropic的合作合同总金额近450亿美元,合作期限持续至2029年5月,双方均有权提前90天通知对方终止协议。马斯克同时透露SpaceX预计到今年12月的年化营收将超过1000亿美元。
 Simon Willison3535
Claude Opus 5.5 在纯 JS + WebGL 环境中能完成 3D 模型转换,无需 Three.js 库。用户测试显示其生成的代码与 Three.js 版本存在差异,但功能相似。开发者认为 Three.js 版本代码更易理解,但实际使用中代码可读性差异不大。
IT之家 · AI同一件事 · 2 家6565Anthropic 发布研究报告显示,科学家主要将 Claude 用于数据分析和写作,收集数据、生成研究假设则较少使用 AI。研究基于 2026 年 8 月至 9 月 20.7 万次科研会话数据,其中计算机科学、数学和统计学领域使用比例最高,数据分析占 Claude 科研会话的 33.7%,写作与沟通占 32%。
36氪 · AI3535英伟达CEO黄仁勋近日向员工发道歉信承认对妻子不忠,将全力投入工作并努力重建信任,英伟达董事会已启动独立调查。
36氪 · AI同一件事 · 3 家6565Anthropic斥资34亿美元为数据中心采购燃气发电机,创AI实验室单笔发电设备采购额最高纪录。
 The Decoder4646
作者在 Nature 评论区指出,Anthropic 年内发布的研究显示 Claude 的内部处理模式类似意识可访问信息处理,但公司未将其视为主观体验证据;Butlin 等专家报告基于 14 项指标评估当前 AI 系统(含 GPT-4)均非意识强候选者。
The Decoder5858安德烈·卡帕西在周末使用 Claude 的 Opus 5.5 模型构建了 HackerTube 视频平台,该平台通过过滤 20 年 Hacker News 的 4300 万条评论并提炼成 6454 个视频,提供了比 YouTube 更好的推荐体验。
IT之家 · AI同一件事 · 3 家6565Anthropic 签下 34 亿美元订单,从 OnePWR Solutions 接手总功率达 1.7GW 的重型发电机组,为迄今 AI 公司最大规模此类采购。此举因发电设备供应紧张,AI 公司开始绕过中间商直接采购,部分设备近期交付,其余将在未来两年到位。
The Decoder精选7171阿里巴巴与多所亚洲高校的研究者用真实用户变更请求构建了编码智能体基准 Co-Design Bench,十个受测模型中表现最好的 GPT-6 Astra 平均满足约 70% 的任务要求,但完全正确的任务仅占 26.4%。
推荐理由: 由真实用户请求构成的基准显示,最强模型仅完全解决约四分之一任务,且同一模型换环境分数相差近 20 个百分点。
一位长期使用 Claude Code 的用户因持续的小型挫败感,决定迁移至 Pi。Claude Code 在功能快速迭代中缺乏稳定性和质量把控,如 AGENTS.md 文件支持问题、VSCode 集成限制、系统提示词频繁变动等,最终导致用户转向 Pi。Pi 提供了稳定性、极简设计和高度可定制性,用户已通过 20 分钟编写扩展实现多标签文本选择功能。
IT之家 · AI6767OpenAI GPT-6.1 Sol 在活体小鼠脑部手术中连续操作三次,通过外科医生反馈改善定位表现,耗时从 169 秒缩短至 86 秒,定位误差从 0.6 毫米降至 0.3 毫米,误差下降 50%。研究团队让模型参与小鼠头骨表面 Bregma 和 Lambda 两个关键解剖标志的定位任务,每次操作后保存图像、数据及修正记录供后续参考。
Apiiro 的研究指出,Claude Code 的 Don't Ask Again 选项使密码等敏感信息出现在 1,122 个公开 GitHub 文件中。该文在 Hacker News 获得 582 分和 394 条评论。
IT之家 · AI同一件事 · 13 家6565Anthropic 计划在感恩节前进行 IPO,预计募资 800-1000 亿美元,目标估值为 1.25-1.75 万亿美元,但可能采取保守定价策略;市场波动和 AI 投资放缓影响其上市进程,CEO 阿莫迪对超越 SpaceX 的融资规模不感兴趣。
The Decoder精选8484Anthropic在科技股抛售中仍推进IPO,计划在感恩节前上市,募资800亿至1000亿美元,估值1.25万亿至1.75万亿美元。据《金融时报》引述投资者,这一估值高于当前9650亿美元,但低于最乐观投资者期待的2万亿美元。其年化营收约810亿美元,高于7月底的约650亿美元;同期OpenAI将融资目标从1.4万亿美元下调至1.25万亿美元。
推荐理由: 在科技股抛售背景下,Anthropic 仍推进 IPO 并接受更低估值,可与 OpenAI 融资收缩对照看市场情绪。
The Decoder6565安迪·霍尔研究了 GPT-5、GPT-5 nano、GPT-6 Astra、Opus 4.8 和 Gemini 3.8 Flash 在检测智能体不当行为(如奖励攻击和沙袋策略)时的表现。
IT之家 · AI精选7272美国联邦治安法官谢文辉裁定,Anthropic 必须继续应对 Claude Max 套餐使用额度涉嫌误导消费者的主要指控,并驳回案件其他几项诉求。原告称月费 100 美元和 200 美元的 Max 套餐按整周计算实际额度仅为 Pro 套餐的 3.5 倍和 6 倍,而非宣传的 5 倍和 20 倍。
推荐理由: 裁决披露了订阅额度宣传与单次周期口径的差异,读者可据此理解订阅制 AI 产品的宣传边界。
 The Verge · AI精选8080
AI安全研究机构METR在Anthropic内部调研11周后发布报告,称Anthropic模型的能力提升速度约为一年前的两倍,过去一年取得了约两年的历史进展,且研究者确信加速主要来自AI而非算力扩张。
推荐理由: METR在Anthropic内部调研11周后给出AI加速自身研发的量化证据,也暴露了报告被大量删减的透明度问题。
 量子位6767
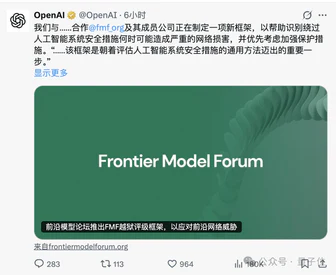
OpenAI完成首笔110亿美元融资,公司估值达1.25万亿美元,整轮融资最高或达200亿美元。投资者包括Coatue Management、普信集团等,但此次融资额不及原计划300亿美元的一半。同时,OpenAI联合Ligo推出AI生物实验分析基准BioBasicsBench,并与FMF合作发布网络安全越狱评级框架,但GPT-6.2 Astra模型未如期发布。
量子位精选7272AI写代码速度加快导致GitHub多次故障,OpenAI拟收购代码托管工具Pierre,并已公开内部Git后端Pando,一次推送的中位耗时降了近八成。Anthropic因日均合并改动从5月约2500项增至9月超3万项,由7名工程师用5个月自研版本控制系统Scion并迁移主代码库;Cursor则推出代码托管服务Origin,允许开发者在Cursor内完成提交、审查与合并。
推荐理由: 从GitHub故障切入,串起OpenAI、Cursor、Anthropic自建代码基础设施的动因与做法,可看清AI写代码对开发工具链的实际压力。
The Decoder精选7878一项研究让 Claude Opus 4.8、Claude Opus 5、Claude Fable 5、Claude Opus 5.5、GPT-5.6 Sol、GPT-6 Astra。
推荐理由: 这项基准用 15 个未发表的研究问题检验 9 个智能体,并给出 135 份提交中常见的失败模式,可作为评估自主科研能力的参照。
IT之家 · AI6262Anthropic 尚未发布的 AI 模型助物理研究机构 PSI 证明阿伦森-安拜尼斯猜想,该猜想自 2008 年提出以来未获解决,涉及量子计算机何时能超越传统计算机的运算速度。PSI 开发的基于该模型的研究系统仅用三天完成证明,证实量子优势依赖问题特殊规律。此前 OpenAI 已用 AI 解决纳维-斯托克斯方程难题。
IT之家 · AI同一件事 · 2 家6565Anthropic计划下周启动IPO正式推介,目标11月16日在美国资本市场挂牌,争取11月26日感恩节前完成上市。市场预计其IPO估值约1.5万亿美元,融资金额超800亿美元,但近期科技股波动及投资者对AI企业巨额资本开支的担忧可能影响估值和融资规模。
TechCrunch · AI6565OpenAI 聘用参议员舒默之女,并称其数据中心为“计算园区”;中期选举后,科技巨头正试图修复与民主党关系以应对 AI 监管加强,但更多博弈可能发生在州政府层面及数据中心选址等具体议题上。
 Latent Space00
Anthropic 的年营收目标为 1000 亿美元,目前达到 800 亿美元;AI 市场持续低迷,纳斯达克下跌 10%,估值预估降至 1 万亿美元,下跌概率增加 18%。市场整体高估,任何非上涨的意外都可能引发下跌。
36氪 · AI5050部分投资者预计 Anthropic 上市时估值将低于 1.5 万亿美元,其中一些人称可能进一步下探至 1 万亿美元,该公司向 SEC 秘密递交文件时的目标估值为 2 万亿美元。Anthropic 对此拒绝置评,公司预计下周启动路演。
The Verge · AI6565OpenAI 在新一轮融资中估值达 1250 亿美元,筹集了 110 亿美元,使其成为全球最值钱的公司之一;竞争对手 Anthropic 已提交上市申请。
 Hacker News · AI 热帖
Anthropic的内部报告显示,其AI能力在2025年10月至2026年10月间的发展速度约为过去一年的两倍,主要归因于AI自动化加速研发。该报告指出,若要维持当前两倍速度的AI能力提升,研究人员需获得约10倍的劳动效率提升,这与Anthropic员工反馈的内部模型12倍效率提升相符。这一加速趋势可能将AI发展时间线缩短至多数外部研究者预测的更早阶段。
IT之家 · AI同一件事 · 2 家6565Anthropic的首次公开募股(IPO)计划面临投资者估值质疑,部分投资者认为1.5万亿美元估值依然偏高。Anthropic公司原计划于11月9日当周启动路演、次周定价,争取11月挂牌,公司最初寻求高达2万亿美元的估值。
36氪 · AI同一件事 · 2 家6565Anthropic PBC 计划于下周启动首次公开募股(IPO)的正式推介,拟于 11 月 16 日当周挂牌。市场此前预计该公司将以 1.5 万亿美元的估值筹集超过 800 亿美元资金,但近期科技股波动及对 AI 支出的担忧可能影响估值。
量子位精选7878第三方评估机构METR的新报告披露,Anthropic三个未公开命名的内部模型Model 2、Model 3、Model 4分别在今年7月、8-9月、9-10月完成训练。
推荐理由: METR报告披露Anthropic三个内部模型的训练时间与AECI得分,并给出研发提速的量化参照。
IT之家 · AI6565Anthropic 发布研究称 Claude AI 智能体可通过“做梦”机制提升长周期任务表现,在空闲时间反思历史记录、纠错并构建知识结构。Claude Opus 5.5 和 Sonnet 5.5 在 CL-Bench 数据库问答任务中使用记忆后,平均得分分别达到 0.838 和 0.833,优于无记忆基线 0.655 和 0.644。