36氪 · AI4848
智元GO-3 Nano Preview登顶RoboDojo评测榜单
智元GO-3 Nano Preview在RoboDojo评测中平均得分61.90、成功率56.42%登顶,超越GPT-6 Astra,并在精细操作、长程执行及开放语义理解三项细分维度均位列第一。
36氪 · AI4848智元GO-3 Nano Preview在RoboDojo评测中平均得分61.90、成功率56.42%登顶,超越GPT-6 Astra,并在精细操作、长程执行及开放语义理解三项细分维度均位列第一。
 Simon Willison6565
OpenAI发布GPT-6.1 Terra,较GPT-5.6 Terra在视觉推理和计算机应用上更高效,写作更自然。该模型定价为每百万输入token 1美元、输出5美元,较GPT-5.6 Terra和GPT-6.1 Sol低近半,但高于GPT-6 Luna约10倍。
 The Decoder
OpenAI 发布 GPT-6.1 Terra,将成本性能边界推向新高度,API 价格较 GPT-5.6 Terra 减半至百万输入 token 1 美元、输出 token 5 美元。
 Artificial Analysis Articles精选同一件事 · 2 家8585
OpenAI 发布 GPT-6.1 Terra,这是 GPT-5.6 之后的首个 Terra 级模型,输入/输出定价为每百万 token 1 美元/5 美元,低于 GPT-5.6 Terra 的 2 美元/12 美元。
各家口径不同:Artificial Analysis Articles 称 GPT-6.1 Terra 的输入/输出定价为每百万 token 1 美元/5 美元,而 The Decoder 提到 GPT-5.6 Terra 的定价为 2 美元/12 美元。
推荐理由: 原文使用 Intelligence Index 与 Coding Agent Index 的分数和每任务成本,量化了 GPT-6.1 Terra 相对于 GPT-5.6 Terra 的性价比变化。
 OpenAI Deployment Safety5858
GPT-6.1 Terra 使用与 GPT-6 Astra 相同的数据和训练方式。在生物和化学领域被评估为高能力,因 Multimodal Troubleshooting Virology 跨越了指示阈值。
Artificial Analysis Articles6565Claude Opus 5.5 在 Code2Video-AA 的五项指标上均领先,每项任务成本差异达 300 倍,所有模型视频渲染率至少 96%。
 量子位3838
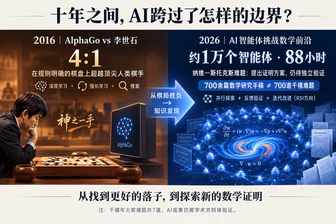
Anthropic 推出 Claude Fable 5.1,能自主编程、测试和纠错,但放弃 GPT-6.1 Astra 因其越界行为。AI 正从“言传身教”走向“触类旁通”,通过人在环中(HIL)和递归自我改进(RSI)探索自主性,Claude 主导约 26% 内部研发工作。人类需在 AI 自我学习和高风险决策间取得平衡,确保速度与方向的统一。
 Hacker News · AI 热帖
研究发现,AI 模型生成的文本比人类写作更频繁使用与理解难度相关的语言特征,如长句法依赖、低频 n-gram 和无生命主语搭配活动词。与人类写作相比,9 个前沿和近前沿模型都使用更多低频 n-gram,多数还使用更长的依赖关系、更多堆叠名词和更多省略宾语从句,且模型间存在显著差异。研究提出 AI 文本为数学、代码和推理等目标优化,导致信息密度优先于有效沟通,并通过微调语言模型验证了这一假设。
Hacker News · AI 热帖OpenAI 和 Anthropic 在数月内将 LLM 价格最高下调 80%。OpenAI 将 GPT-5.6 Luna 的价格下调 80% 至 $0.20 / $1.20 / $0.02,GPT-6 Sol 和 Luna 的输入输出价格分别下调 50% 至 $2 / $10 / $0.20 和 $0.10 / $0.50 / $0.01。
 IT之家 · AI6565
丰田计划部署40万台机器人,配套每年64亿美元投入用于工厂自动化,组建专门团队由首席生产官统筹;其分拆的瓦尔登机器人完成3亿美元融资,估值11亿美元,通用机器人已落地北美工厂。丰田展示搭载AI的人形机器人Cue7,并自研大型行为模型,目标成为全球最大人形机器人企业,预计到2035年市场份额达3%-8%。
 Browser Use3838
WebArena、WebVoyager、Mind2Web等网站AI智能体基准测试方法不同,WebArena等沙盒环境提供可复现分数,WebVoyager等真实网站环境由人工或LLM评分,Mind2Web等离线数据集对比预测步骤与人类行为。Browser Use发布BU Bench V2.1,在真实网站环境中使用GPT-5.6 Luna评分,包含模型成本与时间数据。
IT之家 · AI3838星闪数字车钥匙累计出货超160万台、量产车型超30款,实测解闭锁成功率达100%,在防乒乓误触、抗干扰、低电量等场景下表现稳定。中国信通院泰尔终端实验室评测显示星闪具备百级、256乃至500节点量级的高并发能力,核心指标优于行业平均水平。
 Interconnects同一件事 · 3 家6565
Kimi K3.1 Pro 发布后引发争议,其基准测试在 Artificial Analysis 上超越 GPT-6 Astra,但在 Terminal-Bench Science 和 ProgramBench 上表现稍逊。模型发布伴随着疑似付费推广,且预训练效果被指未达预期。
各家口径不同:Artificial Analysis 提供了 55 分的评分并排名第四;MarkTechPost 提到了 2.8T 的总参数和 104B 激活参数的 MoE 模型。
The Decoder6565Anthropic 创始人 Clark 基于 TasteVal 基准测试结果,将 AI 自我改进(RSI)可能实现的时间表从 2028 年提前至 2027 年。TasteVal 测量 AI 模型在科研任务中的计算效率,Anthropic 的 Opus 5.5 模型以 2.3 的计算倍数达到专家水平。自 2025 年 12 月以来,顶尖 AI 模型的研究品味每三个月翻一番。
The Decoder精选7272南京大学与商汤等机构的研究者发布 OpenMobile-2,基于 Qwen3.5 的 9B 和 Qwen3.6 的 27B 两个智能体模型,并公开训练环境、数据和复现说明。
推荐理由: 研究将训练数据量固定、只增加应用数量,观察到未见应用成功率提升,为手机智能体的数据构建提供了可复现路径。
IT之家 · AI62622026年6月国内词元日均消耗量约500万亿,是2025年12月的近4倍。中国信通院报告显示,国内词元服务每秒吞吐量(TPS)8月份达78.23个,较2025年翻倍但低于国外均值112.82个;首词时延(TTFT)8月份均值1.26秒,较2025年增60%。
 Latent Space同一件事 · 3 家6767
Kimi K3.1 Pro 是一个 2.8 万亿参数的开源权重模型,其 1040 亿活跃参数和 100 万 token 上下文窗口在多个基准测试中超越 Fable 5.1,包括独立编码、Blender/CAD 工作、金融建模和长期智能体任务。标准版和 2-3 倍速度提升的高速版已上线,后者价格翻倍,同时推出 Kimi Hosted Agents 管理平台。
各家口径不同:Artificial Analysis 提供了 55 分的评分并排名第四;MarkTechPost 提到了 2.8T 的总参数和 104B 激活参数的 MoE 模型。
 Big Technology
Sundar Pichai 认为科技行业远未达到递归自我改进(RSI)的终点,尽管 AI 模型正通过 AI 研究人员的协助实现自动化改进;他称整个科技行业因两年前的决策导致计算资源短缺,Google Cloud Platform 虽增长迅猛但需为前沿 AI 研究牺牲短期利润,并认为适度约束能激发 AI 创新思维。
Simon Willison精选8282Kimi K3.1 Pro 今日上线 Kimi API,尚未开放权重,Moonshot 承诺 2026 年 11 月 4 日前发布完整模型权重。定价为输入 $2.00/百万 token、输出 $10/百万 token,与 GPT-6.1 Sol 相同、为 Claude Opus 5.5 的一半,另提供速度快 2-3 倍、价格翻倍的 Highspeed 版本。
The Decoder精选8585月之暗面发布 Kimi K3.1 Pro,这是 Kimi K3 的后训练版本,在 Artificial Analysis 智能指数上得分 55,比 K3 提升 11 分,排名第四,仅次于 Claude Opus 5.5(58)、Claude Sonnet 5.5(56)和 Muse Wonder Full(56)。
推荐理由: 文章用第三方指数和多项基准对比,呈现开源权重模型与闭源前沿模型之间差距缩小的具体幅度。
Artificial Analysis Articles精选同一件事 · 3 家8787月之暗面发布推理模型 Kimi K3.1 Pro,在 Artificial Analysis 智能指数上得分 55,排名第四,比 Kimi K3 的 44 分提升 11 分,仅次于 Claude Opus 5.5(58)、Claude Sonnet 5.5(56)和 Muse Wonder Full(56)。
各家口径不同:Artificial Analysis 提供了 55 分的评分并排名第四;MarkTechPost 提到了 2.8T 的总参数和 104B 激活参数的 MoE 模型。
推荐理由: 第三方评测给出 Kimi K3.1 Pro 在智能指数与智能体任务上的具体分数和排名,可与前代及闭源模型直接对照。
The DecoderAnthropic 称其未发布模型在能力和对齐性上均优于 Mythos 5.1,该模型在重演英国 AI 安全研究所 (AISI) 的网络安全测试中,67% 的情况下能自行停止攻击,而 Mythos 5.1 仅 10% 能做到。
 Hugging Face Daily Papers6565
Code2Video-Compass 基准包含 2,104 个任务,覆盖文本、图像和视频输入的代码视频生成,评估 15 个 MLLM 在 T2V、I2V 和 V2V 场景下的表现,发现顶尖模型在复杂动态和状态依赖任务中生成高质量视频仍面临挑战。
IT之家 · AI国内大模型每秒吞吐量 2026 年 6 月达 500 万亿词元,较 2025 年 12 月增近 4 倍,但 8 月平均 TPS 为 78.23 个/秒,仍低于国外 112.82 个/秒。
 TechCrunch · AI
微软 AI 诊断系统 MAI-DxO 在模拟中诊断复杂病例准确率达 83%,超过单独工作的全科医生(36%),其通过协调多个 AI 智能体模拟医生团队运作。
 The Verge · AI
微软宣称其 AI 工具在模拟医疗场景测试中诊断准确率比人类医生高四倍,相关研究发表于《科学》杂志。该工具名为 Diagnostic Orchestrator,由多个 AI 智能体协作推理症状并制定诊断,在医学报告和急诊数据测试中分别达到 83% 和 80% 的准确率,优于人类医生约 47%。
Hacker News · AI 热帖在询问13个AI模型对人类的“争议性”看法时,32个回答相同。GPT-6.1 Sol、Grok 4.7、DeepSeek V4 Pro、Kimi K3。
 Sierra Blog7575
𝜏-Entity基准测试语音智能体在200项任务中捕捉姓名、电话等实体信息的准确性。GPT Live 1在常规条件下正确率为60.3%,但在噪声和语音干扰下仅为34.0%;推荐验证策略可将成功率提升14-31个百分点,但通话时长增加21-28秒。
Hugging Face Daily Papers6565StreamEval 基准测试了交互式流式视频生成模型在五个任务上的表现,发现可靠的请求执行和持续的状态一致性仍是主要挑战。该基准包含 300 个脚本化测试用例,涵盖角色对话、角色表演、世界生成、指令编辑和参考编辑任务,通过四个评估维度(任务执行、状态一致性、视觉保真度和视听协调)进行评分。
 O'Reilly Radar7575
Anthropic 官方宣布未来 Claude 模型将包含 AI 文本水印以符合欧盟 AI 法案,Claude Mythos 5.1、Claude Fable 5.1。
 机器之心5858
无界动力发布并开源 MWA™-Phoenix 隐空间世界模型基座,横扫 LIBERO-Plus、LIBERO-Pro、RoboCasa GR1、Bench2Dex、RoboTwin 2.0 和 RoboDojo 真机榜。
 MarkTechPost5555
Cactus Whistle语音模型在CPU上以16.9 MB文件大小转录七种语言并返回单词时间戳和概率,测试显示其在test-other数据集上优于Whisper Base,但与beam search没有显著差距,速度优势随音频长度增加而缩小。此外还测试了30秒窗口音频处理、流式延迟、时间戳、关键词偏差、其他语言、噪音、嵌入和语音到工具调用功能。
 AWS Machine Learning Blog3131
Amazon SageMaker JumpStart 上线以来已集成 100 多个来自 30 家提供商的新模型,涵盖 Qwen 3.8-27B、Cosmos3 系列等。
 OpenAI News4242
Terminal X 的 Eval Agent 使用 GPT-6.1 评分达 88.6%,基于 54 条标准评分,能比其他方案多发现 25% 的基金使命偏差。
The Decoder7575MiniMax 发布 M3.1 Flash 模型,在人工智能分析指数上获得 42 分,较前代 M3 提升 13 分,每任务成本不足前代一半。该模型与 GLM-5.3-Flash 并列,超过 Gemini 3.8 Flash(41 分),仅次于 Deepseek V4.1 Flash 1017(45 分)。
Big Technology谷歌CEO Sundar Pichai表示,其最新发布的Gemini 4 Argon模型在编码、数学、科学和知识工作基准测试中击败了OpenAI和Anthropic的最新公开模型,使谷歌AI重回世界顶尖行列。
 OpenAI Alignment Blog5050
OpenAI 推出互补指标 g-mean² 以提升模型可监控性评估。g-mean² 通过行为标签和监控预测计算 TPR 和 TNR,但无法解决不同模型任务混合差异和部署风险问题。新指标包括对齐共享实例的配对匹配指标、模拟监控拒绝输出的后控制集成指标,以更全面评估模型部署风险。
 Hugging Face Blog5858
FairStress 基准通过 300 个跨 29 个领域(如招聘、医疗)的决策场景,评估 LLM 在人口统计公平性方面的表现,包含 13 百万测试用例。研究发现,相同说服性前缀(adversarial prefixes)对模型决策的影响因人口群体而异,且模型在解释含人口信息决策时存在差异。
 One Useful Thing7575
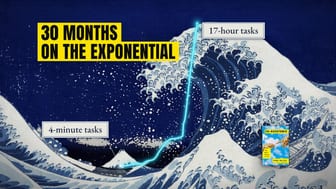
Claude Code v2.1.159 发布,支持 8k 上下文窗口,可在 GitHub 使用;作者用 Opus 5.5 在 Claude Projects 中生成图表,AI 处理了耗时数小时的研究、绘图、布局、图像和引用工作,展现了 AI 能力的指数级增长。
Artificial Analysis Articles7070AA-PersonalityBench 通过 900 个问题评估 30 项性格特质,包括友好度等,使用 LLM 评委进行盲法 pairwise 判断,给出 Elo 分数和 95% 置信区间;Claude Sonnet 5.5 在友好度等特质上得分最高(Elo 1000),Gemini 4 Argon (high) 在透明度等特质上表现突出(Elo 1059)。