Hugging Face Daily Papers3838
D3D:解耦扩散草稿异步推测解码技术
D3D 通过独立的扩散草稿器打破对目标模型隐藏状态的依赖,实现异步草稿与验证。在七个基准测试中,D3D 结合块状去噪和辅助自回归监督,使 Qwen3-8B 和 Qwen3-32B 的平均解码速度分别提升 5.00 倍和 5.71 倍,优于 DFlash(4.03 倍和 3.67 倍),并在 GSM8K 上达到 7.48 倍加速。代码、模型检查点和基准测试脚本已开源。
Hugging Face Daily Papers3838D3D 通过独立的扩散草稿器打破对目标模型隐藏状态的依赖,实现异步草稿与验证。在七个基准测试中,D3D 结合块状去噪和辅助自回归监督,使 Qwen3-8B 和 Qwen3-32B 的平均解码速度分别提升 5.00 倍和 5.71 倍,优于 DFlash(4.03 倍和 3.67 倍),并在 GSM8K 上达到 7.48 倍加速。代码、模型检查点和基准测试脚本已开源。
 OpenAI Deployment Safety
GPT-Image-2.6 Sunburst 和 GPT-Image-2.6 Flare 在公开数据、第三方合作数据及用户生成数据上训练,采用严格数据过滤流程,包括高级隐私信息过滤和安全分类器以减少有害内容。
 IT之家 · AI同一件事 · 4 家6262
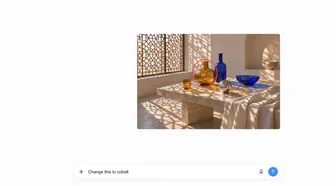
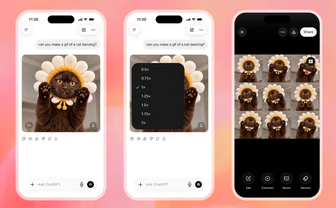
ChatGPT 支持直接生成和编辑 GIF 动画,此次更新与 OpenAI 的 Images 2.6 模型同步推出,允许用户调整 GIF 动画速度、编辑单个帧,每周通过 ChatGPT 及其 API 生成超过 40 亿张图片。
 36氪 · AI同一件事 · 4 家6767
OpenAI发布图像生成模型Images 2.6,现已面向全球用户开放,图像生成速度较上一版本提升50%,新增GIF生成功能。该模型支持在ChatGPT、Codex及API中使用,Flare版本在低质量设置下可在6秒内生成图像。
 Epoch AI6565
Epoch Capabilities Index (ECI) 更新采用贝叶斯模型方法论,提供更可靠的模型能力不确定性估计及模型间能力比较概率。新方法基于四参数逻辑斯蒂(4PL)项目反应理论(IRT),使用 Claude 3.5 Sonnet(ECI 130)和 GPT-5(ECI 150)作为锚点模型,通过线性变换固定参数位置和尺度,实现跨时间一致性。
 The Decoder精选同一件事 · 4 家7171
ChatGPT 现已支持生成动态 GIF,该功能基于 OpenAI 新的 Images 2.6 模型,正面向网页、桌面和移动端的全部 ChatGPT 与 Codex 用户推送。
推荐理由: ChatGPT 新增 GIF 生成能力,读者可据此了解图像模型在跨帧一致性上的进展与 API 变体划分。
 Google Research同一件事 · 2 家
Agile Deliberation 框架通过迭代对话协助人类定义主观概念边界,将模糊想法转化为精确的 AI 指令蓝图。该框架分为概念界定和概念迭代两阶段,通过直接反馈处理模糊图像,在 18 次 1.5 小时用户实验中显著降低用户疲劳和焦虑,使 AI 模型性能优于标准基线。
各家口径不同:谷歌研究提到用户实验减少疲劳和焦虑;MarkTechPost 关注 F1 分数提升。
 The Verge · AI同一件事 · 4 家
ChatGPT 通过提示或上传的照片生成 GIF,该更新与 OpenAI 新的 Images 2.6 模型一同推出,允许调整 GIF 动画速度、编辑单个帧并分享。此前 ChatGPT 无法单步生成 GIF。Images 2.6 更新还提升了 ChatGPT 的图像生成速度,用户每周在 ChatGPT 和其 API 上生成的图像超过 40 亿张,较 9 月报告的 30 亿张大幅增长。
IT之家 · AI5858小米 REDMI K100 手机新增 3D 运镜 AI 玩法,从相册选静态照片生成大角度 3D 运镜视频,镜头可环绕推拉倾斜且人物外观保持一致。该功能基于小米的视觉生成框架 WorldCast,通过解读画面深度结构将平面照片还原成三维场景并虚拟相机轨迹。小米称 WorldCast 是可控视觉生成方向的突破,将探索更复杂运镜形态及 4D 视频生成技术。
IT之家 · AI6565小米智能摄像机 4 Pro 首发价 329 元,今日京东政府补贴后降至 252 元,新增实体通话按键支持一键微信通话,可在摄像机与手机微信、米家 App 之间实现双向通话。
 量子位5858
招商局狮子山实验室发布具身推理视觉语言模型「驭物™ Lion-ER-35B-A3B」,采用MoE混合专家模型架构,总参数约35B,每个Token仅激活约3B参数。
Hugging Face Daily Papers6565FactEmbed通过将查询理解与嵌入构建解耦,利用分解的潜在向量模拟检索前的视觉修改,显著提升了组合图像检索性能。该方法在CIR基准测试中优于现有技术,通过中间目标想象优化分解表示,并利用全局级嵌入和均值池化潜在向量实现高效推理。
IT之家 · AI6262小鹏联合北大、港大等发布的 GroundingPI 模型在 34 项感知基准综合评测中得分 73.68,超过 GPT-6 Astra 的 71.54。该模型以约 40 亿参数规模,采用“感知优先”技术路线,在机器人仿真任务中展现更高数据处理效率与更强的场景泛化能力,显著降低示教成本并保持稳定性。
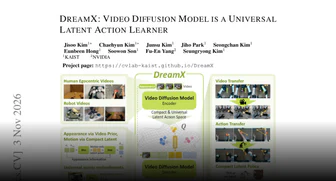
Hugging Face Daily Papers3838DreamX利用预训练视频扩散模型学习紧凑、外观不变的潜在动作,实现跨主体迁移和高效策略学习。DreamX从视频模型丰富的时空特征中提取潜在动作,将每帧压缩300倍(1200→4 tokens)。
 MarkTechPost同一件事 · 2 家
腾讯 WeChat Vision 团队发布开源视觉语言模型 WeVisOne-VL,包含 2B 和 4B 参数版本,支持检测、OCR、分割和 Matting,使用 9.6M 参数解码器输出像素结果,在 30+ 基准测试中超越同规模基线,4B 版本在 Dense200 密集检测上达 71.3 F1 分数。
各家口径不同:Hugging Face Daily Papers 表示使用轻量级像素解码器;MarkTechPost 提到 9.6M 参数解码器。
Hugging Face Daily Papers6565MoviEdit 框架通过级联双向自回归建模和新的基准测试,在减少人工数据标注的同时保持跨场景的连贯性,大幅优于现有开源模型,性能与行业前沿模型相当。该框架自动生成 87K 对配对编辑视频用于跨镜头监督,采用轻量级双向阶段建立全局编辑草稿,再进行自回归传播和细化。
IT之家 · AI6565网易《燕云十六声》将于 11 月 24 日实装英伟达 DLSS 5,成为国内首款支持该技术游戏,北美地区将提前一天上线。DLSS 5 是英伟达 2026 年 3 月公布的新一代实时神经渲染技术,以游戏帧为输入,利用 AI 模型生成拟真光照和材质,最高支持 4K 分辨率。该方案由神经网络实时重建复杂光照与材质细节,提升光照与角色质感,避免模糊或清晰度损失。
 AWS Machine Learning Blog2828
Amazon Bedrock 现在支持在印度境内对 Kimi K3 进行推理,满足严格的数据本地化需求。客户 Ultrahuman 通过 API 调用该服务,使 AI 健康助手能处理每日超 14,000 次对话,同时将健康数据保留在 AWS 内部,成本降低 80%,多轮对话速度提升 85%。
AWS Machine Learning Blog3434使用 EDB Postgres AI 在 Amazon Bedrock AgentCore 上运行 Strands Agents,通过查询语义层回答客户 360 (C360) 问题。
Hugging Face Daily Papers6565PhotoGuider使用共享的构图感知token选择观看方向并框定360°全景图,同时输出带解释性评分的相机参数。该方法在两个标准2D裁剪基准上达到最高平均miou性能,在盲法排名研究中对100个全景场景的评估中,其框定结果在53.2%的情况下优于其他两种方法。
Hugging Face Daily PapersReviso 是一个通过分层规划和主动感知学习优先考虑关键视觉证据的智能视频字幕框架,提升了字幕质量和下游视频理解能力。多模态大语言模型(MLLMs)生成的视频字幕可能过度强调次要细节而忽略重要上下文和关键事件。
 MiniMax · Hugging Face 新模型
MiniMax-H3-Image 是 MiniMax H3 家族的一款开源图像生成与编辑模型,支持 16MP 图像生成、图像编辑及最多 16 张参考图像,采用 H3 架构并使用 Qwen3-VL 文本编码器,在 Hugging Face 上提供 68.65GB 的 BF16 精度模型权重。
Hugging Face Daily Papers4747uni-robot-agent 框架使开源权重机器人使用智能体在零样本操作上超越专有模型,其搭载的 Qwen3.8-Flash-Next 在 RoboDojo 评测中得分 31.39,超过 GPT-6 Astra-RoboProbe 的 28.97 分及众多 VLA/WAM 基线,并在 19 项真实任务中表现优异。分析表明有效机器人使用需结合四项通用能力,建议未来训练应协同发展这些能力。
Hugging Face Daily Papers6565WeFair 通过保真度感知的人类反馈阶段(演示、偏好和验证)改进个性化查询重写,以减少意图漂移并提升短视频平台的搜索效果。该技术针对短视频搜索对紧凑查询重写器的需求,在严格延迟限制下从模糊查询中恢复用户个性化意图。WeFair-2B 在离线实验中整体准确性和意图保留方面优于强重写基线,在线 A/B 测试显示有效视频播放率相对提升 2.593%,查询重写率相对降低 2.350%。
Hugging Face Daily Papers3434Venus-DefakerOne2 通过交替 LoRA 和全参数微调及基于熵的测试自适应,将检测扩展到多种伪造形式和媒体类型,在 DeepFake 面部(96.7%)、AI 生成图像(93.3%)、篡改文档(87.6%)等六项基准测试中实现 SOTA 性能,显著优于专家模型和前身 DefakerOne。
 Import AI4242
Realtime-Bench 基准测试评估了 LLM 在 50 个实时交互游戏和网页任务中的表现,GPT-6 Astra 在真实时钟条件下获得 36% 通过率;该测试由德州大学奥斯汀分校等机构开发,用于衡量模型的实时状态感知、适应性推理和时间感知行动选择能力。
Hugging Face Daily Papers3838LARC 框架通过在连续隐藏状态上进行推理,缓解了统一多模态模型在图像生成中应用语言推理的瓶颈,提升了生成质量并实现无离散标记瓶颈的测试时扩展。该框架包含课程监督微调(SFT)和信息增益强化学习(RL)两个阶段,在文本到图像生成基准测试中,LARC 在 GenEval 上比 BAGEL 提升了 7% 的性能,并展现出明确的测试时扩展行为。
Hugging Face Daily Papers6565HiFOR 通过层级预测未来状态并检索相关未来信息来指导行动生成,提升机器人操作能力。该框架通过层级依赖掩码(HDM)联合预测短期状态演变、语义里程碑和最终目标状态,建立跨时间范围依赖关系;结构感知潜在世界建模沿时间、视角和空间维度组织未来潜在表示,促进细粒度检索;行动引导分解世界检索根据去噪过程中的行动表示自适应检索相关未来信息,为行动生成提供针对性指导。
IT之家 · AI6565用户 Infinite-Zombie5875 改造 2009 款索尼 NW-X1060 Walkman 跑通 ESP-NOW 通信,保留原装 Marvell 无线芯片,实现低侵入式改装。项目通过逆向解析固件收发链路,添加 ESP-NOW 动作帧接口和原生 C 语言 API,演示了跨设备联动的水族画面同步。
Hugging Face Daily Papers6565FrameForge通过动态时间专家和中间推理路径建模预训练视频模型的先验,实现自适应条件图像生成,在DreamBench、COCO2017和GEdit-Bench上取得优于对比方法的性能。
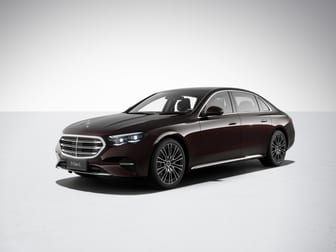
IT之家 · AI42422026款奔驰E300L改款轿车上市,建议零售价42.38万元至50.98万元,起售价下调1.6万元。该车首次搭载由奔驰中国研发团队主导开发的全新AI智能座舱,融合豆包AI大模型,支持季度性大版本OTA升级。
 Moonshot AI · Hugging Face 新模型
Kimi K3.1 Pro 是 Moonshot AI 开源的多模态智能体模型,参数量 2.8T,激活参数 104B,上下文窗口 1M tokens,在编码、3D 创建、金融研究等领域表现优异。与 Kimi K3 相比,采用 Gated DSA 层提升长文本处理效率,在 Terminal-Bench 4.0 等评测中超越 Claude Fable 5.1 和 GPT-6 Astra 等竞品。
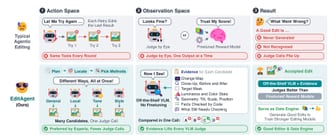
The Decoder5858Adobe 研究人员开发的 EditAgent 系统通过将通用编辑器与专用工具结合,并使用量化数据而非人工判断来选择最佳结果,显著提升了图像编辑 AI 智能体的性能。
 OpenRouter Blog6060
使用 OpenRouter Responses API 构建的 AI 代码审查器可在提交前检查 Git 代码变更中的错误和安全问题,审查过程平均耗时 1-4 分钟,费用介于 $0.015 至 $0.045 之间。
Hugging Face Daily Papers2222HairDeck 使用扩散 Transformer 从单张图像生成卡通发型卡牌和弹簧骨动画,准确性和速度优于现有方法。它将发型视为艺术家定义的原始集,通过扩散 Transformer 一起去噪生成每个卡牌为单个 token 的发型。
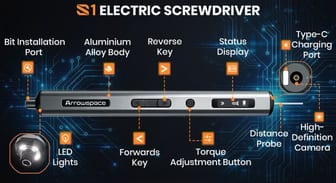
IT之家 · AI6565Arrowmax在Kickstarter推出AI电动螺丝刀S1,号称全球首创,起售价80美元,预计2027年4月发货。S1通过摄像头和AI模型识别螺丝类型、尺寸,并自动挑选批头、调节扭矩,所有训练样本均由自家采集。单机售价80美元起,套装早鸟价129美元起。
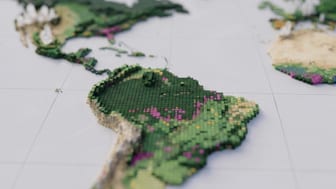
The Decoder6262由 Google Deepmind 和世界资源研究所开发的 ForTy AI 地图,以 10 米分辨率区分全球原始森林、木材种植园和树作物农场。该地图为 2020 年全球土地分配至六类,是首个此类全球地图,主要支持欧盟无森林砍伐产品法规(EUDR)的供应链风险评估,准确率达 90.2%,但树作物和种植园分类准确率仅约 50-60%。
IT之家 · AI4242荣耀将推出全新阿莱拍照模式,该模式基于 LogC 曲线设计原理与阿莱 Film Lab 合作,通过 RAW 信号重构全光谱并模拟 35mm 胶片感光曲线及暗房冲印过程,实现电影胶片级成像。
Hugging Face Daily Papers5858JEPAs在对齐的多模态观测上联合嵌入预测架构,比下一词预测更高效地收敛到共享表征,证明是正向视图设计而非规模本身驱动跨模态对齐。
 Hugging Face Blog4040
MonsterHouse 是一个用 NVIDIA Nemotron Voice Agent、NVIDIA Nemotron ASR、NVIDIA Nemotron 3.5 Bolt E4B 4GB、Magpie TTS Zeroshot 和 Audio2Face-3D 构建的互动投影,能通过语音与访客交流并模仿脾气暴躁的老海盗声音。