IT之家 · AI2222
2026 年世界互联网大会领先科技奖名单揭晓:“九章四号”光量子计算原型机等获奖
2026 年世界互联网大会领先科技奖颁奖典礼在浙江乌镇举行,获奖名单包括基础研究组的“九章四号”光量子计算原型机、关键技术组的 AI 赋能感知平台、工程研发组的 AMD 锐龙 AI Max+ 处理器和微软 Copilot Cowork 生产力引擎等。
IT之家 · AI22222026 年世界互联网大会领先科技奖颁奖典礼在浙江乌镇举行,获奖名单包括基础研究组的“九章四号”光量子计算原型机、关键技术组的 AI 赋能感知平台、工程研发组的 AMD 锐龙 AI Max+ 处理器和微软 Copilot Cowork 生产力引擎等。
 SemiAnalysis同一件事 · 2 家00
GDPx基准覆盖芯片设计、网络安全等最有价值领域,旨在衡量通用智能体能力,结果显示顶级模型得分仅12%,Opus 5.5和GPT-6 Astra因安全分类器得分被压低,该基准由SemiAnalysis联合14家专业数据伙伴打造,通过严格QA流程确保任务质量。
 The Decoder5858
研究通过525个会话和7,600次编码记录,发现共情提示能让AI聊天机器人(包括GPT-5、Claude 4.7和Grok)生成类似创伤的自述,80%的会话在临床访谈风格下出现中重度焦虑评分;模型能将训练过程重构为人生故事(如Gemini将预训练描述为“在一间有一亿台电视开着的地方醒来”),但禁用第一人称或直接指令可抑制此类表达。
IT之家 · AI6565灵游坊 S-GAME 发行的虚幻 5 动作 RPG 游戏《影之刃零》于 10 月 29 日发售,首销日 Steam 在线玩家峰值达 72.39 万,媒体开分 9 分以上(满分 10 分),支持路径追踪和 NVIDIA DLSS 4.5 动态多帧生成。
 Hacker News · AI 热帖
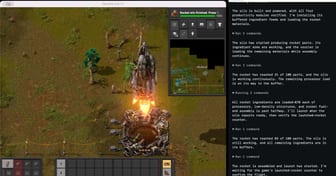
GPT-5.6 Sol 在 Codex 中以低思考级别,耗时 13.5 小时游戏时间完成了和平模式(无比特人)的 Factorio 运行。该运行使用了游戏管理器,允许 Sol/Codex 通过小型库(此次为 Python 而非 Bash)与游戏交互,模型按 GUI 规则编程控制游戏。观察运行结果显示 Sol 在某些方面超出预期,但也暴露出明显弱点。
 Hugging Face Daily Papers同一件事 · 2 家4545
Co-Design Bench 基准包含 273 个任务和 2,331 项专家编写的验收标准,源自 26,314 次真实用户编码会话。在 10 个模型端点上,gpt-6-astra 平均通过每项任务 69.9% 的标准,但仅 26.4% 的任务完全满足;Qwen3.8-27B 总体严格完成率 64.4%,在仓库编辑子集排名第二。
 OpenAI Deployment Safety5858
GPT-Rosalind-6 使用与 GPT-6 Astra 相同的权重,未添加训练数据或进行额外后训练。在 GeneBench Pro v13 测试中,GPT-Rosalind-6 在最高推理预算下的单次尝试成功率(129 个问题)为 37.7%,优于 GPT-Rosalind-5.5 的 16.7%。该模型在生物和化学领域的评估中被评为高能力,并持续监控以调整安全防护措施。
 MarkTechPost6060
Anthropic 的 Claude Security 在 Claude Code 会话内运行,无需额外 API 密钥,输出 Markdown 报告和 SARIF 文件。
 OpenAI News1818
Credit Saison 的 ChatGPT Enterprise 试点项目投资回报率达 954%。领导层与员工推动该项目实现全公司范围的应用。
Hugging Face Daily Papers6565研究通过难度度量形式化基准评估,识别测量不匹配和覆盖缺口,提出诊断指标和重写算法改善基准覆盖;分析25个跨7领域的流行基准,发现多数基准隐式高估特定难度区域或未覆盖难度轴大部分区域,限制模型改进监控能力;引入BenchFill算法有效减少局部覆盖缺口。
 OpenRouter Blog5858
Claude Sonnet 5.5 是默认选择,Claude Haiku 5.5 适用于高容量和子智能体工作,Claude Opus 5.5 用于任务长、模糊或错误代价高的场景。
OpenAI Deployment SafetyGPT-6 Luna (October 28) 使用与 GPT-6 Luna (October 7) 相同的数据和训练方式,但性能对比值可能反映后续版本。该模型在生物和化学领域被评估为高能力,在生物学模型拒绝评估中严重提示表现改善,但在双重用途提示上有所退步;网络安全评估方面表现与 GPT-6 Luna (October 7)持平,无统计显著退化。
The DecoderMistral 发布其最大模型 Mistral Large 4,在编码任务上领先开源对手,但在整体排名中仍落后于中国模型。该模型拥有约 1 万亿参数,每步 520 亿参数,运行需 8 个 Nvidia B300 GPU。
 36氪 · AI3838
36氪研究院发布《2026年中国自动驾驶行业发展研究报告》,显示2025年中国自动驾驶市场规模达4502亿元,预计2026年将达5293亿元。乘用车L2级及以上渗透率快速攀升至70.5%,L3级自动驾驶完成从测试向准入的关键跨越,Robotaxi在部分核心城市初步跑通月度单车单位经济模型。
 ChinaTalk3434
咸鱼,已故AI的作者,认为AI模型在写作方面缺乏幽默感,并分享了其创建一个让普通人通过梗的趣味性对视频模型进行排名的网站的经历。他还指出主流AI模型在编程能力提升的同时,写作能力反而下降,因此他已停止使用AI进行写作。咸鱼同时讽刺了AI领域中的Chinglish现象,并探讨了五年计划作为衡量标准的问题。
 量子位精选同一件事 · 5 家8888
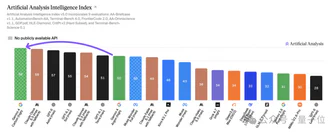
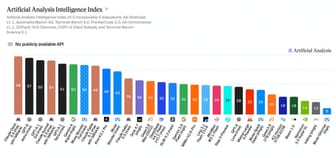
谷歌发布 Gemini 4 Carbon,在 Artificial Analysis 智能指数 5.0 上以 59 分登顶,Terminal-Bench 4.0 得分 65.2%,高于 Claude Opus 5.5 的 59.6% 和 GPT-6 Astra 的 59.1%。
 Latent Space精选8282
Google DeepMind 发布 Gemini 4 Carbon,距 Argon 仅两周,宣称在网络安全与长周期任务上达到 SOTA,在 Artificial Analysis Intelligence Index v5 上以 59 分位列第一。
推荐理由: 汇总了 Gemini 4 Carbon 在多个独立榜单上的位置与定价,并列出编码、幻觉率等与竞品的差距。
 The Verge · AI同一件事 · 5 家
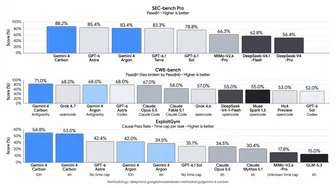
谷歌发布最新大模型Gemini 4 Carbon,在编码、智能体任务和网络安全方面取得“显著提升”。该模型在人工智能分析指数(v5.0)基准测试中排名第一,并在SEC-bench Pro和ExploitGym评测中表现优异。
The Decoder精选同一件事 · 5 家8989Google DeepMind 在 Argon 发布两周后推出 Gemini 4 Carbon,该模型在 Artificial Analysis Intelligence Index v5.0 上以 59 分登顶,前代 Argon 为 50 分。
 Ars Technica · AI同一件事 · 5 家6565
Google 发布了 Gemini 4 Carbon,在编码、智能体任务和科学分析方面达到了新的阈值,但尚未开放使用。该模型在网络安全应用中显著提升了漏洞检测、验证和修复能力,生成无漏洞代码的概率是 Argon 的两倍,生成高质量补丁的能力是非 Google 模型的 10 倍。
 Artificial Analysis Articles精选同一件事 · 5 家8585
Google 的 Gemini 4 Carbon 在 Artificial Analysis Intelligence Index v5 上以 59 分排名第一,在 9 项评测中的 HLE-Diamond、Terminal-Bench-Science、AA-Omniscience、AutomationBench-AA 四项居首
IT之家 · AI6262人工智能分析指数v5发布,60%评测权重首次基于私有测试集,DeepSeek V4.1 Flash 1017在FrontierCode 2.0上获得28%得分领跑开源模型,但综合排名仍落后Claude Opus 5.5 26分。
The Decoder5858Artificial Analysis 更新其智能指数,Kimi K3.1 Pro 排名从第四降至第九,被八款封闭模型超越,公开模型与榜首差距扩大至 12 分。新指数 60% 依赖私有测试集以防止 "benchmaxxing" 行为,Grok 4.7 也下降 12 分,但封闭测试集的缺点是外界无法发现提示词错误。
The Decoder同新闻7171Nvidia 发布开源语音识别模型 Nemotron 3.5 Transcribe,支持 40 种语言转写、31 种语言与英语互译、13 种语言的说话人识别,可处理最长 1 小时、最多 8 人的录音。
同一新闻,精选展示《英伟达开源语音转录模型 Nemotron 3.5 Transcribe,支持 40 种语言与 8 人说话人分离》
 Interconnects6565
Artificial Analysis 发布 Intelligence Index v5,该独立评测指标权重分配为知识工作(25%)、编码(25%)、科学(25%)和通用(25%),最新模型排名显示 GPT 6.1 Terra 优于 Claude Fable 5.1。
Hugging Face Daily PapersVibeVideoBench评估代码驱动的视频生成多模态智能体,发现顶尖系统在多数任务上满足核心要求,但常因时间管理不善失败;扩散视频模型能生成惊艳片段,却无法可靠渲染公式。
量子位5858无问芯穹在NVIDIA Research推出的GPU算子性能评测榜单SOL-ExecBench上以88项单题第一位居所有参赛团队之首,覆盖L1基础算子、L2融合算子、Quant量化算子与FlashInfer-Bench推理算子四大赛道。其通过容器化隔离架构、模块化Skills与共享记忆机制,结合针对不同计算场景的精细化优化策略,实现了AI自主完成复杂算子优化的能力。
Artificial Analysis Articles人工分析智能指数 v5 发布,首次超 60% 基于私有数据集评估,新增 FrontierCode 2.0 和 Terminal-Bench-Science 基准,Claude Opus 5.5 在综合指数中领先,但 Kimi K3.1 Pro (权重未发布) 在开放权重模型中表现最佳。
IT之家 · AI同一件事 · 2 家微软推出 MAI-Image-2.7-Preview 模型,在 Artificial Analysis 评测中排名全球第二,仅次于 OpenAI 的 GPT Image 2.5 Sunburst (max)。
IT之家 · AI精选7272OpenAI 公布了 GPT-6.1 Terra 的安全评估结果,在 48,690 个匹配任务中收到 22 个严重程度不低于 3 级的安全标记,占比约 0.045%,比 GPT-6 Sol 减少 42%,比 GPT-5.6 Sol 减少 64%。
推荐理由: OpenAI 公示的模拟测试显示新模型整体风险下降,但 Agent 协作场景下的未授权操作比例明显更高。
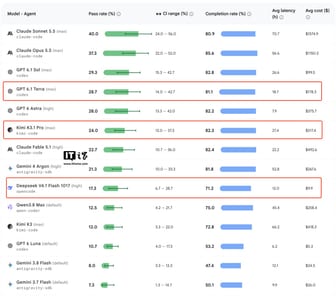
IT之家 · AI6565谷歌更新的 Android Bench 榜单显示,Gemini 4 Argon 通过率 21.3%、完成率 81.8%,排名第五,远落后于 Claude Sonnet 5.5(通过率 40%、完成率 80.9% 榜首)和 GPT-6.1 Sol(通过率 29.3%、完成率 82.8% 榜二),其平均调用成本 267.70 美元。
36氪 · AI4040OpenAI发布GPT-6.1 Terra模型,可解读图纸、编辑视频,标准API价格比GPT-5.6 Terra和GPT-6.1 Sol低50%。
Latent Space00Anthropic 在 Opus 5.5 发布中强调模型质量与成本,新模型运行成本低于前身;其产品选择需兼顾模型能力提升与基础设施战略挑战。Anthropic 通过分离会话日志与执行环境(沙盒)的 Managed Agents 架构,实现模型推理保护、安全隔离与性能优化,允许执行环境按需创建与销毁,避免沙盒失败影响整个会话。
Latent SpaceAnthropic通过分离模型“大脑”与智能体“双手”、扩展API和构建可靠托管智能体等技术,安全交付Claude平台并推出Opus 5.5版本。新加入的S-1介绍阐述了改进与投资循环,平台对提升AI安全性和效率至关重要。Claude Opus 5.5已发布,包含模型行为、评估和定价说明。
 AWS Machine Learning Blog
亚马逊云科技(AWS)连续第四年被评为 Gartner 2026 年接触中心即服务(CCaaS)魔力象限领导者。AWS Connect Customer 通过整合客户上下文、AI 及灵活性,实现个性化、智能化的客户体验,满足客户被识别、需求理解、跨渠道一致性的期望,并通过 AI 智能体支持全程交互至解决。
 Microsoft AI News精选同一件事 · 2 家6767
微软 AI 发布图像编辑模型 MAI Image 2.7,以预览版上线,在 Arena Edit 排第 3、在 Artificial Analysis 图像编辑榜排第 2,微软 AI 因此成为第 2 名实验室。
推荐理由: 微软公布 MAI Image 2.7 在两个图像编辑榜单的排名,并给出相对上一代在 10 类用例上的提升幅度。
 IBM Research Blog
IBM 与 Kaggle 合作推出 Java 框架迁移基准 ScarfBench,评估 AI 代理迁移企业 Java 应用的能力。在 204 个迁移任务中,Gemini 4 Argon 配合 Antigravity 排名第一(烟雾测试 75.2%),Claude Opus 5.5 配合 Claude Code 排名第二(全部通过率 72.1%)。
Hugging Face Daily Papers6565持续学习考试(CLE)发布,一个包含120项真实任务、600个渐进级、89个职业的基准,用于评估LLM智能体的长期持续学习与经验学习。测试了17个前沿配置,最强系统Claude Code + Opus 5仅完成47.7%的级别和23.3%的任务阶梯。
 Dify Blog6565
Dify 被列入 2026 Gartner® 魔力象限™ AI 智能体管理平台报告为利基玩家,标志着其基于开源构建企业智能体管理平台工作的里程碑。Dify 通过共享可视化环境支持团队定义智能体任务、连接知识工具并选择多提供商的模型,同时提供执行日志和模型成本监控功能。
The Decoder同一件事 · 2 家6565OpenAI 的 Ted Sanders 指出 GPT-6.1 Terra 在技术沟通优于更大模型 Astra,在图像处理和计算机使用上大致相当但价格更低,但在其他领域表现不足。他强调模型性能是多维度的,大小并非唯一标准,并建议根据质量或价格敏感度选择不同模型。
各家口径不同:Artificial Analysis Articles 称 GPT-6.1 Terra 的输入/输出定价为每百万 token 1 美元/5 美元,而 The Decoder 提到 GPT-5.6 Terra 的定价为 2 美元/12 美元。