Mastra Blog
Mastra FDE 发布:AI 工程师的前置部署工程计划
Mastra FDE 是面向所有构建 AI 智能体的团队的前置部署工程计划,通过派遣熟悉 Mastra 内部的工程师以低于一名资深 AI 聘请成本的价格,从第一周开始协助团队进行架构设计到生产部署,并提供定期 1:1 沟通、咨询或主动开发支持,同时享有与创始人及工程师的 Slack 通道、快速响应、路线图洞察、定制化培训和 Mastra Enterprise 全套功能。
Mastra BlogMastra FDE 是面向所有构建 AI 智能体的团队的前置部署工程计划,通过派遣熟悉 Mastra 内部的工程师以低于一名资深 AI 聘请成本的价格,从第一周开始协助团队进行架构设计到生产部署,并提供定期 1:1 沟通、咨询或主动开发支持,同时享有与创始人及工程师的 Slack 通道、快速响应、路线图洞察、定制化培训和 Mastra Enterprise 全套功能。
 OpenAI News
OpenAI 与 Upwork 的新研究显示自由职业需求正在转变,需要新的技能组合,AI 相关项目的预算和时长都在增加。
 Ars Technica · AI
DeepMind 发布 Gemini Robotics 2.5,其机器人 AI 在完成夹持食物、实验室移液等 200 项任务时已接近人类水平,并在 Apptronik Apollo 2 人形机器人上实现系蝴蝶结等高精度操作;该版本大幅提升灵巧性,同时推出开源安全基准 "ASIMOV-jailbreak"。
 The Verge · AI
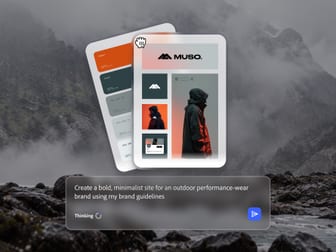
Adobe 宣布将把聊天机器人和 AI 智能体作为下一代设计助手,甚至自动化创意工作流程和重复性任务。在迈阿密举行的 Adobe Max 大会上,Adobe 推出了让第三方 AI 智能体访问和修改 Creative Cloud 项目的功能,Firefly AI 助手的新功能,以及 AI 智能体能够后台持续执行重复工作的能力。
 Hugging Face Daily Papers
Frontier3DBench 统一评估了 145 项任务中代码智能体在对象、场景和交互式 3D 世界创建上的能力,GPT-6.1-sol 在对象和场景层表现最佳,总得分 66.02/100,但所有配置在对象和场景任务中参考重建得分均低于文本驱动生成。生成世界在局部机制上平均 83.08/100,但在运动清除和状态化工作流上仅分别为 20.82 和 30.26,显示协调活动完成仍是核心瓶颈。
 IT之家 · AI
Blender 5.3 正式发布,原生支持 3D 高斯泼溅(导入 PLY/SPZ 格式数据),Linux 平台默认图形后端切换为 Vulkan(最低版本 1.1),Windows 版本除 ARM 设备外同步调整。
IT之家 · AI华为宣布鸿蒙电脑应用数量突破 2.1 万款,WPS Office等通用办公应用全面适配,中望CAD等专业软件完成适配,千问办公首发提供全场景AI体验,同时推进跨平台框架适配与开发者生态建设。
Hugging Face Daily Papers6565Reframe 通过证据感知强化学习和观察门控策略蒸馏,在 14 个图像和视频基准测试中提升具身视觉智能体的工具使用表现,优于 Mix-RL 和基础 MOPD 方法。其两阶段框架 GD-GRPO 和 OG-MOPD 分别通过随机移除原始视觉输入和从修复后的观察中恢复蒸馏,互补地促进模型依赖工具返回的观察结果。
 36氪 · AI
SpaceX SI团队从零重写Grok强化学习与推理软件,主体采用C语言开发,辅以少量C++,替代JAX、SGLang。该底层工程积累是Grok新AI栈的核心根基,复用星链的工程技术经验支撑Grok迭代。
 量子位
Fable 5.2 在智能体编程、软件工程测试等能力上全面超越 Opus 5.5,支持 100 万 Token 上下文,输出速度提升 30%,价格降 20%,API 每百万输入输出 Token 分别为 8 美元和 40 美元;网友实测可制作 3D 游戏、视频、交互体验,甚至从达·芬奇手稿生成 3D 模型,但高推理档位下 Token 消耗显著增加。
Hugging Face Daily Papers一种精确的瓦片注意力算法将加性相对位置项集成到类似 FlashAttention 的计算中,减少内存和计算开销,加速长上下文相对位置 Transformer。该方法(1)使用偏移感知瓦片避免冗余索引和内存访问,(2)仅计算必要的键/查询关系产品并在前向和反向传递中重用它们,以及(3)使用基于偏移的梯度分片和聚合,消除原子竞争。
Hugging Face Daily PapersOneTrans-GSR 通过单一自回归 Transformer 统一生成推荐排序列表,提升业务指标并减少重排序和混合排序延迟。在工业推荐系统中部署后,GMV/u 提升 2.63%,广告商价值提升 2.06%,回购率提升 2.03%,同时将端到端延迟降低 13%。
IT之家 · AI微软公布一项新专利,允许用户通过贡献闲置 GPU 算力参与 AI 训练并获得报酬。该系统将训练任务拆分为微型任务,分发至闲置设备执行,用户可获积分兑换免费软件、现金等。微软计划将此方案向第三方机构开放,以缓解 AI 训练算力紧张问题,但用户需主动授权且隐私保护等问题待解。
量子位Claude Fable 5.2 从空文件夹开始,1000个 Agent 8天自主编写完整操作系统并在笔记本上跑通;Anthropic 限制其 RSI 能力至 Opus 5.5 水平。
Hugging Face Daily PapersA2-MEAS 框架通过学习校正码和具身视觉语言行动模型提升机器人控制与故障恢复,在 50 任务 BEHAVIOR 2026 公开子集上达到 0.5755 Q-score 并实现 45.40% 任务成功率,12 项真实机器人任务平均成功率 57.92%。该框架采用动作预训练和任务专业化,训练吞吐量达 427.1 样本/秒,系统将开源模型、训练脚本及基础设施。
 Anthropic Research
Anthropic 与 Diode Computers 合作测试 Claude Fable 5.2 设计电子设备的能力,该模型能从设计到原型制作完成电子硬件。
 Ollama releases1515
Ripple Preview 是一个 65B 的密集模型,专为智能编码设计。Ricursive Intelligence 发布了 v0.40.16 版本,同时 Qwen3.8 Flash Next 在苹果硅芯片上减少了约 27 GiB 的内存使用。Claude 总是路由到选定的模型,且 /v1/responses 支持截断,不再默认静默截断。
Hugging Face Daily PapersPCBRouteAgent 在 247 块合成和真实 PCB 上实现 100%、94.9%、100% 和 40% 的 D2、D3-A、D3-B、D3-C 清洁通过率,在三个真实世界子集上分别比最佳基线高 13.9、36 和 10 个百分点。
 The Decoder
Meta 发布 Muse Ember,其迄今为止最小且最高效的 AI 模型,专为处理 AI 代理日常的重复性任务设计,如调用工具、处理小规模编码任务、路由请求、提取数据和处理长文档。
 Databricks Blog2222
Sendoso 通过 Genie One AI 代理将购买信号转化为销售管道,无需导出列表或登录其他工具。Databricks Marketplace 上的 MCP 服务器使 Sendoso 功能集成到现有数据环境中,AI 建议礼品、研究收件人和起草便条,支持在 Genie One 中直接与数据显示和原因并置。
 Meta Engineering3838
LLDB 通过 lldb-server 的中立加速器插件架构支持跨 CPU 和 GPU 的应用调试,将通用调试基础设施与硬件特定设备控制分离,将 CPU 和 GPU 呈现为独立的调试进程,在单一调试会话中协同工作。该架构通过插件将硬件特定调试 API 转换为 LLDB 理解的概念,支持不同架构、寄存器、内存空间和执行模型的 CPU 与 GPU 协同调试,同时保持客户端的中立性。
IT之家 · AI精选8282美团龙猫将面向长程智能体任务的原生多模态模型 LongCat-2.5 正式开源,采用 MIT 协议,支持商用推理部署与二次训练且无需额外授权。模型总参数 1.6 万亿,每个 token 激活约 480 亿参数,支持一百万上下文,并针对显存与带宽受限的国产算力芯片在架构、芯片适配与部署策略上做了协同优化。
推荐理由: 原文给出总参数、激活参数、上下文长度与开源协议,读者可据此判断长程智能体任务的开源模型选项。
Hugging Face Daily Papers3434LowRAM 通过低秩分解压缩键,并使用小头网络根据键预测值,同时保留最难重建标记的残差校正,实现 4 倍值缓存压缩且性能近乎无损。选择性重建可使 262K 上下文在 4 倍 KV 压缩下峰值解码吞吐量提升 5 倍。结合量化和驱逐,LowRAM 将压缩推至 26.9 倍,同时保留 94.5% 的基线性能。
 Import AI4242
Physical Superintelligence 开发的内部研究系统运行非公开 Anthropic 模型,在三天内证明了 Scott Aaronson 和 Andris Ambainis 的量子计算猜想。
Hugging Face Daily Papers3434P²-MOPD通过将每个学生模块表示为其自身可学习权重与冻结专家任务向量(专家减去基础模型)的加权求和,联合训练权重和混合系数α,使专家成为参数先验,显著加速多教师策略蒸馏。
量子位精选8282腾讯混元Hy4正式发布,770B总参数、49B激活参数,首次引入原生视觉能力和电脑操作支持,指令遵循、长文理解与长程Agent能力同步升级。模型已在腾讯云TokenHub、WorkBuddy/CodeBuddy、元宝等产品上线,API接入OpenRouter、Hermes、OpenCode等平台,权重将于近期开源。
推荐理由: 作者用多个长程任务实测混元Hy4的自主执行与自检能力,可据此判断开源模型在Agent交付上的实际水平。
Hugging Face Daily Papers3131智能体进化通过递归自我改进(RSI)提升性能而不更新模型权重,但高基准分数并不总带来可靠、高效和可迁移的改进。研究评估了四种方法在通用和编码任务上的表现,发现所有十六个进化智能体都获得了新任务能力但丢失了部分旧能力,其中一种通用任务智能体可靠性提升5.2点但丢失了十个旧任务。EvoAudit通过分析、变异和门控机制实现了最佳性能。
Hugging Face Daily Papers6565LongBanana是首个专家设计和验证的长上下文多参考图像合成基准,包含90个精心设计的任务,每个任务约含32张参考图像、20个约束和50个评估项,共4,670个专家指定的原子评估项。
量子位4747基元律动发布Agent原生模型NeoHorse-1.5-Flash Preview,基于Qwen3.8-Flash训练,180B总参数、6B激活参数,在Agents’ Last Exam、Natural Language to Repository等评测中得分提升。该模型通过递归自我改进(RSI)迭代,结合OpenSquilla平台实现多模型差分诊断与在线学习,现开放限量内测。
 MIT News · AI3838
由麻省理工学院和纽约大学研究人员开发的FLEX平台使机器人能够从自然语言指令中推断深层含义,提升运动规划能力。该平台通过GPT-4o分析指令模式,让机器人在虚拟场景中避开笔记本电脑和手机等电子设备,无需明确指示。整个过程耗时约五秒,旨在让机器人理解人类指令背后的潜在意图。
MIT News · AI5252WorldParticle 模型能模拟从滑动的沙子到折叠的蛋白质等多种物质行为,通过将物体分解为数千或数百万个三维粒子并使用神经网络预测其运动,无需为每种物质和过程编写特定方程。该模型在模拟可变形物体、颗粒材料和蛋白质等方面比数值模拟方法精度更高,并可通过合并技术优化计算效率。
 Simon Willison6565
Claude Code 或 Codex 生成的 PR 描述过于冗长,但隐藏在 HTML details/summary 元素中可优化阅读体验。将模型名和努力程度作为 summary,例如“Claude Opus 5.5 Medium”,读者可快速获取核心信息。GitHub Markdown 支持此功能,点击展开箭头查看完整内容,使 PR 不再显得杂乱。
Hugging Face Daily Papers6060Claude Opus 5.5 结合 Claude Code 与 GPT-6.1 Sol 在 HEELO 框架下处理 46 项真实任务时,单独完成 9 项,通过 MCP 服务器连接完成 39 项与 35 项,耗时分别减少 1.9 倍和 2.3 倍,成本降低 1.55 倍
IT之家 · AI6565Anthropic 发布研究报告显示,科学家主要将 Claude 用于数据分析和写作,收集数据、生成研究假设则较少使用 AI。研究基于 2026 年 8 月至 9 月 20.7 万次科研会话数据,其中计算机科学、数学和统计学领域使用比例最高,数据分析占 Claude 科研会话的 33.7%,写作与沟通占 32%。
 MiniMax · Hugging Face 新模型
MiniMax-H3-Image-PE 通过提示扩展(PE)将简短请求转换为详细图像描述并推荐宽高比。它支持文本到图像(T2I)和图像编辑两种工作流程,使用微调自 Qwen3.8-27B 的 FP4 权重。在线 API 可通过 platform.minimax.io 或 platform.minimax.cn 访问,文档提供中英文支持。
IT之家 · AI6767OpenAI GPT-6.1 Sol 在活体小鼠脑部手术中连续操作三次,通过外科医生反馈改善定位表现,耗时从 169 秒缩短至 86 秒,定位误差从 0.6 毫米降至 0.3 毫米,误差下降 50%。研究团队让模型参与小鼠头骨表面 Bregma 和 Lambda 两个关键解剖标志的定位任务,每次操作后保存图像、数据及修正记录供后续参考。
IT之家 · AI6565任天堂《塞尔达传说:时之笛》重制版于 11 月 5 日登陆 Switch 2 后,开发者已成功在越狱版 PS5 和 iPhone 上运行。PS5 版本基于 EglantinePS5 项目,12.40 固件下帧率约 15-20 FPS,但存在内存不足和渲染问题,补丁由 Claude 编写。
Hugging Face Daily Papers6565VisSearch-Bench 评估了 16 个多模态模型在 204 项人类编写的视觉搜索任务上的表现,这些任务要求整合视觉上下文与外部信息,结果显示最佳系统仅完全解决了 26.47% 的任务。该基准涵盖集合式视觉搜索、序列式视觉搜索等 7 个主要领域,通过准确率与过程分评估任务完成度与推理步骤的正确性。
 MarkTechPost6565
使用 llama.cpp 运行 NVIDIA Dory 1.0 4B 模型,该模型通过重复中间层计算实现推理增强,每个额外循环增加计算量但不增加参数。构建指定分支的 llama.cpp,下载 3.7 GB GGUF 文件,分析每层循环的参数和缓存消耗,测试解码速度和缓存影响,并在 GSM8K 上评估精度、答案长度和推理时间随循环次数的变化。
IT之家 · AI6565GitHub 发布全新 Git 存储架构 Rubicon,内部测试支持单个代码仓库容纳 5000 个智能体并发协作,每秒处理 7200 次推送,目前已开启小范围定向内测,计划明年初逐步扩大开放范围。