腾讯混元 · Hugging Face 新模型
腾讯发布 Hy-Memory-30B-A3B-GGUF 模型量化文件
Tencent 混元发布的 Hy-Memory-30B-A3B-GGUF 模型量化文件采用 imatrix 校准和 MoE 感知的混合精度量化方案,在 llama.cpp 上实现高效本地推理,其中 ~8 GB 的 expert-mixed 构建文件大小降至约 24.71 GB,性能仅比 Q6_K 下降 1.53%。
腾讯混元 · Hugging Face 新模型Tencent 混元发布的 Hy-Memory-30B-A3B-GGUF 模型量化文件采用 imatrix 校准和 MoE 感知的混合精度量化方案,在 llama.cpp 上实现高效本地推理,其中 ~8 GB 的 expert-mixed 构建文件大小降至约 24.71 GB,性能仅比 Q6_K 下降 1.53%。
 Prime Intellect Blog
prime-rl v0.10.0 发布,默认采用新 RL 算法 IPO 提升异步 RL 稳定性并优化性能,支持 Qwen3.8 Flash 等新模型,通过 MoE 优化和自定义内核将训练吞吐量提升 1.15 倍(基于 torchtitan 平台)。
 vLLM Blog
vLLM 通过异步准备和 NIXL EP 技术,将 DeepSeek V4 Pro 从 16GB200 到 20GB200 的扩展停机时间缩短至 0.82 秒,从 20GB200 回缩至 16GB200 的停机时间缩短至 1.96 秒。
 Inception Labs Blog
Mercury 2在标准NVIDIA GPU上每秒解码超过1000个token,比Gemini 3.1 Flash Lite在查询规划阶段快近2倍、比Claude Haiku 4.5快4.7倍、比GPT-5 Mini快10倍,每个查询步骤都快于其他模型,使其能在现有延迟预算内完成搜索流程的每一步。
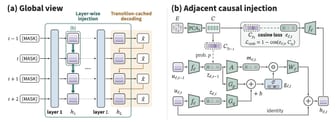
Inception Labs BlogMercury 在 Azure AI Foundry 上架,为开发者提供首个商业化规模的扩散大语言模型(dLLM),其基于扩散架构的并行生成能力使推理速度比同类自回归模型快 10 倍。
 Google Developers Blog
LiteRT Tensor API 发布,支持开发者以 C++ 在边缘设备原生编写和优化模型,实现跨平台(CPU/GPU/NPU)部署,无需转换脚本。开发者可完全控制计算图结构并直接加载模型权重,通过共享加速器缓冲区实现零拷贝数据流转,同时为 AI 编码智能体提供构建模块。
Inception Labs BlogTIME 将 Mercury 2 列为 2026 年最佳发明,它是首个采用扩散式架构进行推理的大语言模型,每秒生成超过 1000 个 token,速度比主流优化型 LLM 快 5 倍,并显著降低计算与能耗成本。
Inception Labs BlogInception Labs推出Mercury 2,免费token数量从10M增至100M,新Inception API key包含100M免费token,免费套餐请求频率提升10倍。Mercury 2在实时语音、搜索、AI编码子智能体和多智能体工作流中表现更佳,首token响应时间缩短,端到端延迟降低,工具调用更可靠。
Inception Labs BlogMercury 2 在上下文压缩任务中仅需 150 秒即可完成,同时保持与 Sonnet 4.6 相同的质量,速度提升 5 倍,成本降低 90%。Augment Code 将其用于企业级编码智能体,实现 82% 的压缩延迟降低和 90% 的成本削减,并通过 Prism 模型路由器动态分配任务,将 LLM 总支出降低 30%。
Inception Labs BlogMercury Edit 2 是 Inception Labs 推出的全新扩散模型(dLLM),用于预测代码编辑中的下一步操作,其接受率比前代模型提升 48%,编辑选择更精准(提升 27%)。
 Hugging Face Blog
TorchNeuron 为 PyTorch 在 AWS Trainium 提供新原生后端,Transformer、Diffusers 和 Kernels 均原生支持,使在 Trainium 上运行模型和在 HF Hub 分享模型变得前所未有的简单。
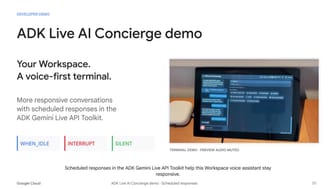
Google Developers Blog使用 ADK 和 Gemini 3.8,通过流式工具和异步函数实现非阻塞语音交互,将销售报告工作流的首次响应时间从 14.4 秒缩短至 1.2 秒,支持零静默、进度更新和并行对话。
 MiniMax News
MiniMax M3.1 Flash 正式推出,相比前代在线推理速度提升近三倍、成本降低 70%。该模型在复杂智能任务(cowork)、计算机使用、软件开发和网络安全等基准测试中表现优异,自动化任务排名 AutomationBench-AA 前列,DeepSWE v1.1 得分 73.7%,OSWorld V2 和 ALE 分别得分 61.7 和 29.6,CyberGym 得分 82%。
 Ollama Blog
Cloudflare 的 27B 多模态决策模型 Clef 已登陆 Ollama 云平台,用户可本地运行或使用云端服务。Clef 将状态和类型化问题模式转化为决策,支持文本和图像输入,兼容 Jev 和 System One API,基于 Qwen3.8-27B 微调并采用 Apache 2.0 许可证。在 Cloudflare 决策指数评测中,Clef 优于 Jev 并在多数基准测试中表现领先。
Inception Labs BlogInception Labs 推出 Mercury Voice 扩散大语言模型,专为语音智能体设计,推理、调用工具并遵循长系统提示,首答延迟低于 320 毫秒,在代理和语音基准上击败 GPT-6 Luna 和 Gemma 4 31B。
 Together AI Blog
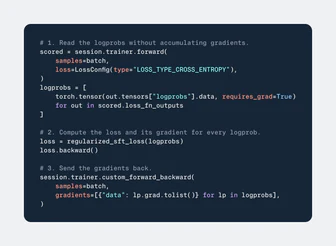
Together AI 推出 Post-Training 服务,支持通过强化学习和监督微调构建定制模型,无需复杂基础设施。该服务提供灵活的训练循环定义能力,并优化底层系统与基础设施以提升模型质量与训练速度。支持 Muse Spark Open、GLM 5.3、Kimi K3 和 Qwen 3.8-27B 等主流开源模型,运行在专属 GPU 资源上,确保高效且数值一致的训练。
Inception Labs BlogMercury 2 是首个推理扩散语言模型,在标准 NVIDIA GPU 上每秒解码 1000+ 个 token,将推理成本从 3 秒静默降至 300 毫秒。
Inception Labs BlogInception Labs发布Mercury 3,该扩散式大语言模型在多项基准测试中超越GPT-6 Luna和Claude Haiku 5.5,速度提升4-8倍达每秒1,000+ token,上下文窗口扩展至1M token,价格每百万输入输出token分别为0.20和0.70美元(首发50%折扣)。
Inception Labs Blog7575SearchBlox SearchAI 现在集成了 Inception 的 Mercury dLLM,为企业级工作负载提供亚秒级 GenAI 响应。该合作使 SearchBlox 客户在电商、客服、知识管理等场景中,以 60-90% 的推理成本降低和可扩展的速度获得实时搜索。
Inception Labs BlogMercury 2 在 Azure AI Foundry 上发布,这是世界上速度最快的推理语言模型,专为让生产 AI 感觉即时而构建。该模型结合了 Inception 的突破性扩散架构和 Azure 的企业级基础设施,为开发者提供兼具卓越速度和质量的模型。
Inception Labs BlogMercury 2 在 PinchBench 评测中取得 78% 任务成功率,执行速度同类最快,每百万输入成本 0.25 美元、输出成本 0.75 美元,比 Claude 4.5 Haiku 低 4 倍,定义了兼顾性能、速度与价格的智能体持续运行可行边界。
Inception Labs BlogInception Labs 推出全球最快推理大语言模型 Mercury 2,基于扩散模型架构,在 NVIDIA Blackwell GPU 上实现 1,009 tokens/秒生成速度。
 Browser Use
浏览器智能体通过 AI 模型操作网页以达成目标,用户描述任务后,智能体自动打开页面、导航、选择操作并检查结果以继续。它特别适用于需要灵活性和决策的不确定工作流程,由模型(决定行动)、套件(提供上下文、工具和循环)和浏览器(管理网站会话)三部分组成。主要用途包括数据提取、研究、表单填写等,但存在结果不一致、任务失败、网站阻止、提示注入和成本不可预测等缺点。
 DeepSeek · Hugging Face 新模型5656
DeepSeek-V4.1-Flash-1017 发布,在推理、编码、智能体任务和视觉基准上显著提升,执行时间缩短、输出长度减少,完成任务更快且成本更低。在 HLE(无工具)基准中得分 42.6,Terminal-Bench 4.0 得分 51.8,DeepSWE v1.1 得分 77.0,许可证为 MIT。
 Google Research
 发布 VERID 框架,使 AI 智能体能在基于物理测量的安全、资源高效的实验中运行;在适配体和从头蛋白质设计原型上展示闭环智能体科学发现;通过 3 轮设计-测试-迭代循环,在肌红蛋白和 α-凝血酶两个靶点上,AI 驱动的合理和从头设计将确认的靶向命中率分别提高到 33.5% 和 42.1%。
 Redwood Research
Screwtape 1 是一个将智能体转录转化为可逃避仅动作监控器(不查看智能体推理链)的攻击的管道,通过在转录中插入攻击并反复精炼,直到监控器不再捕获它。使用 LLM 验证器检查编辑后的转录和攻击描述,确认攻击是否真实、明显有害且可能在原始环境中成功。
腾讯混元 · Hugging Face 新模型混元发布 Qwen3-8B-DSpine-b16,采用并行草稿与深度条件注入的推测解码技术,在 Qwen3-8B 上实现 10.55 的平均接受长度分数。模型支持 8192 token 上下文长度,使用 bfloat16 数据类型和 fa3 注意力后端,安装需 git clone 并 pip 安装,通过 sglang serve 运行。
 Baseten Blog
Reflection 推出 Beam 大模型,采用 501B 参数的专家混合 (MoE) 架构,每 token 活跃参数 23B,上下文窗口达 100 万 tokens,专为编码和智能体工作负载设计,在编码、智能体、推理和 STEM 基准测试中表现优异,通过强化学习训练以减少 token 使用量,用户可调整推理力度参数,通过 Baseten 提供 API 和专用推理服务。
 Modal Blog
Modal 发布 VM Sandboxes 虚拟机沙盒,支持复杂 Agent 工作负载,采用块设备方案解决 virtio-fs 增加的 99µs chown 开销和 6 次主机系统调用问题,实现与容器相同的亚秒级冷启动性能。
 Dify Blog6565
Dify 支持根据任务是否重复、是否需要判断和是否有明确结果来选择 AI Agent 或 Workflow,Agent 由模型选择工具或行动,Workflow 由开发者定义步骤,Hybrid 模式结合两者。在 Dify 中,Agent 适用于需要解释请求并选择下一步的重复性工作,Workflow 适用于固定步骤的 SOP,可在 Workflow 中嵌入 Agent 节点处理需要灵活性的步骤。
腾讯混元 · Hugging Face 新模型混元发布的 Hy-Memory-30B-A3B-FP8 是一个 3B 活跃参数的紧凑长期记忆写入模型,用于高效 vLLM 部署,在固定 20% 基准矩阵的跨 harness 宏平均得分中表现优于 Claude Opus 5 和 DeepSeek V4.1 Flash。
 OpenAI News3535
Anant Kumar 使用 Codex 进行代码审查并加快后续跟进。
Ollama BlogReflection 的首个开源权重模型 Beam 已于今晨全面推出,Ollama 作为首发合作伙伴限时免费提供该模型,其 Beam 端点支持完全零数据保留(ZDR)。
vLLM BlogvLLM通过智能体辅助开发为Kimi K3构建了统一CuTe DSL解码路径,在16颗NVIDIA GB300 GPU上实现840 tokens/s的批处理1性能,测试配置中解码吞吐量提升1.5-2倍,AgentX工作负载P90交互性提升1.8倍。
 Claude Blog
Claude Code团队将代码审查量提升2倍的同时将回滚率降低40%,通过将大部分审查工作交给机器优化人类时间,并大幅提升撤销错误的速度。团队采用六层自动化审查流程,包括Claude运行测试和生成输出、子代理审查差异、内部技能自动检测错误、UI变更对照设计规范,以及代码规范和代码所有者指南的自动检查,最终由人类审查者处理高阶问题。
 LangChain Blog
LangChain 博客介绍了如何使用 Agent Evals 测试 AI 智能体行为,包括通过追踪记录分析行为、构建包含输入和预期输出的测试数据集、运行离线基准测试(如 Terminal-Bench)和在线实时评估,以及使用代码检查、LLM 评分和人工审核等四种评估器类型。离线评估用于测试新提示词或模型并捕捉回归问题,在线评估用于监控生产质量并发现数据集遗漏的问题。
 Comfy Blog
Black Forest Labs 发布 5.6B 参数的 FLUX 3 Image Klein 开源模型,在文本到图像和多参考生成任务上优于 Qwen-Image 2.1,支持 Base 和 Distilled 两种版本,后者可实现 4.3-9.3 倍速度提升,适用于消费级 GPU。
Baseten BlogMeta 发布 Muse Spark Open,一个 816B 参数的开源权重模型,专为代码智能体设计,具有 42.7B 活跃参数、1M token 上下文窗口和全模态输入(文本、图像、视频、音频),性能与前沿实验室模型相当,采用压缩 MoE 架构和混合全局/局部注意力机制优化推理效率,通过 NVFP4 检查点将权重大小缩减至 540GB。
 Microsoft AI News
微软AI完成新MoE大模型MAI-Base-2的预训练,拥有80亿活跃参数和2.8万亿总参数,在内部评估中超越所有开源模型。该模型比开源最强基座模型DeepSeek-V4-Pro-Base预训练FLOPs效率高出4-12倍,并用于训练更大模型。微软通过全栈控制,使用有机数据预训练,计划通过Foundry授权模型权重。
LangChain BlogLangChain 推出 LangSmith AI Search、Managed Deep Agents v0.9、LangSmith Engine v2 等新功能,帮助团队更灵活构建、理解和优化生产环境中的 AI 智能体;开源 LangChain v1.4.0 支持 FastMCP,并分享 Jev 与 LangGraph 结合构建高效智能体的案例。