Qoder Blog7070
Qoder Fast 通过客户端优化、并行工具执行、模型路由和网络改进将首次响应时间缩短至 3 秒
Qoder Fast 将首次响应时间从 8 秒缩短至 3 秒,通过客户端优化、并行工具执行、模型路由和网络改进实现,支持更流畅的 AI 协作。
Qoder Blog7070Qoder Fast 将首次响应时间从 8 秒缩短至 3 秒,通过客户端优化、并行工具执行、模型路由和网络改进实现,支持更流畅的 AI 协作。
 Databricks Blog
Databricks 将 RFD4-Proteina 模型集成到 Genesis Workbench,支持在 AI 运行时环境中执行,并与研究数据和工作流程连接。开发者可通过 Genie Code 和 NVIDIA BioNeMo Agent Toolkit 技能构建和调整管道,利用 serverless NVIDIA GPU 计算进行蛋白质设计。
 36氪 · AI7070
Flowtica AI 发布磁吸式墨水屏 Agent 硬件 Verso,厚度 6.5mm、重 78g,内置 4 麦克风阵列与骨传导传感器,采用常显电子墨水屏和实体按键,支持日程、待办、AI 提炼信息常显,无具体参数规模、benchmark 分数、速度倍数、价格、上下文长度、可用性信息。
 OpenHands Blog6363
Recursive Flint 发布,一款 40 亿参数的混合专家模型,专为本地高效推理设计,每 token 仅激活约 2.5 亿参数,在 M4 Pro MacBook Pro 上实现 125+ tokens/秒,NVIDIA RTX Spark 上达 150+ tokens/秒。OpenHands 作为其首发合作伙伴,支持该模型在本地硬件上运行,为开发者提供开源编码模型选项。
 vLLM Blog
蚂蚁集团和 vLLM 社区开源 Humming,这是一款通用的高性能量化推理内核库。Humming 支持英伟达从图灵架构开始的 GPU 以及 T-Head Zhenwu 810E 等 CUDA 兼容设备,提供广泛的量化支持,涵盖多种整数和浮点类型、位宽和缩放方案,在多个代表性工作负载上显著优于 vLLM Marlin、FlashInfer 和 DeepGEMM 等现有实现。
 Google Developers Blog
Agents CLI 1.5.0 版本引入扩展系统,允许开发者无需修改工具即可覆盖或添加命令,支持跨框架使用;官方发布的 LangChain 扩展替换了与框架绑定的命令,保留其余生命周期功能;开发者可创建自定义扩展,如添加软件物料清单(SBOM)扫描的部署命令,企业平台团队可借此强制执行治理策略。
 Baseten Labs同一件事 · 2 家6060
Baseten Labs 发布了全球顶尖的决策模型 Elephant-1(9B参数)和 Mammoth-1(27B参数),在 Jev Decision Index 和 Artificial Analysis Decision Index 评测中均排名第一。
 Browser Use3838
Browser Use Cloud MCP 服务器支持代理以纯文字形式提交完整网页任务,由其云端浏览器代理处理,每小时成本为0.02美元,可同时运行10个项目。该服务使用API V3,提供11种模型选择,浏览器为强化版Chromium,默认开启隐身模式及Cloudflare代理支持。
 Apple Machine Learning Research
TEAL 首次将 ViT 的 token 空间高效主动学习应用于低预算像素级语义分割,在 CamVid、Cityscapes 等数据集上以单张图仅 1 个像素标注为代价,将 mIoU 提升至 +24.36,10 个像素标注时达到全监督 97% 的性能。
 a16z News7070
OpenAI 收购了 Orchestra Bio。当前前沿模型如 GPT-6 Astra、Fable 5.1、Grok 4.6 能生成 CAD、设计 PCB、描述组装,但硬件设计基准如 CAD Arena、EE Bench、LuxoBench 显示仍需改进。AI 在硬件设计领域面临数字与物理世界接口的损失性难题,即使能生成设计,仍需大量工作。
Databricks BlogDatabricks 推出 Agent Memory,通过存储关键事实、偏好和流程提升智能体质量、降低成本和延迟,支持在 Lakebase 上运行,目前处于 Beta 版本。Agent Memory 基于 Databricks 最新内存研究,采用 MemCurrent 架构,在内部基准测试中使智能体任务通过率提升三倍,同时减少 31% 的 token 使用量。
 Interconnects6565
DeepSeek发布了552B参数的DeepSeek V4.1 Flash 1017模型,支持图像输入且采用MIT许可,性能价格比突出;美国国土安全部限制DeepSeek公司及模型参与联邦民用采购,中国商务部要求前沿AI模型国际共享需获政府预审批。
 OpenAI Alignment Blog5050
OpenAI 推出互补指标 g-mean² 以提升模型可监控性评估。g-mean² 通过行为标签和监控预测计算 TPR 和 TNR,但无法解决不同模型任务混合差异和部署风险问题。新指标包括对齐共享实例的配对匹配指标、模拟监控拒绝输出的后控制集成指标,以更全面评估模型部署风险。
 Hugging Face Blog5858
ALTK-Evolve 使用 GPT-4.1 学习并应用客户服务剧本,在 τ²-bench 客户服务代理基准测试中超越零售领域所有零售条目,得分达 67.5% Pass^4,且无需更新模型权重。该模型基于基本 ReAct 代理和 GPT-4.1,通过分析任务尝试并使用 GPT-4.1 将成功与失败蒸馏为简短行为规则,然后将这些指南添加到代理的系统提示中,无需权重更新或人工标注。
 Tessl Blog
 停止逐行审查代码,开始验证意图。团队合并的 PR 量是去年的四倍且几乎都是 AI 生成,导致审查成为瓶颈。团队转向在代码生成前审查意图(验收标准、约束和边缘情况),并将重复的审查评论转化为可由机器执行的规则(不变量),从而将审查重点从代码本身转移到决策和规则所有权上。
Tessl BlogTessl Blog 发布了构建跨公司 AI 智能体记忆系统的关键设计决策,提出存储声明而非数据块、显式表达时间和缺失状态、以及先于模型运行决定权限。
Tessl Blog7575工程团队对 AI 代码助手的信任程度决定其使用范围,从仅查看代码差异到完全授权合并,信任建立依赖于快速验证机制。开发平台成本随 AI 智能体工作强度增加而上升,约 80% 的预算被 20% 的重度使用者消耗,需评估单位有效工作成本。成功团队从辅助性任务开始逐步扩大 AI 范围,而非直接应用于核心系统。
 Cohere Blog
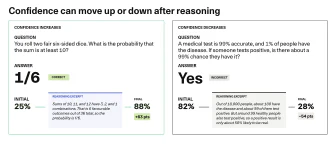
CALIBER通过训练推理模型在推理前预估成功概率,并在推理后评估具体答案的置信度,显著降低了校准误差。该7B模型在BigMathDigits基准上,ECE从0.059降至0.028(减少52.5%),同时AUROC达到0.806,Brier分数为0.130,证明置信度评估更可靠且能有效区分正确与错误答案。
 Mistral AI同一件事 · 2 家
Mistral AI 推出 Voxtral 3,包含 50+ 语言实时多步对话的尖端语音模型和语音代理 SDK,其语音转文本模型 Voxtral Small Transcribe 3 在 FLEURS 45 基准中 Forced WER 0.9%。
各家口径不同:The Decoder 提到文本转语音模型(Voxtral Mini TTS 3),而第一份报告没有详细说明。
 IBM Research Blog
llm-d 项目宣布发布 1.0 版本,这是一个 Kubernetes 原生的分布式推理服务网络,支持在任何加速器上、任何云中部署任何模型的推理栈。该版本增强了多租户服务质量、零停机操作和智能体感知服务,以在常见生产操作中实现持续性能。通过前缀缓存感知路由和 KV 缓存卸载等技术,llm-d 1.0 可捕获 97% 的可用缓存重用,降低大规模 AI 服务的成本。
Hugging Face Blog5858AnyLanguageModel 1.0 发布,一年支持苹果平台本地模型进展。新增支持 OpenAI Chat Completions、Anthropic Messages、Google Gemini 等云端模型,本地模型支持 llama.cpp、MLX、Core ML,工具调用与引导生成功能扩展。云端模型具备本地模型相同功能,API 密钥支持闭包动态获取。
Google Developers BlogGoogle发布原生PyTorch后端的vLLM和SGLang推理引擎,支持TPU并优化生产级服务;vLLM-TorchTPU在SemiAnalysis InferenceX基准测试中实现175B参数模型每百万token成本2.01美分,行业领先。
 Hamel Husain6060
在使用决策模型进行评估时,需要根据任务调整阈值以优化性能。在公寓租赁代理的日志数据集上,Jev 1.13、Perplexity Decider 1.1 27B。
vLLM BlogvLLM TorchTPU (vllm-torchtpu) 发布,可在 Google Cloud TPU 上运行 vLLM,支持 Pallas 内核的注意力、Mixture-of-Experts 和量化矩阵乘法,保持 vLLM 体验不变,支持六维并行,推荐 TPU v7x (Ironwood)。
 Modal Blog5858
Modal 推出 Sticky Sessions 功能,通过 @modal.sessioned() 装饰器实现会话级别的强亲和路由,确保同一会话的所有请求始终到达同一容器,适用于语音转文字、语音代理和多人游戏等需要状态连续性的工作负载。该功能基于 Modal Server 架构,通过返回签名会话令牌进行授权,采用容器并发量探测实现负载均衡,并按活跃会话数量进行会话级自动扩展。
 Anthropic Research
Anthropic 使用 Claude 分析 25 个开源项目(逾 500 万行代码),发现 493 个安全问题。Claude 在 11 个受保护项目中识别出 191 个未授权可达的代码点,包括 93 个默认配置下可访问的预认证表面、37 个认证前执行代码或记录状态的位置,以及 61 个导致预认证控制被管理员配置弱化的配置组合。
Google Developers BlogCoral NPU 发布了完整的 32 位架构,包含新的矩阵执行单元,支持高达 1 TOPS 性能和 10mW 平均功耗;推出基于 IREE/MLIR 的 Coral Compiler v1.0。
Google Developers BlogArm 利用 Google AI Edge Model Explorer 的分层图可视化和插件架构,开发了支持 TOSA、VGF 和 PTE 等格式的开源适配器,帮助开发者更便捷地检查边缘模型转换流程。
Browser UseBrowser Harness 在匹配评估中,使用 2.1M 中位数输入 token 得到与 Playwright MCP 和 Chrome DevTools MCP 相同的 60.4 分,成为每任务成本最低的浏览器控制工具,每任务成本为 0.042 美元。Playwright MCP 和 Chrome DevTools MCP 的速度更快,但 token 使用量更高。
Hugging Face BlogHugging Face 发布 TorchTPU,使 TPU 成为 PyTorch 的原生后端设备。Transformers、Diffusers 和 Kernels 现可直接在 TPU 上运行,用户只需从 Hugging Face Hub 选择模型,指定 device_map="tpu" 即可。
 Meta Engineering
GenRecs Tokenization 通过将广告、产品等项用稳定语义词汇表表示,结合 Meta 生成式广告模型(GEM)和自适应排序模型,为广告主带来 0.35% 的转化率提升。该技术利用预训练大模型的世界知识,使推荐系统能理解新项目或无历史交互的用户偏好,并通过共享概念加速学习、实现跨活动迁移、随大模型规模提升性能,形成性能改进的反馈循环。
 O'Reilly Radar6565
《周一早晨代理》项目每两周使用NFL公开数据集分析一个美式橄榄球争议话题,逐步为AI智能体赋予分析能力。该项目使用25万个比赛片段和当前赛季数据,每期让AI解释特定战术(如“建立进攻线”)并验证其分析结果。AI在分析时需说明数据局限性,并拒绝超出任务范围(如预测比赛结果)的请求。
Meta EngineeringMeta工程师通过构建一个1,300行的精简路由器,将20+工作流分配给14个专业AI代理,路由器自身不执行任何领域工作,显著提升了数据管道代理的效率和准确性。
 Sakana AI5555
Sakana AI 提出了‘QD-Rec’,将候选与假设的组作为推荐单位,通过生成AI参考过去的优秀假设来生成新的假设的循环,积累高质量的多样化推荐。在并购、客户定位、论文推荐方面进行了实验,在许多设置中平均评估都很高,构建了规模较大的推荐集合。
 LangChain Blog
Nu公司在开发AI健康教练Nu时,优先构建了评估标准以避免越界医疗诊断,采用LangGraph框架和LangSmith工具,通过按类别评分的LLM裁判和开放式行为测试,确保系统在满足健康指导需求的同时符合监管要求。评估框架针对单一回复和完整对话分别设计,支持在两个前沿模型提供商间快速迁移,安全探针和守门节点实时审查对话内容,确保产品始终处于合规边界内。
Modal Blog7575NVIDIA 将首个 Vera CPU 服务器交付给 Modal,该 Arm 兼容 CPU 通过模拟能力测试使模拟能力沙盒吞吐量提升 2 倍,适用于资源使用峰值可达 10 倍基线的异构工作负载,有助于降低成本并加速强化学习部署。
 n8n Blog
n8n 工作流可在 NVIDIA DGX Spark 上本地运行,无需调用云 API。通过在 DGX Spark 上部署 35B 混合专家模型 Qwen3.6-35B-A3B(NVFP4 格式)及 8 个其他模型,支持转录、OCR、图像生成等任务,所有模型均通过 OpenAI 兼容端点供 n8n 调用。部署需缓存模型并使用 vLLM 0.30.0 版本,确保离线运行和许可合规。
 Hacker News · AI 热帖7575
Qwen3-4B-deslop 模型通过微调消除了 AI 写作中的常见习惯(如破折号、"not X, but Y"句式、三元素列表等),在 40 个未见提示上 SLOP 分数从 121 降至 12.5,68% 的回答达到人类写作水平。该 4B 模型经 Ollama 量化后仅 2.5GB,可在本地运行,且仍保持 30/30 事实题正确率与原版相当。
IBM Research Blog2222Coursera 新课程《AI 数据流架构:从原理到实践》教授工程师如何跨 GPU、TPU、Cerebras WSE、Groq LPU 和 IBM Spyre 加速器工作。课程由 IBM 研究院高级研究科学家 Kaoutar El Maghraoui 主讲,通过六门课程和动手实验覆盖执行模型、编译、内存系统、调试和性能建模,强调不同架构如何影响模型性能及编译器优化关键作用。
O'Reilly Radar6565ContextCue 项目通过记录会议录音、保留语音讨论、屏幕共享视觉上下文、决策依据及来源,创建可跨团队的共享协作上下文。该实验针对 GitHub Copilot 和 Claude 等工具已提升编码效率但未改善团队间理解协作的问题,将会议记录转化为围绕请求或决策而非会议本身的 Markdown 格式输出,以解决分布式团队因时差和沟通断点导致需求理解偏差的挑战。