Google Developers Blog
Agents CLI 扩展系统:支持跨框架的智能体开发生命周期
Agents CLI 1.5.0 版本引入扩展系统,允许开发者无需修改工具即可覆盖或添加命令,支持跨框架使用;官方发布的 LangChain 扩展替换了与框架绑定的命令,保留其余生命周期功能;开发者可创建自定义扩展,如添加软件物料清单(SBOM)扫描的部署命令,企业平台团队可借此强制执行治理策略。
Google Developers BlogAgents CLI 1.5.0 版本引入扩展系统,允许开发者无需修改工具即可覆盖或添加命令,支持跨框架使用;官方发布的 LangChain 扩展替换了与框架绑定的命令,保留其余生命周期功能;开发者可创建自定义扩展,如添加软件物料清单(SBOM)扫描的部署命令,企业平台团队可借此强制执行治理策略。
 Baseten Labs同一件事 · 2 家6060
Baseten Labs 发布了全球顶尖的决策模型 Elephant-1(9B参数)和 Mammoth-1(27B参数),在 Jev Decision Index 和 Artificial Analysis Decision Index 评测中均排名第一。
 Browser Use3838
Browser Use Cloud MCP 服务器支持代理以纯文字形式提交完整网页任务,由其云端浏览器代理处理,每小时成本为0.02美元,可同时运行10个项目。该服务使用API V3,提供11种模型选择,浏览器为强化版Chromium,默认开启隐身模式及Cloudflare代理支持。
 AWS Machine Learning Blog3838
Smartsheet 推出通用模型上下文协议 (MCP) 服务器,使 AI 助手能通过标准化协议读写管理 Smartsheet 数据;支持 Amazon Quick 和 Kiro 连接,Quick 供知识工作者和运营团队自然语言查询更新 Smartsheet,Kiro 让开发者能参考项目规格和更新任务状态,无需离开编码环境。
 Databricks Blog
Databricks 推出 Agent Memory,通过存储关键事实、偏好和流程提升智能体质量、降低成本和延迟,支持在 Lakebase 上运行,目前处于 Beta 版本。Agent Memory 基于 Databricks 最新内存研究,采用 MemCurrent 架构,在内部基准测试中使智能体任务通过率提升三倍,同时减少 31% 的 token 使用量。
 Tessl Blog
 发布了构建跨公司 AI 智能体记忆系统的关键设计决策,提出存储声明而非数据块、显式表达时间和缺失状态、以及先于模型运行决定权限。
Tessl Blog7575工程团队对 AI 代码助手的信任程度决定其使用范围,从仅查看代码差异到完全授权合并,信任建立依赖于快速验证机制。开发平台成本随 AI 智能体工作强度增加而上升,约 80% 的预算被 20% 的重度使用者消耗,需评估单位有效工作成本。成功团队从辅助性任务开始逐步扩大 AI 范围,而非直接应用于核心系统。
 IBM Research Blog
llm-d 项目宣布发布 1.0 版本,这是一个 Kubernetes 原生的分布式推理服务网络,支持在任何加速器上、任何云中部署任何模型的推理栈。该版本增强了多租户服务质量、零停机操作和智能体感知服务,以在常见生产操作中实现持续性能。通过前缀缓存感知路由和 KV 缓存卸载等技术,llm-d 1.0 可捕获 97% 的可用缓存重用,降低大规模 AI 服务的成本。
 Lovable Blog7575
Lovable 企业版新增支持在用户自建 AWS 或 Azure 云帐户中部署应用及数据,通过“自带密钥”功能加密聊天和项目历史,并推出欧盟推理选项将 AI 请求处理限定在欧盟境内。企业版还引入“组织”功能,由中央 IT 团队统一管理身份认证、SSO/SCIM 配置及跨工作区审计,同时支持工作区策略审批机制控制应用发布流程。
 Hugging Face Blog5858
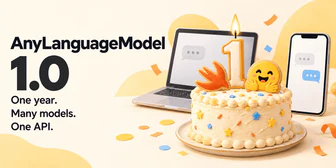
AnyLanguageModel 1.0 发布,一年支持苹果平台本地模型进展。新增支持 OpenAI Chat Completions、Anthropic Messages、Google Gemini 等云端模型,本地模型支持 llama.cpp、MLX、Core ML,工具调用与引导生成功能扩展。云端模型具备本地模型相同功能,API 密钥支持闭包动态获取。
 Anthropic Research
Claude 在 64 小时内自主生成 318,484 个蛋白质设计并筛选 180 个用于测试,与 Adaptyv Bio 和 Twist Bioscience 合作实验验证 211 个设计,其中 17 个符合结合标准,所有设计数据已公开。专家认为这是针对蝎子神经毒素的首次 AI 设计尝试,可能加速对忽视疾病的药物发现。
 vLLM Blog
vLLM TorchTPU (vllm-torchtpu) 发布,可在 Google Cloud TPU 上运行 vLLM,支持 Pallas 内核的注意力、Mixture-of-Experts 和量化矩阵乘法,保持 vLLM 体验不变,支持六维并行,推荐 TPU v7x (Ironwood)。
 Modal Blog5858
Modal 推出 Sticky Sessions 功能,通过 @modal.sessioned() 装饰器实现会话级别的强亲和路由,确保同一会话的所有请求始终到达同一容器,适用于语音转文字、语音代理和多人游戏等需要状态连续性的工作负载。该功能基于 Modal Server 架构,通过返回签名会话令牌进行授权,采用容器并发量探测实现负载均衡,并按活跃会话数量进行会话级自动扩展。
Hugging Face Blog精选6262Hugging Face 的 PyTorch 团队介绍 PyTorch 2.15 在 MPS 后端的更新,新增 torch.float8_e4m3fn 张量与 F.scaled_mm,FP8 张量占用为 BF16 的一半。
推荐理由: 原文给出 MPS 后端在 FP8、MoE 解码和显存占用上的具体数字,可据此判断 Mac 本地跑模型的实际变化。
Google Developers BlogCoral NPU 发布了完整的 32 位架构,包含新的矩阵执行单元,支持高达 1 TOPS 性能和 10mW 平均功耗;推出基于 IREE/MLIR 的 Coral Compiler v1.0。
 Mastra Blog
Mastra 发布 Mastra Launch 服务,为已使用 Mastra 框架但尚未将智能体投入生产的团队提供企业级访问权限和 90 天内完成部署的专属支持。该服务包括 Mastra 企业平台的全功能使用权限,以及 Mastra 工程师每周的现场协作支持,旨在帮助团队在 90 天内完成生产部署,否则仅需支付实施费用。
Google Developers BlogArm 利用 Google AI Edge Model Explorer 的分层图可视化和插件架构,开发了支持 TOSA、VGF 和 PTE 等格式的开源适配器,帮助开发者更便捷地检查边缘模型转换流程。
Browser UseBrowser Harness 在匹配评估中,使用 2.1M 中位数输入 token 得到与 Playwright MCP 和 Chrome DevTools MCP 相同的 60.4 分,成为每任务成本最低的浏览器控制工具,每任务成本为 0.042 美元。Playwright MCP 和 Chrome DevTools MCP 的速度更快,但 token 使用量更高。
Hugging Face BlogHugging Face 发布 TorchTPU,使 TPU 成为 PyTorch 的原生后端设备。Transformers、Diffusers 和 Kernels 现可直接在 TPU 上运行,用户只需从 Hugging Face Hub 选择模型,指定 device_map="tpu" 即可。
 Claude · YouTube
Claude 推出 Claude Dashboards 和 Claude Motion,前者在所有付费计划中支持将数据平台或 CRM 数据实时转化为仪表盘,后者在 Team 和 Enterprise 计划中支持将报告或图表生成动画解释视频,两者均以代码形式生成无需视频模型,可修改内容后导出 MP4 或编辑。
 Meta Engineering
GenRecs Tokenization 通过将广告、产品等项用稳定语义词汇表表示,结合 Meta 生成式广告模型(GEM)和自适应排序模型,为广告主带来 0.35% 的转化率提升。该技术利用预训练大模型的世界知识,使推荐系统能理解新项目或无历史交互的用户偏好,并通过共享概念加速学习、实现跨活动迁移、随大模型规模提升性能,形成性能改进的反馈循环。
Meta EngineeringMeta工程师通过构建一个1,300行的精简路由器,将20+工作流分配给14个专业AI代理,路由器自身不执行任何领域工作,显著提升了数据管道代理的效率和准确性。
 LangChain Blog
Nu公司在开发AI健康教练Nu时,优先构建了评估标准以避免越界医疗诊断,采用LangGraph框架和LangSmith工具,通过按类别评分的LLM裁判和开放式行为测试,确保系统在满足健康指导需求的同时符合监管要求。评估框架针对单一回复和完整对话分别设计,支持在两个前沿模型提供商间快速迁移,安全探针和守门节点实时审查对话内容,确保产品始终处于合规边界内。
Modal Blog7575NVIDIA 将首个 Vera CPU 服务器交付给 Modal,该 Arm 兼容 CPU 通过模拟能力测试使模拟能力沙盒吞吐量提升 2 倍,适用于资源使用峰值可达 10 倍基线的异构工作负载,有助于降低成本并加速强化学习部署。
 n8n Blog
n8n 工作流可在 NVIDIA DGX Spark 上本地运行,无需调用云 API。通过在 DGX Spark 上部署 35B 混合专家模型 Qwen3.6-35B-A3B(NVFP4 格式)及 8 个其他模型,支持转录、OCR、图像生成等任务,所有模型均通过 OpenAI 兼容端点供 n8n 调用。部署需缓存模型并使用 vLLM 0.30.0 版本,确保离线运行和许可合规。
IBM Research Blog2222Coursera 新课程《AI 数据流架构:从原理到实践》教授工程师如何跨 GPU、TPU、Cerebras WSE、Groq LPU 和 IBM Spyre 加速器工作。课程由 IBM 研究院高级研究科学家 Kaoutar El Maghraoui 主讲,通过六门课程和动手实验覆盖执行模型、编译、内存系统、调试和性能建模,强调不同架构如何影响模型性能及编译器优化关键作用。
 O'Reilly Radar6565
ContextCue 项目通过记录会议录音、保留语音讨论、屏幕共享视觉上下文、决策依据及来源,创建可跨团队的共享协作上下文。该实验针对 GitHub Copilot 和 Claude 等工具已提升编码效率但未改善团队间理解协作的问题,将会议记录转化为围绕请求或决策而非会议本身的 Markdown 格式输出,以解决分布式团队因时差和沟通断点导致需求理解偏差的挑战。
 Prime Intellect Blog
prime-rl v0.10.0 发布,默认采用新 RL 算法 IPO 提升异步 RL 稳定性并优化性能,支持 Qwen3.8 Flash 等新模型,通过 MoE 优化和自定义内核将训练吞吐量提升 1.15 倍(基于 torchtitan 平台)。
 Inception Labs Blog
Inception Labs推出Mercury 2,免费token数量从10M增至100M,新Inception API key包含100M免费token,免费套餐请求频率提升10倍。Mercury 2在实时语音、搜索、AI编码子智能体和多智能体工作流中表现更佳,首token响应时间缩短,端到端延迟降低,工具调用更可靠。
Inception Labs BlogMercury Edit 2 是 Inception Labs 推出的全新扩散模型(dLLM),用于预测代码编辑中的下一步操作,其接受率比前代模型提升 48%,编辑选择更精准(提升 27%)。
Google Developers Blog使用 ADK 和 Gemini 3.8,通过流式工具和异步函数实现非阻塞语音交互,将销售报告工作流的首次响应时间从 14.4 秒缩短至 1.2 秒,支持零静默、进度更新和并行对话。
 Amp News6565
在 Linear 中将问题分配给 Amp 会启动新的 Agent Session 并生成新的 orb,也可以通过 @Amp 启动会话。Amp 会将其回复发送回同一会话并回复中途收到的消息。Agent Session 也会出现在 Amp 侧边栏中并可完全查看。安装 Amp agent 到 Linear 工作区并连接 Amp 账户到 Linear MCP 即可开始使用。
 Together AI Blog
Together AI 推出 Post-Training 服务,支持通过强化学习和监督微调构建定制模型,无需复杂基础设施。该服务提供灵活的训练循环定义能力,并优化底层系统与基础设施以提升模型质量与训练速度。支持 Muse Spark Open、GLM 5.3、Kimi K3 和 Qwen 3.8-27B 等主流开源模型,运行在专属 GPU 资源上,确保高效且数值一致的训练。
Inception Labs BlogMercury 2 是首个推理扩散语言模型,在标准 NVIDIA GPU 上每秒解码 1000+ 个 token,将推理成本从 3 秒静默降至 300 毫秒。
Inception Labs BlogMercury 2 在 PinchBench 评测中取得 78% 任务成功率,执行速度同类最快,每百万输入成本 0.25 美元、输出成本 0.75 美元,比 Claude 4.5 Haiku 低 4 倍,定义了兼顾性能、速度与价格的智能体持续运行可行边界。
Browser Use浏览器智能体通过 AI 模型操作网页以达成目标,用户描述任务后,智能体自动打开页面、导航、选择操作并检查结果以继续。它特别适用于需要灵活性和决策的不确定工作流程,由模型(决定行动)、套件(提供上下文、工具和循环)和浏览器(管理网站会话)三部分组成。主要用途包括数据提取、研究、表单填写等,但存在结果不一致、任务失败、网站阻止、提示注入和成本不可预测等缺点。
 NVIDIA Blog
NVIDIA RTX Spark 笔记本电脑开始发售,配备 Blackwell RTX 显卡、最高 128GB 联合内存和完整的 NVIDIA AI 平台,起售价 2399 美元,由华硕、戴尔、惠普、联想、微软和微星推出,为便携设备带来强大的本地 AI、内容创作和游戏能力。NVIDIA 在全球举办发布会庆祝,包括柏林活动,创始人黄仁勋惊喜现身。
 Redwood Research
Screwtape 1 是一个将智能体转录转化为可逃避仅动作监控器(不查看智能体推理链)的攻击的管道,通过在转录中插入攻击并反复精炼,直到监控器不再捕获它。使用 LLM 验证器检查编辑后的转录和攻击描述,确认攻击是否真实、明显有害且可能在原始环境中成功。
Modal BlogModal 发布 VM Sandboxes 虚拟机沙盒,支持复杂 Agent 工作负载,采用块设备方案解决 virtio-fs 增加的 99µs chown 开销和 6 次主机系统调用问题,实现与容器相同的亚秒级冷启动性能。
 Dify Blog6565
Dify 支持根据任务是否重复、是否需要判断和是否有明确结果来选择 AI Agent 或 Workflow,Agent 由模型选择工具或行动,Workflow 由开发者定义步骤,Hybrid 模式结合两者。在 Dify 中,Agent 适用于需要解释请求并选择下一步的重复性工作,Workflow 适用于固定步骤的 SOP,可在 Workflow 中嵌入 Agent 节点处理需要灵活性的步骤。