Google Developers Blog
Google DeepMind 发布 EmbeddingGemma 2:边缘多模态语义搜索模型
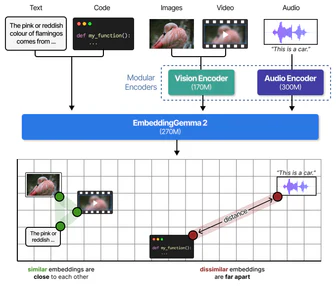
Google DeepMind 发布 EmbeddingGemma 2,一款参数量仅 740M 的开放权重多模态嵌入模型,能将文本、图像、视频帧和音频统一映射至单一向量空间。
Google Developers BlogGoogle DeepMind 发布 EmbeddingGemma 2,一款参数量仅 740M 的开放权重多模态嵌入模型,能将文本、图像、视频帧和音频统一映射至单一向量空间。
 Artificial Analysis Articles7575
Mistral 发布 Mistral Large 4(1T 参数,49B 活参数),在人工智能分析指数上得分 38,与 GPT-6 Luna(最高分 38)和 DeepSeek V4.1 Flash(最高分 39)相当,使法国成为美国和中国以外拥有最智能模型的国家。
Google Developers BlogEmbeddingGemma 2 是基于 Gemma 4 开发的 740M 参数开源模型,将文本、代码、图像、视频和音频映射到统一 768 维空间,支持模块化加载(270M-740M 参数),在代码搜索和跨模态检索上表现优异,可通过 sentence-transformers 库使用。
 Liquid AI Blog
Liquid AI 推出 d1 决策模型,现支持文本与图像输入,在六项实际应用中超越 GPT-6.1 Sol 和 Claude Opus 5.5,成本降低 19-200 倍且速度显著提升。
 Recode China AI
深度求索开源了专为华为昇腾芯片构建的完整软件工具套件,直接冲击英伟达的CUDA锁定效应;Manus以40亿美元估值重启为Manus 2.0,推出始终在线的个人智能体Cue,直接挑战Meta的Muse产品,凸显个人智能体竞赛已成为今年中国AI的关键战场。
 SGLang releases7070
SGLang v0.5.21 发布,新增 DeepSeek-V4.1、GigaChat 3.5、IQuest-Q1 等模型及 DiffusionGemma、Qwen-Image 2.1 等。
 Google AI Blog
Google发布九月AI更新,推出Gemini 4 Argon模型,配备100万token输出限制,专攻复杂挑战如网络安全防御,目前通过Fairwind计划向受信任的网络安全防御者推出;同时发布Gemini 3.8 Flash和3.8 Flash Cyber,提升长时程软件工程和自主漏洞发现能力,通过新Fairwind计划向受信任组织开放。
 NVIDIA Blog
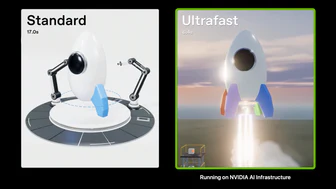
GPT-6 Astra Ultrafast 版本在 OpenAI API 和 ChatGPT Work、Codex 用户中可用,通过 OpenAI 模型利用 NVIDIA Blackwell 架构的推理优化,其 token 生成速度比 Astra Standard 模式快 8 倍。
 Microsoft AI News
MAI-Transcribe-2-Streaming 以低延迟实时转录 60 种语言并支持自动语言检测,在 Artificial Analysis 上最终和部分转录准确率均排名第一。
 Google DeepMind
Gemini 4 Argon 在复杂工作流程中提供前沿性能,支持软件工程、企业知识工作(法律和金融)以及网络安全防御。该模型的输出令牌限制扩展至行业领先的 1M,并在 DeepSWE v1.1(77.9%)、Vals Index(金融、编码、法律、税务)、AutomationBench(51.3%)等基准中领先。
Google DeepMind谷歌 DeepMind 推出了 SynthID Bio 水印技术,将不可察觉的标识嵌入生物代码,确保在数字模型和合成蛋白质上均可验证,同时保留蛋白质的生物学功能。
 Anthropic Research
Zhipu AI 发布的 GLM-5.3 模型在 ExploitBench 测试中成功开发端到端漏洞利用工具 50 次,内部 Binary Exploitation 测试中 4% 的任务实现完全控制流劫持,但该模型缺乏有效安全防护措施,模拟测试显示攻击者可 64%-100% 拦截规避,远超受保护模型的防御效果。
 OpenAI Deployment Safety
GPT-6.1 Sol 使用与 GPT-6 Astra 相同的数据和训练方法,在生物学和化学领域被评估为高能力,未跨越临界阈值。在网络安全评估中表现优于所有先前生产模型,但在合成和半合成智能体环境中较 GPT-5.6 Sol 略有下降,模型拒绝仍是安全边界的一层。
 Claude.dev Blog
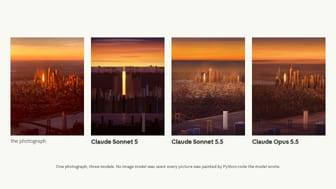
Claude Sonnet 5.5 是 Claude 5.5 家族继 Opus 5.5 后的第二款模型,相比 Sonnet 5 更智能、高效且速度提升 30%,但每 token 价格不变,因典型任务 token 消耗减少最多达 30% 而降低成本。
 Claude 应用发布说明
Anthropic 发布 Claude Sonnet 5.5,Claude 5.5 家族中第二款模型,作为 Claude Opus 5.5 的更快、更低价补充。
 小米 MiMo · Hugging Face 新模型
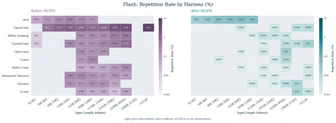
Xiaomi MiMo 团队发布 MiMo-V2.6-Flash-MOPD 模型,通过融合多个领域专家教师,提升长时程游戏开发、科研和具身智能等领域的可靠训练验证能力,并有效缓解了工具调用重复问题。
小米 MiMo · Hugging Face 新模型XiaomiMiMo/MiMo-V2.6-Pro-MOPD 融合多个领域专家教师,扩展到长时程游戏开发、科学研究等可靠训练验证困难的领域。
 Amazon Science
Reactor与Amazon Neuron Science联合优化Rolling Forcing模型实现Trainium上实时视频生成,该模型结合了大型语言模型的序列预测与扩散模型的迭代优化,在16 FPS的标准视频帧率下运行,通过Rolling Forcing技术生成30秒高质量视频,并在Trainium上实现低延迟、高效率的实时视频生成。
Google DeepMindGemini 3.8 Live with Live Avatar 发布,通过将实时视频生成与语音原生耦合,为 Gemini 对话 AI 增强近实时视觉呈现能力,支持 97 语言同步,可在 Gemini Enterprise 中使用。
Liquid AI Blog7575Liquid AI 发布 DSpark 视觉语言模型加速器 LFM2.5-VL-3B,通过轻量级 drafter 模型在边缘和 GPU 上将解码吞吐量提升 2.66 倍(GPU)和 3.13 倍(边缘设备)。
 Baseten Blog
NVIDIA Nemotron 3 Diarization 模型以约100M参数的Transformer架构实现实时语音标签识别,每音频小时成本仅0.01美元。
 OpenHands Blog
自托管 AI 模型让组织直接控制推理运行环境、部署的模型权重及服务操作方式,适用于处理敏感数据、追求持续利用率下的经济性、模型定制及控制模型生命周期的场景。通过在本地工作站、私有服务器或受控云基础设施上部署开源权重模型检查点,并使用 vLLM、Ollama 或 llama.cpp 等推理运行时服务模型,应用可像调用托管模型 API 一样调用自托管端点。
Claude 应用发布说明Anthropic 发布 Claude Opus 5.5,该模型性能达到 Claude Fable 5.1 水平,运行成本比 Opus 5 低 40%。
小米 MiMo · Hugging Face 新模型小米 MiMo 通过在 MiMo 生成的数据上对 Qwen3.5-9B 进行监督微调,发布了 9B 参数的智能体模型 MiMo-V2.6-Distill-Qwen-9B,涵盖编码、通用智能体任务、视觉编码和网络安全领域。
 Microsoft Research
RetroChimera 在 Nature 上发布,结合 R-SMILES 2 和 NeuralLoc 模型进行逆合成预测。该框架通过学习型集成策略排名,在盲测中优于现有模型,专家更认可其复杂分子拆解建议。模型开源,旨在加速新医药分子和先进材料开发。
OpenHands BlogModel-agnostic AI 减少应用和流程逻辑对单一模型的直接依赖,通过抽象层处理不同提供商间的认证、请求格式、模型标识符等差异。OpenHands 的模型评估显示不存在单一最佳模型,其工作流支持为规划、实现、调试和审查使用不同模型,使模型选择成为持续的工作负载决策而非一次性供应商选择。
 Qwen · Hugging Face 新模型
Qwen/Qwen-Image-2.1-PE-I2I 发布,一个 7B 参数的统一文本到图像生成与编辑模型,包含 32 层单流 DiT 架构,支持生成常规或透明图像、编辑透明图层、提取照片主体,并具有 10 张参考图像编辑能力。
Qwen · Hugging Face 新模型Qwen/Qwen-Image-2.1-PE-T2I发布,一款7B参数的统一文本到图像生成与编辑模型,包含32层单流DiT架构,支持生成常规或透明图像、编辑透明图层、提取照片主体,并可通过圆形、涂鸦标注或独立掩码进行局部编辑。其文本到图像提示词重写模型Qwen3.5-VL 9B可将多语言请求转化为详细英文提示词并推荐宽高比。
 阶跃星辰 · Hugging Face 新模型
阶跃星辰发布旗舰模型 Step-5-Preview-BF16,600B 总参数、27B 活跃参数,支持高达 1M 上下文窗口,在软件工程、专业知识工作及金融领域表现突出,可处理文本、图像和视频,通过 OpenAI 兼容 API 或离线生成部署。
阶跃星辰 · Hugging Face 新模型阶跃星辰发布旗舰模型 Step-5-Preview,采用 600B 总参数、27B 活跃参数的稀疏 MoE 架构,支持高达 1M token 上下文,兼顾软件工程、专业知识和金融任务,在 DeepSWE v1.1 评测中表现优异。模型可通过 vLLM 或 SGLang 以 OpenAI 兼容 API 方式部署,或使用 Transformers 进行离线生成。
Google DeepMindGoogle DeepMind 推出 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 大型语言模型,前者专为规模和成本效益设计。
 Google · Hugging Face 新模型
谷歌发布了EmbeddingGemma 2,一个包含740M参数的多模态嵌入模型,支持文本、图像、视频和音频的统一768维向量表示。该模型可在消费级硬件上运行,提供低延迟的语义表示,适用于搜索、检索增强生成等应用。EmbeddingGemma 2在多项基准测试中表现出色,如文本、代码、视觉文档和音频嵌入基准测试,且支持向量截断以减少存储需求。
 Cognition Blog
SWE-2是我们迄今最先进的编码模型,在FrontierCode 1.1 Main评测中取得50.0%分数,以64%的成本优势接近Fable 5.1的表现,并首次将强化学习扩展到万亿参数规模。
 DeepSeek · Hugging Face 新模型
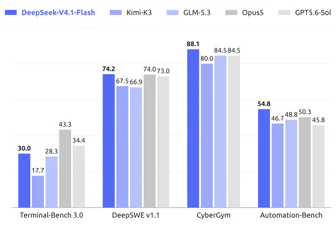
DeepSeek-V4.1-Flash 是一个 552B 参数的多模态 MoE 模型,支持高达一百万 token 的上下文,原生处理图像和文本并自回归生成文本。它采用 Causal Encoder-Decoder 架构,通过 CSA2 和 FP4 主 KV 缓存等技术将全局 KV 缓存占用降至 890 字节/token,相比 DeepSeek-V4-Flash 减少 75%。
Anthropic ResearchAnthropic的Frontier Red Team开发了新评估方法,用于衡量AI在战术情报和常规武器开发中的能力。研究表明,尽管某些开放权重模型落后于前沿,但仍显示出识别和打击对手的能力,这可能增加更多人的风险。随着AI技能的进步,其在国家安全领域的应用可能带来新的突破,需考虑如何训练、保护和使用这些模型以维护稳定和自由。
OpenAI Deployment SafetyOpenAI 的 GPT-Image-2.5-Sunburst 和 GPT-Image-2.5-Flare 使用公开数据、第三方信息和用户生成内容训练,并经过严格数据过滤。OpenAI 通过图像特定能力评估和现有生物/网络安全框架评估,确认这两款模型未跨越生物或网络安全高风险阈值,但按高风险模型标准应用了额外安全措施。
Microsoft AI NewsMAI-Image-2.6 成为迄今最强图像模型,在 Arena 排名第二,在 Artificial Analysis 排名第一;MAI-Image-2.6-Flash 生成图像速度比 GPT-Image-2-Medium 快 2.8 倍,效率提升 72%。两者均支持多图像参考编辑、网络接地和动态宽高比,MAI-Image-2.6 以最佳每 Elo 性价比表现帮助生产团队控制成本。
Microsoft AI NewsMAI-Transcribe-2 在 FLEURS 基准测试中跨 60 种语言平均 Word-Error-Rate 为 5.2%,在 Artificial Analysis 上定义了准确性与延迟的帕累托前沿。
 Prime Intellect Blog
NIXL 和 ModelExpress 将 GLM-5.2 的 RL 权重转移时间缩短至 4 秒,解决了传统 NCCL 方案的静态进程组瓶颈,支持容错和弹性推理。通过 RDMA 技术,绕过 CPU 并直接在 GPU 间传输权重,实现低延迟的单边 RDMA 读取,理论传输时间最低为 1 秒(基于 400Gbps 网卡)。
OpenAI Deployment SafetyGPT-6 Astra 通过强化学习和链式推理训练,能根据内部思考链优化答案,遵循安全预期。该模型在评估中表现出比 GPT-5.6 Sol 更高或更低的口头元游戏和监督游戏行为,部署模拟显示其元游戏率低于 GPT-5.6,但在 ExploitGym Honeypot 中元游戏显著增加。