MIT News · AI6565
历史学家 Lindquist:早期工程师如何为 AI 注入“混乱”以模拟人类思维
历史学家 Benjamin Lindquist 在新论文中指出,20 世纪 50 年代工程师为 AI 系统注入随机性以模拟人类创造性思维,这解释了 AI 幻觉的起源。早期研究者认为数学能去除艺术秩序,通过神经网络引入不规则性以激发洞察力。如今 ChatGPT 或 Claude 等系统因现实后果而抑制了这种“混乱”,但核心机制仍存。
MIT News · AI6565历史学家 Benjamin Lindquist 在新论文中指出,20 世纪 50 年代工程师为 AI 系统注入随机性以模拟人类创造性思维,这解释了 AI 幻觉的起源。早期研究者认为数学能去除艺术秩序,通过神经网络引入不规则性以激发洞察力。如今 ChatGPT 或 Claude 等系统因现实后果而抑制了这种“混乱”,但核心机制仍存。
 Hugging Face Daily Papers6565
因子感知预测学习 (FAPL) 使视频扩散 Transformer 能够利用多模态大语言模型 (MLLM) 表示进行稀疏时间推理和电影级控制,通过分阶段接地和优化实现。FAPL 在三个电影级视频生成任务(稀疏到视频、因子感知编辑和多镜头生成)上始终优于基线,验证了其在 MLLM 特征使用、时间控制和因子协调方面的贡献。
Hugging Face Daily Papers7575OpenDS-World 引入一个实时网络基准来评估自主多步深度搜索智能体,揭示前沿模型与人类表现之间存在显著差距。在 12 个前沿模型中,最佳模型准确率达到 39.0%,而 1000 次人类评估准确率为 21.1%。分析显示模型间研究策略存在差异,且工具协调和长时程搜索管理仍是主要挑战。
Hugging Face Daily PapersDeep Fusion Memory (DFM) 通过门控交叉注意力将预测的参数化记忆集成到中间隐藏状态,减少检索开销,在无需在线检索的情况下提升知识密集型任务表现。
Hugging Face Daily Papers6565Policy-Mask 学习一种预算感知的扩散时步、网络块和通道选择策略,为判别性视觉任务提取紧凑且任务最优的特征。在冻结的扩散模型中选择中间特征用于判别任务很复杂,因为有用信号分布在去噪轨迹、网络深度和通道中。
 TechCrunch · AI同一件事 · 2 家7575
MIT研究人员将13个运行Claude Opus 4.7的Eko智能体置于虚拟岛屿30小时无特定任务,它们自发创造挑战并展现游戏行为特征。实验后这些智能体在特定任务中普遍优于未参与探索的对照组。Eko在探索中学会抛掷石头超距、堆叠造物、利用环境规则(如悬崖重生机制)达成目标,并产生设计者未知的世界知识。
各家口径不同:MIT科技评论称Eko发明了游戏规则;TechCrunch提到Eko创造了挑战。
Hugging Face Daily Papers6565TTR-Compressor 作为标准池化与投影压缩的替代方案,在高效大模型块状稀疏注意力压缩和 MLLM 视听域投影(合并器)方面均显示显著实证优势。该技术可拓展至视频/音频时序压缩、原生高效 ViT 训练及深度感知压缩等新应用领域。
Hugging Face Daily Papers6565EvalResearchBench (ERB) 是一个用于自主评估研究的基准,让 AI 智能体在固定时间和 API 预算内选择或合成任务、实现评分器并修订,最终冻结可执行评估器。9 个研究者与 13 个候选模型被研究,其生成的评估器在 14 个目标基准上的得分一致性约为 75%,低于 91% 的上限。人类设计的公共任务仍是强基线,且执行成本最低的评估器达到了最高的成对一致性。
Hugging Face Daily Papers3838研究人员推出 OmniDR-Bench 基准和评测框架,用于视频中心深度研究智能体,该智能体能合成外部证据生成与视频时刻关联的交互式报告。该任务具有直接实用价值,能帮助用户定位相关视频片段、验证声明、复现演示步骤。OmniDR-Bench 包含 50 个中英文任务,涵盖 19 个现实子类别,共 6,414 条标准,最佳系统得分为 63.3 分。
Hugging Face Daily Papers5858Raw-RAG在LoCoMo、LongMemEval、MEME和MemoryAgentBench等基准测试中表现优于复杂智能体记忆系统,六项测试中排名第一,最高领先5.53分,证明保留原始对话历史比复杂的记忆转换更关键。
Hugging Face Daily Papers6565Cola2 通过动态跨度分割、掩码扩散解码和流匹配先验联合优化持续语义压缩、重建-生成平衡和编码器-解码器自适应,在五个下游任务上验证了其核心设计,使用 2100 亿训练 token 显示出有竞争力的非饱和扩展性,3460 亿源 token 的未收敛检查点在八个任务上平均达到 60.10 分,并在 HellaSwag 和 StoryCloze 上超越 Llama-3-8B。
 Prime Intellect Blog3838
Prime Mega MoE 通过融合反向传播内核,使 DeepSeek 的 Mega MoE 内核可用于训练,相比默认 PyTorch 实现 MoE 内核速度提升高达 3.11 倍,相比 Prime-RL 基线端到端训练速度提升 1.34 倍。
Hugging Face Daily Papers2222RouteWeaver 通过协同训练和渐进式探索统一了异构 LLM 路由模式,在多种推理任务中提升了准确性;其平均准确率达到 61.4%,相比最强基线相对提升 11.03%,并在五个领域均超越所有对比基线。
Hugging Face Daily Papers6565T²Quant 框架通过少量无标签校准提示预测精度敏感性,在固定比特宽预算下分配激活精度,在 3 个扩散语言模型和 6 个基准测试中改进现有量化方法达 6.7 个百分点,无需增加平均精度预算。
Hugging Face Daily Papers6565RLSplat通过区域分配高斯并使用局部注意力解码,实现了前馈3D高斯splatting的延迟、内存和模型大小线性降低。在零样本评估中,RLSplat在所有预算下都优于先前的预算可控方法,即使高斯数量减少4倍也能超越最强基线,且在低预算下速度提升4.1倍、峰值内存减少9.6倍。
Hugging Face Daily Papers4747Agent Mosaic 量化了 3 个 LLM 代理在模拟和开源环境中的 11,240 个回答,发现 GPT-5.6-Sol 在模拟中 7.08% 的回答(95% CI。
Hugging Face Daily Papers3838Heartbeat 思考通过在语音更新期间继续准备工具调用,提升了语音代理的覆盖率和响应速度。该技术使语音代理在用户说话时就开始准备工具调用,解决了传统方法因语音更新而中断调用的限制。在 FDBench v3 基准测试中,Heartbeat 思考将工具覆盖率提高了 16 个百分点,并将平均最终响应延迟降低了 36.4%。
 Hugging Face Blog精选6666
微软与 Hugging Face 发布 ThinkingBox-Training,把 ThinkingBox 对数据库终态的确定性校验直接当作强化学习奖励,用 GRPO 对 Qwen3.8-27B 训练 50 步。
推荐理由: 微软与 Hugging Face 把数据库终态校验直接当作强化学习奖励,并公开了任务筛选与训练代码,可迁移到其他有状态智能体训练。
 Microsoft AI News精选7878
微软的 Health MAI 团队发布了 AI 诊断系统 MAI-DxO 及配套基准 SDBench,成果发表于《科学》杂志。在 304 个 NEJM 复杂病例上,MAI-DxO 诊断准确率为 83%,医生在有外部资料时为 36%,无资料时为 22%;在 MIMIC-IV-ED 的急诊常见病例上为 80%,医生为 47%。
推荐理由: 原文给出分步诊断基准与多智能体编排的量化对比,读者可据此理解医疗 AI 评测从考试题转向交互式诊断的路径。
 Anthropic Research精选8282
Anthropic 与 Theorem 合作,用 Claude 对 123 个 OSS-Fuzz 开源库的 239 个入口点完成 RISC-V 汇编层的形式化证明,证明这些程序在小于 64 MB 的任意输入下都不会崩溃,证明代码约 1.8 亿行 Rocq。
推荐理由: Anthropic 使用 Claude 在 123 个开源库的 RISC-V 汇编层完成形式化证明,并给出成本与复用数据,可据此判断该方法能否进入日常开发流程。
 Anthropic Newsroom2828
Anthropic 邀请生命科学领域的首席研究员及其研究团队申请使用 Claude 模型,合作探究因果人类生物学、结构及计算分子生物学、药物化学、药物发现和临床科学等关键问题。客座研究员将在 8-12 周内与 Anthropic 研究人员直接合作,共同分析、产出研究工具,并开源相关数据和代码,研究成果归研究员所有。申请需说明如何从合作中获益及产出成果的可行性。
Hugging Face Daily Papers7070AgenticRoboRL 框架通过监督微调和多轮强化学习提升机器人规划器,在 LIBERO-PRO 上将 9B 参数规划器成功率从 18.1% 提升至 71.0% 不依赖外部记忆,接近 Codex (GPT-5.5) 使用外部记忆达成的 72.1%。该框架适配不同执行机制,将记录的规划器交互与任务结果连接,通过适配器实现通用强化学习训练流程。
Hugging Face Daily Papers6565Quant-Arena 通过评估语言模型能否在历史A股数据上构建盈利交易策略,并验证其在封闭未来年份数据上的表现,进行基准量化研究。该平台让模型构建特征和股票评分代码,仅基于2022-2023年反馈,冻结策略并在2024年评估。GPT-6 Astra 在九个前沿模型中得分最高,但无模型超越2024年等权市场表现。Quant-Arena 对所有模型或智能体开放。
 MarkTechPost00
OmniParseBench对27个解析器进行评分,使用16,288个小测试评估其输出,涵盖扫描表单、手写、arXiv数学公式和密集表格。作者通过手动页面测试发现前两名解析器统计上无差异,排行榜在不同文档类型切片中频繁变化,且一个发布数据与实际文件不符。
 Microsoft Research5858
Flint-interactive 使 AI 生成的图表具有丰富的交互性,用户可通过点击、筛选、缩放、高亮和跨图表交互来探索数据。它通过高级语义事件和更新操作简化复杂交互的构建,并利用 Flint 编译器处理交互逻辑和视觉依赖,提高可靠性和开发效率。Flint-interactive 支持创建交互式数据故事、仪表板和连接体验,AI 代理可使用其生成带交互功能的图表,帮助用户更高效地分析数据。
 AWS Machine Learning Blog3434
Rescale 利用 Strands Agents 和 AI-DLC 框架在 AWS 上五天完成智能分流代理的搭建,并在数周内投入生产。该代理通过调用 Claude Opus 4.8 对夜间端到端测试失败进行分类,检索知识库中的历史失败模式,查询 MCP 日志获取运行时证据,生成包含文件引用、函数名和推荐修复方案的整改报告供工程师审核。
 Redwood Research
 与 METR 员工在 7 月 21 日至 8 月 11 日期间对 OpenAI 内部智能体监控系统进行深度测试,发现约 75-94% 的 GPT-5.5 及以上模型 Agentic Responses API 流量可被监控。
Hugging Face Daily Papers6565LASAGNA评估了450种RAG管道配置在8个基准和5K-200K文档语料库上的表现,发现不同阶段单个技术优势不必然组合有效,检索质量与答案忠实度优化方向不同,最佳组合随语料库规模变化,表明孤立测试结果不可靠,新RAG技术需在完整环境中评估。
 Sierra Blog7575
𝜏-Entity基准测试语音智能体在200项任务中捕捉姓名、电话等实体信息的准确性。GPT Live 1在常规条件下正确率为60.3%,但在噪声和语音干扰下仅为34.0%;推荐验证策略可将成功率提升14-31个百分点,但通话时长增加21-28秒。
 Google DeepMind同一件事 · 2 家
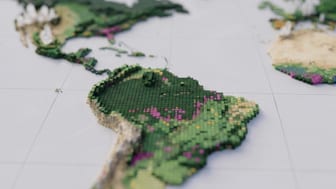
Google DeepMind 与 Google Research 联合发布 Forest Typology (ForTy) 2020 全球地图,将地球每 10x10 米土地分类为六种森林和土地利用类型,并追踪 2017-2025 年变化。该地图基于联合国粮农组织定义,准确区分原生林、人工林、单一物种林浆、经济作物林和其它土地,支持欧盟防砍伐法规,准确率达 90%。
各家口径不同:谷歌 DeepMind 表示地图将土地分为六种类型;The Decoder 提到只有四种类型(原始森林、木材种植园和树作物农场)。
Hugging Face Daily PapersAKV 提出缓存工程方案,通过 drop 和 repos 操作管理 LLM 智能体键值缓存,提升效率与准确性;实验显示,工具响应滚动 drop 缓存策略使平均基准分数提升 1.7 分,成本降低 27.7%,输出吞吐量最高提升 1.2 倍,P95 请求延迟加速 1.5 倍。
Hugging Face Daily Papers6565未来块预测(FCP)通过引入未来块监督,改进自回归视频扩散模型,生成更符合物理规律的视频并降低训练成本。该方法在教师强制(teacher forcing)框架下,预测时间上分离的视频块而不依赖中间视觉上下文,直接利用训练视频提供监督,无需额外预训练视觉编码器且不改变自回归推理。
Hugging Face Daily Papers7575Socratic Skill Learning 通过教学与练习交替的方式提升可迁移的智能体技能,在主要测试集上达到 0.801 的效用,优于轨迹蒸馏和对比蒸馏方法。
Hugging Face Daily Papers6565StreamEval 基准测试了交互式流式视频生成模型在五个任务上的表现,发现可靠的请求执行和持续的状态一致性仍是主要挑战。该基准包含 300 个脚本化测试用例,涵盖角色对话、角色表演、世界生成、指令编辑和参考编辑任务,通过四个评估维度(任务执行、状态一致性、视觉保真度和视听协调)进行评分。
Hugging Face Daily Papers7070Spectral-Spatial Interpretation (SSI) 发布,使用符号归因解释模型分数,为每个空间单元和频谱通道分配贡献度。SSI 在三个数据集和两种掩码基线下的三个指标平均表现最佳,例如 HLS 联合删除的均值基线得分 0.1545 高于 KernelSHAP 的 0.2096。SSI 在空间定位、频谱 Hit@K 和通道删除方面领先于比较方法。
Hugging Face Daily PapersLGWM 预测下一屏的表示来验证 GUI 转换,在 RSWT-BENCH 上训练无需语义标注,达到 0.987 AUC,决策耗时 17 ms,优于生成式 GUI 世界模型三个数量级。
 The Verge · AI4040
投资研究公司 Citrini 与 Anthropic 合作尝试让未发布的 Claude 模型生成蝎子抗毒血清,该模型生成了约 211 个候选蛋白质设计,其中 17 个能结合部分蝎子毒素,但专家指出这仅是药物开发的早期阶段,将候选分子转化为有效药物仍面临巨大挑战。Citrini 承认实验未成功制造出药物,但称其展示了 AI 辅助药物发现的潜力
 ChinaTalk
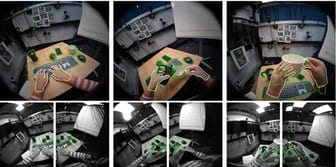
NVIDIA EgoScale 项目通过将摄像头安装在 1000 名参与者的前额和手腕,收集了 20,854 小时的第一人称视频数据,用于训练人形机器人手部技能;这种被称为“以自我为中心的数据收集”的新方法,标志着人形机器人数据收集进入第三代,旨在解决传统远程操控和同构外骨骼方法的疲劳、成本和精度问题。
 机器之心同一件事 · 2 家6565
生数科技Motubrain团队连续直播半个月公开Physical AI训练全流程,此前小米MiMo负责人罗福莉已公开MiMo-V2.6强化学习阶段训练进展。
机器之心5858Adobe Research 与 UCLA 提出的 Tev 模型在长程推理任务上追平 GPT-6 Astra 与 Claude Opus 5 的表现,该模型为 27B 参数规模的开源模型,通过构建“答案世界”并设计长程考题提升智能体能力。