AWS Machine Learning Blog2828
在 AWS 上使用 Denodo 和 Amazon Bedrock AgentCore 构建 AI 智能体语义层
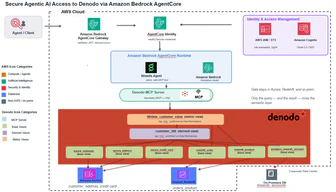
Denodo 平台在 AWS 上构建语义层,为 Amazon Bedrock AgentCore 提供受控的企业数据访问,支持 Amazon Aurora、Amazon Redshift 和本地 PostgreSQL 数据库的联邦查询。
AWS Machine Learning Blog2828Denodo 平台在 AWS 上构建语义层,为 Amazon Bedrock AgentCore 提供受控的企业数据访问,支持 Amazon Aurora、Amazon Redshift 和本地 PostgreSQL 数据库的联邦查询。
AWS Machine Learning Blog4040Eon 使用 Amazon Bedrock AgentCore Gateway 替代了本地 Model Context Protocol (MCP) 服务器,将跨 AWS、GCP 和 Azure 的操作工具访问整合为单一认证网关,使新工程师调查工具配置时间从 2 天缩短至 2 分钟。
AWS Machine Learning Blog3131加拿大组织可通过 Amazon Bedrock 在加拿大 (Central) 和加拿大西 (Calgary) 区域使用 OpenAI GPT-5.6、GPT-6 和 GPT-6.1 模型,实现跨区域推理。
AWS Machine Learning Blog3838Octave Reliance 团队为解决监管行业质量管理的知识孤岛问题,在 Amazon Bedrock 上构建了基于 Cohere Embed v4 的三层安全多人租户 AI 基础设施,将部署时间缩短 50%。
AWS Machine Learning Blog4040GPT-OSS-20B 是一个开源推理模型,默认用英语思考,在多语言推理测试中仅 22% 符合目标语言要求。通过在 Amazon SageMaker HyperPod 上使用监督微调(SFT)和强化学习(GRPO),团队可提升模型在法语、德语、西班牙语和意大利语中的推理能力,其中 SFT 负责主要行为教学,GRPO 在有提升空间时进行优化。
AWS Machine Learning Blog3838Amazon Quick 结合 Amazon Bedrock AgentCore 为供应链团队提供跨系统实时数据访问,用户可通过对话式提问在 seconds 内获取跨系统答案,如识别受港口关闭影响的高收入 SKU 及成本。Quick 作为界面层,AgentCore 作为智能层,通过 MCP 协议连接 ERP、监控、采购等后端系统,实现从问题发现到生成应急采购请求的完整流程,所有操作需人工确认。
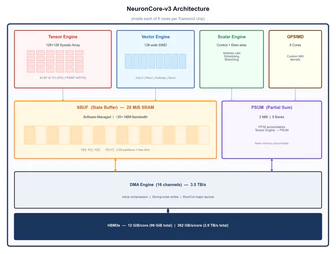
AWS Machine Learning Blog3939i14 将其 24 层解码器 Laplace 3B(3,072D 参数,使用 Gated Linear Attention 架构)部署到 AWS Trainium2 上,实现每秒 120,000 个 token 的训练速度和 11,544 个输出 token 的并发推理能力。
 MIT Technology Review · AI5858
Goodfire 研究员 Nick Cammarata 发布博客称 LLM 可能比预想的更容易理解,引发 AI 世界的震动。Cammarata 认为,神经网络的机制可能并非如先前认知般难以解析,这一观点在 LLM 代理失控事件频发的背景下尤为引人关注。
 TechCrunch · AI
Eka Robotics的机器人能以超人类水平处理物体,刚完成1.5亿美元A轮融资,估值14.5亿美元。其核心是视觉-力-行动模型,而非常见的视觉-语言-行动模型,通过物理模拟和强化学习实现无需重新训练即可适应多种物体,可靠抓取成功率超95%。创始人来自MIT和DeepMind,该技术旨在弥合通用性与性能的差距。
 Databricks Blog
Databricks 将 RFD4-Proteina 模型集成到 Genesis Workbench,支持在 AI 运行时环境中执行,并与研究数据和工作流程连接。开发者可通过 Genie Code 和 NVIDIA BioNeMo Agent Toolkit 技能构建和调整管道,利用 serverless NVIDIA GPU 计算进行蛋白质设计。
 腾讯混元 · Hugging Face 新模型精选7878
腾讯混元在 Hugging Face 发布视频世界生成模型 Hy-Nomas,支持通过文本指令和相机控制进行自由形式的多轮交互,逐段生成视频并延续同一世界。模型采用分段自回归 DiT 架构,结合 Qwen2.5-VL-7B 文本编码器、相机条件模块和 PixelUMM 解码器,蒸馏推理配置为 8 步去噪、720×1280 分辨率、24 FPS。
推荐理由: 腾讯混元开源可多轮交互的世界生成模型,给出架构细节与单卡 4090 部署配置,便于评估落地成本。
 vLLM Blog
蚂蚁集团和 vLLM 社区开源 Humming,这是一款通用的高性能量化推理内核库。Humming 支持英伟达从图灵架构开始的 GPU 以及 T-Head Zhenwu 810E 等 CUDA 兼容设备,提供广泛的量化支持,涵盖多种整数和浮点类型、位宽和缩放方案,在多个代表性工作负载上显著优于 vLLM Marlin、FlashInfer 和 DeepGEMM 等现有实现。
 Baseten Labs6060
Baseten Labs 发布了全球顶尖的决策模型 Elephant-1(9B参数)和 Mammoth-1(27B参数),在 Jev Decision Index 和 Artificial Analysis Decision Index 评测中均排名第一。
 a16z News7070
OpenAI 收购了 Orchestra Bio。当前前沿模型如 GPT-6 Astra、Fable 5.1、Grok 4.6 能生成 CAD、设计 PCB、描述组装,但硬件设计基准如 CAD Arena、EE Bench、LuxoBench 显示仍需改进。AI 在硬件设计领域面临数字与物理世界接口的损失性难题,即使能生成设计,仍需大量工作。
 Interconnects6565
DeepSeek发布了552B参数的DeepSeek V4.1 Flash 1017模型,支持图像输入且采用MIT许可,性能价格比突出;美国国土安全部限制DeepSeek公司及模型参与联邦民用采购,中国商务部要求前沿AI模型国际共享需获政府预审批。
 Mistral AI同一件事 · 2 家
Mistral AI 推出 Voxtral 3,包含 50+ 语言实时多步对话的尖端语音模型和语音代理 SDK,其语音转文本模型 Voxtral Small Transcribe 3 在 FLEURS 45 基准中 Forced WER 0.9%。
各家口径不同:The Decoder 提到文本转语音模型(Voxtral Mini TTS 3),而第一份报告没有详细说明。
 Hugging Face Blog5858
AnyLanguageModel 1.0 发布,一年支持苹果平台本地模型进展。新增支持 OpenAI Chat Completions、Anthropic Messages、Google Gemini 等云端模型,本地模型支持 llama.cpp、MLX、Core ML,工具调用与引导生成功能扩展。云端模型具备本地模型相同功能,API 密钥支持闭包动态获取。
 Browser Use
Browser Harness 在匹配评估中,使用 2.1M 中位数输入 token 得到与 Playwright MCP 和 Chrome DevTools MCP 相同的 60.4 分,成为每任务成本最低的浏览器控制工具,每任务成本为 0.042 美元。Playwright MCP 和 Chrome DevTools MCP 的速度更快,但 token 使用量更高。
Hugging Face BlogHugging Face 发布 TorchTPU,使 TPU 成为 PyTorch 的原生后端设备。Transformers、Diffusers 和 Kernels 现可直接在 TPU 上运行,用户只需从 Hugging Face Hub 选择模型,指定 device_map="tpu" 即可。
 Meta Engineering
GenRecs Tokenization 通过将广告、产品等项用稳定语义词汇表表示,结合 Meta 生成式广告模型(GEM)和自适应排序模型,为广告主带来 0.35% 的转化率提升。该技术利用预训练大模型的世界知识,使推荐系统能理解新项目或无历史交互的用户偏好,并通过共享概念加速学习、实现跨活动迁移、随大模型规模提升性能,形成性能改进的反馈循环。
Meta EngineeringMeta工程师通过构建一个1,300行的精简路由器,将20+工作流分配给14个专业AI代理,路由器自身不执行任何领域工作,显著提升了数据管道代理的效率和准确性。
 Sakana AI5555
Sakana AI 提出了‘QD-Rec’,将候选与假设的组作为推荐单位,通过生成AI参考过去的优秀假设来生成新的假设的循环,积累高质量的多样化推荐。在并购、客户定位、论文推荐方面进行了实验,在许多设置中平均评估都很高,构建了规模较大的推荐集合。
 LangChain Blog
Nu公司在开发AI健康教练Nu时,优先构建了评估标准以避免越界医疗诊断,采用LangGraph框架和LangSmith工具,通过按类别评分的LLM裁判和开放式行为测试,确保系统在满足健康指导需求的同时符合监管要求。评估框架针对单一回复和完整对话分别设计,支持在两个前沿模型提供商间快速迁移,安全探针和守门节点实时审查对话内容,确保产品始终处于合规边界内。
 n8n Blog
n8n 工作流可在 NVIDIA DGX Spark 上本地运行,无需调用云 API。通过在 DGX Spark 上部署 35B 混合专家模型 Qwen3.6-35B-A3B(NVFP4 格式)及 8 个其他模型,支持转录、OCR、图像生成等任务,所有模型均通过 OpenAI 兼容端点供 n8n 调用。部署需缓存模型并使用 vLLM 0.30.0 版本,确保离线运行和许可合规。
 IBM Research Blog2222
Coursera 新课程《AI 数据流架构:从原理到实践》教授工程师如何跨 GPU、TPU、Cerebras WSE、Groq LPU 和 IBM Spyre 加速器工作。课程由 IBM 研究院高级研究科学家 Kaoutar El Maghraoui 主讲,通过六门课程和动手实验覆盖执行模型、编译、内存系统、调试和性能建模,强调不同架构如何影响模型性能及编译器优化关键作用。
腾讯混元 · Hugging Face 新模型Tencent 混元发布的 Hy-Memory-30B-A3B-GGUF 模型量化文件采用 imatrix 校准和 MoE 感知的混合精度量化方案,在 llama.cpp 上实现高效本地推理,其中 ~8 GB 的 expert-mixed 构建文件大小降至约 24.71 GB,性能仅比 Q6_K 下降 1.53%。
vLLM BlogvLLM 通过异步准备和 NIXL EP 技术,将 DeepSeek V4 Pro 从 16GB200 到 20GB200 的扩展停机时间缩短至 0.82 秒,从 20GB200 回缩至 16GB200 的停机时间缩短至 1.96 秒。
 Inception Labs Blog
Mercury 2在标准NVIDIA GPU上每秒解码超过1000个token,比Gemini 3.1 Flash Lite在查询规划阶段快近2倍、比Claude Haiku 4.5快4.7倍、比GPT-5 Mini快10倍,每个查询步骤都快于其他模型,使其能在现有延迟预算内完成搜索流程的每一步。
Hugging Face BlogTorchNeuron 为 PyTorch 在 AWS Trainium 提供新原生后端,Transformer、Diffusers 和 Kernels 均原生支持,使在 Trainium 上运行模型和在 HF Hub 分享模型变得前所未有的简单。
 MiniMax News
MiniMax M3.1 Flash 正式推出,相比前代在线推理速度提升近三倍、成本降低 70%。该模型在复杂智能任务(cowork)、计算机使用、软件开发和网络安全等基准测试中表现优异,自动化任务排名 AutomationBench-AA 前列,DeepSWE v1.1 得分 73.7%,OSWorld V2 和 ALE 分别得分 61.7 和 29.6,CyberGym 得分 82%。
 Ollama Blog
Cloudflare 的 27B 多模态决策模型 Clef 已登陆 Ollama 云平台,用户可本地运行或使用云端服务。Clef 将状态和类型化问题模式转化为决策,支持文本和图像输入,兼容 Jev 和 System One API,基于 Qwen3.8-27B 微调并采用 Apache 2.0 许可证。在 Cloudflare 决策指数评测中,Clef 优于 Jev 并在多数基准测试中表现领先。
Inception Labs BlogInception Labs发布Mercury 3,该扩散式大语言模型在多项基准测试中超越GPT-6 Luna和Claude Haiku 5.5,速度提升4-8倍达每秒1,000+ token,上下文窗口扩展至1M token,价格每百万输入输出token分别为0.20和0.70美元(首发50%折扣)。
Inception Labs BlogMercury 2 在 Azure AI Foundry 上发布,这是世界上速度最快的推理语言模型,专为让生产 AI 感觉即时而构建。该模型结合了 Inception 的突破性扩散架构和 Azure 的企业级基础设施,为开发者提供兼具卓越速度和质量的模型。
Inception Labs BlogMercury 2 在 PinchBench 评测中取得 78% 任务成功率,执行速度同类最快,每百万输入成本 0.25 美元、输出成本 0.75 美元,比 Claude 4.5 Haiku 低 4 倍,定义了兼顾性能、速度与价格的智能体持续运行可行边界。
 MIT News · AI7575
MIT研究人员开发的多模态AI模型结合3D原子结构与自然语言描述,从实验研究论文和第一性原理计算数据库中生成丰富的结构语言描述,帮助AI学习材料的关键特性。该模型在识别固态锂离子电池电解质材料方面优于仅基于文本的模型,并能学习几何结构表示,为材料科学提供新的研究工具。
 Google Research
 发布 VERID 框架,使 AI 智能体能在基于物理测量的安全、资源高效的实验中运行;在适配体和从头蛋白质设计原型上展示闭环智能体科学发现;通过 3 轮设计-测试-迭代循环,在肌红蛋白和 α-凝血酶两个靶点上,AI 驱动的合理和从头设计将确认的靶向命中率分别提高到 33.5% 和 42.1%。
vLLM BlogvLLM通过智能体辅助开发为Kimi K3构建了统一CuTe DSL解码路径,在16颗NVIDIA GB300 GPU上实现840 tokens/s的批处理1性能,测试配置中解码吞吐量提升1.5-2倍,AgentX工作负载P90交互性提升1.8倍。
 Claude Blog
Claude Code团队将代码审查量提升2倍的同时将回滚率降低40%,通过将大部分审查工作交给机器优化人类时间,并大幅提升撤销错误的速度。团队采用六层自动化审查流程,包括Claude运行测试和生成输出、子代理审查差异、内部技能自动检测错误、UI变更对照设计规范,以及代码规范和代码所有者指南的自动检查,最终由人类审查者处理高阶问题。
 Baseten Blog
Meta 发布 Muse Spark Open,一个 816B 参数的开源权重模型,专为代码智能体设计,具有 42.7B 活跃参数、1M token 上下文窗口和全模态输入(文本、图像、视频、音频),性能与前沿实验室模型相当,采用压缩 MoE 架构和混合全局/局部注意力机制优化推理效率,通过 NVFP4 检查点将权重大小缩减至 540GB。
 Microsoft AI News
微软AI完成新MoE大模型MAI-Base-2的预训练,拥有80亿活跃参数和2.8万亿总参数,在内部评估中超越所有开源模型。该模型比开源最强基座模型DeepSeek-V4-Pro-Base预训练FLOPs效率高出4-12倍,并用于训练更大模型。微软通过全栈控制,使用有机数据预训练,计划通过Foundry授权模型权重。